
 32
视频出海不用再来回切工具了:讯飞译制一站搞定字幕、翻译和AI配音(副本)
DeepSeek正式开源其首个实验性多模态模型V4-Flash-Vision-Exp,拥有305B参数,该模型为语言模型装上视觉‘眼睛’,旨在构建能看能执行的多模态Agent。它在保持与V4-Flash相近文本与编程能力的同时,新增图像理解、OCR、图表分析等功能,多模态Agent能力已接近Claude Opus 4.8,并以MIT协议开源,为开发者提供了强大的视觉Agent开发基础。
2026/09/020
UIED COLLECTION
专题内容聚合
第 3 页
32DeepSeek正式开源其首个实验性多模态模型V4-Flash-Vision-Exp,拥有305B参数,该模型为语言模型装上视觉‘眼睛’,旨在构建能看能执行的多模态Agent。它在保持与V4-Flash相近文本与编程能力的同时,新增图像理解、OCR、图表分析等功能,多模态Agent能力已接近Claude Opus 4.8,并以MIT协议开源,为开发者提供了强大的视觉Agent开发基础。
 66
讯飞译制整合语音识别、多语翻译、AI配音于一体,将视频出海本地化流程从多个工具切换简化为一站式操作,支持17种语言识别与16种语言翻译,显著提升短视频、短剧及课程等内容的多语言版本制作效率。
 71
 69
 62
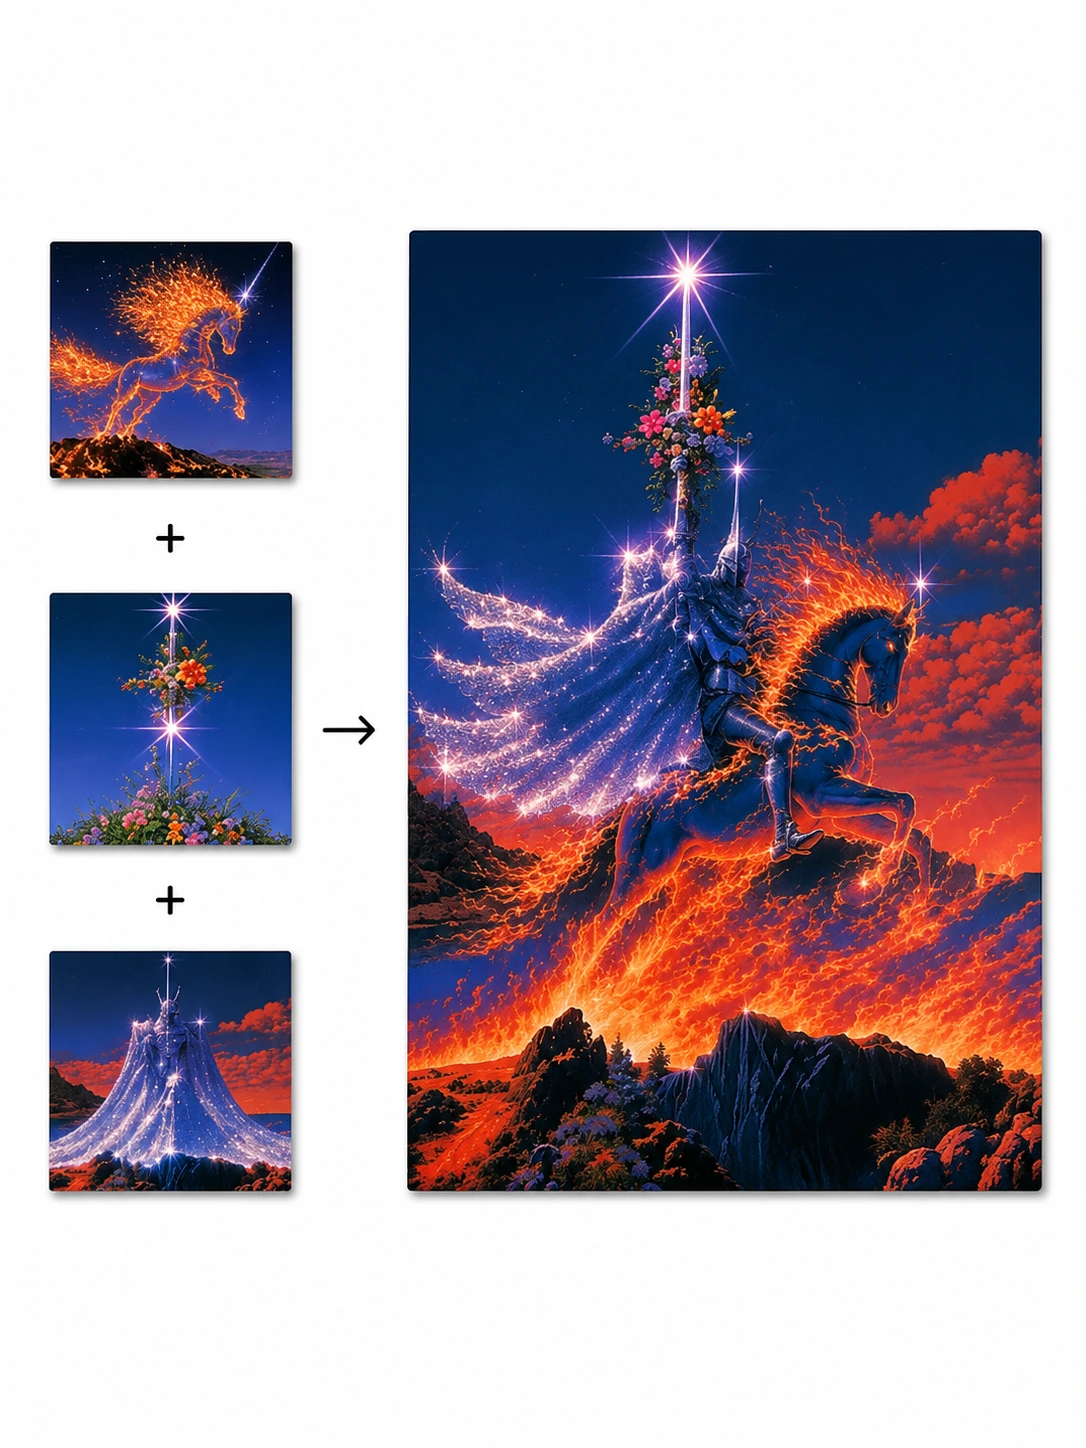
Midjourney 这次更新,重点已经不只是: “再生成一张新图。” 而是开始认真解决另一件事: “已经有了一张图,怎么继续把它改对。” 官方最新上线的 V8.2 图像编辑模型,正式把 Midjourney 的工作流从单纯生图,推进到: 生成 + 编辑 + 局部修改 + 多图参考 + 画布扩展 一整套更完整的创作流程。 对于经常做海报、封面、电商图、角色设
 59
腾讯新一代旗舰大模型 Hy4 preview ,这次不只是上线: 权重也直接开源了。 8 月 28 日,腾讯混元正式发布 Hy4 preview。 核心规格非常猛: 770B 总参数 49B 激活参数 1M 上下文 而且腾讯给它的定位不是普通聊天模型,而是: 为真实生产力任务而生。 重点直接放在: 软件工程、复杂办公、游戏开发、科学研究。 一、从 295B
 78
智谱AI正式开源GLM-5.3-Flash模型,该模型拥有320B总参数和1M上下文窗口,采用混合注意力架构实现高效推理。作为原生多模态模型,它在保持前沿智能的同时,通过首发折扣将价格降至同级模型的约1/40,旨在推动AI应用更广泛落地。
 7533
ZCode 本周末开启免费额度活动,所有用户均可领取3亿Token,用于体验GLM-5.3-Flash多模态模型。活动从周五持续至下周一,新老用户及订阅用户均可参与,需升级至最新版本客户端。名额有限,先到先得,额度到期未用自动失效。
 152
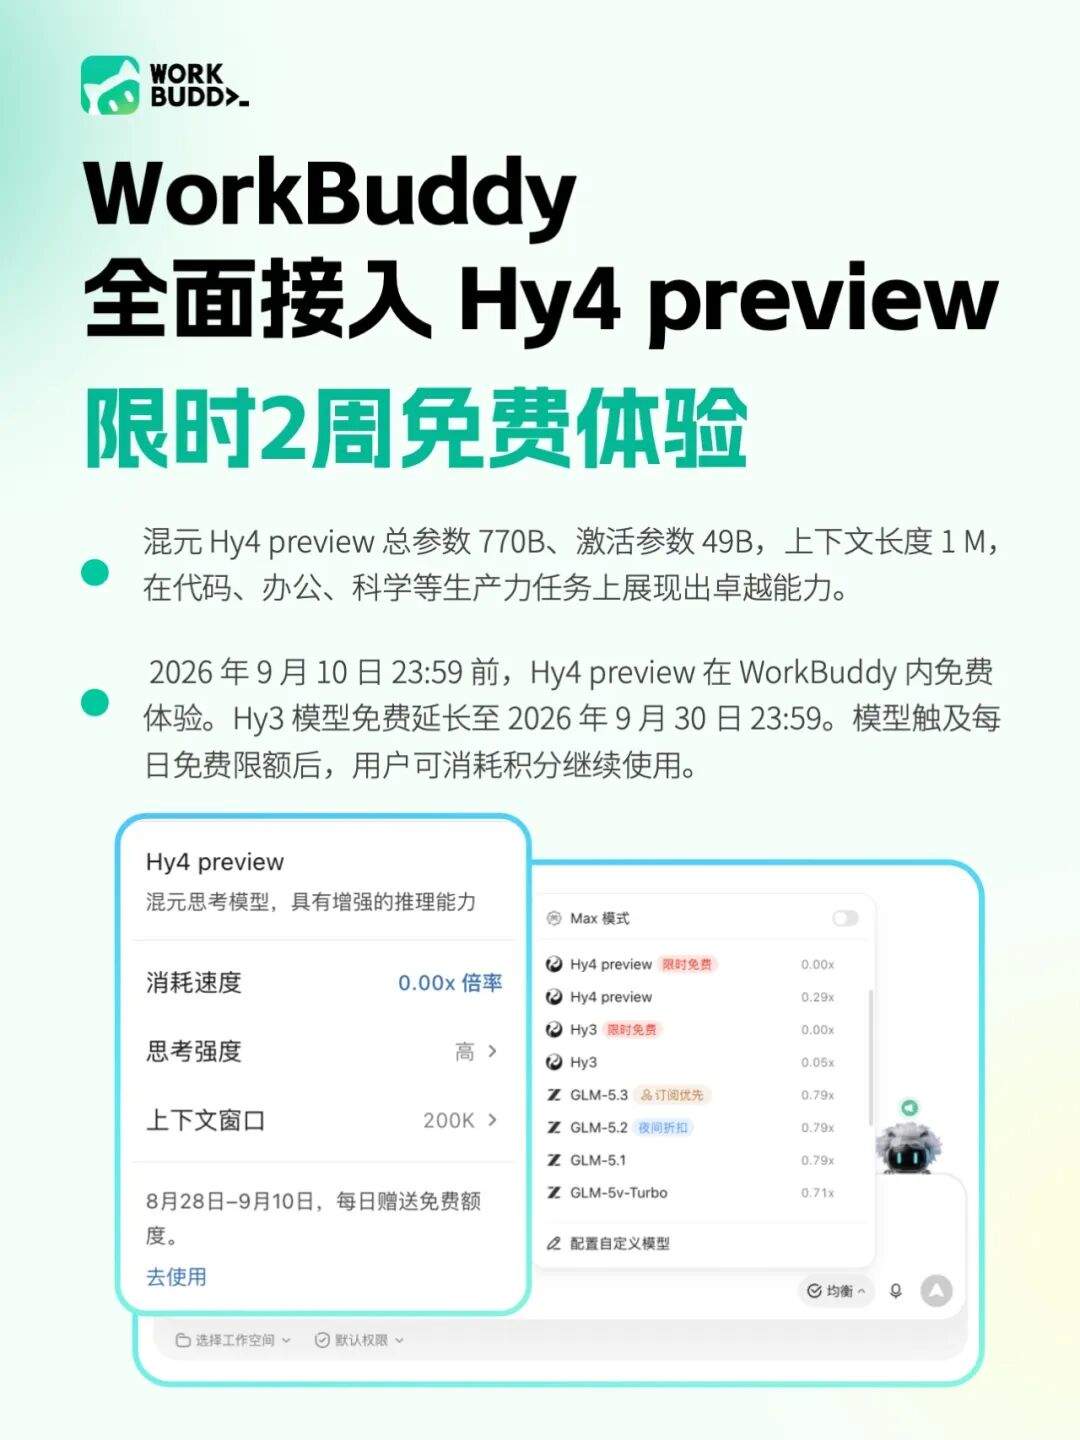
腾讯新一代混元模型 Hy4 preview ,终于来了。 8 月 28 日,腾讯正式上线 Hy4 preview,并同步接入 WorkBuddy 国内版和国际版 。 这次模型规模相比 Hy3 明显提升: 总参数 770B 激活参数 49B 上下文长度 1M 而且定位也非常明确: 为生产力而生。 相比单纯追求聊天和知识问答,Hy4 preview 这次把重点放
 42
Agent 现在越来越能干,但一个现实问题也越来越明显: 太烧 Token 了。 做一次聊天可能只需要几千 Token。 但真正让 Agent 去: 查资料、读文件、规划任务、调用工具、修改内容、反复检查…… 一次复杂任务很容易把 Token 消耗拉到普通聊天的数倍甚至数十倍。 千问办公这次干脆从底层换了一套“省油发动机”。 8 月 26 日晚,千问办公首发
 94
今天,我们上线并开源GLM-5.3-Flash (320B-A18B),这是GLM-5系列的首个 原生多模态模型 。 大家好像已经习惯将前沿智能与前沿价格绑定,并认为这是技术进步必须支付的成本。今天,GLM-5.3-Flash来了:320B总参数,能力超过GLM-5.2,在全球权...
 66
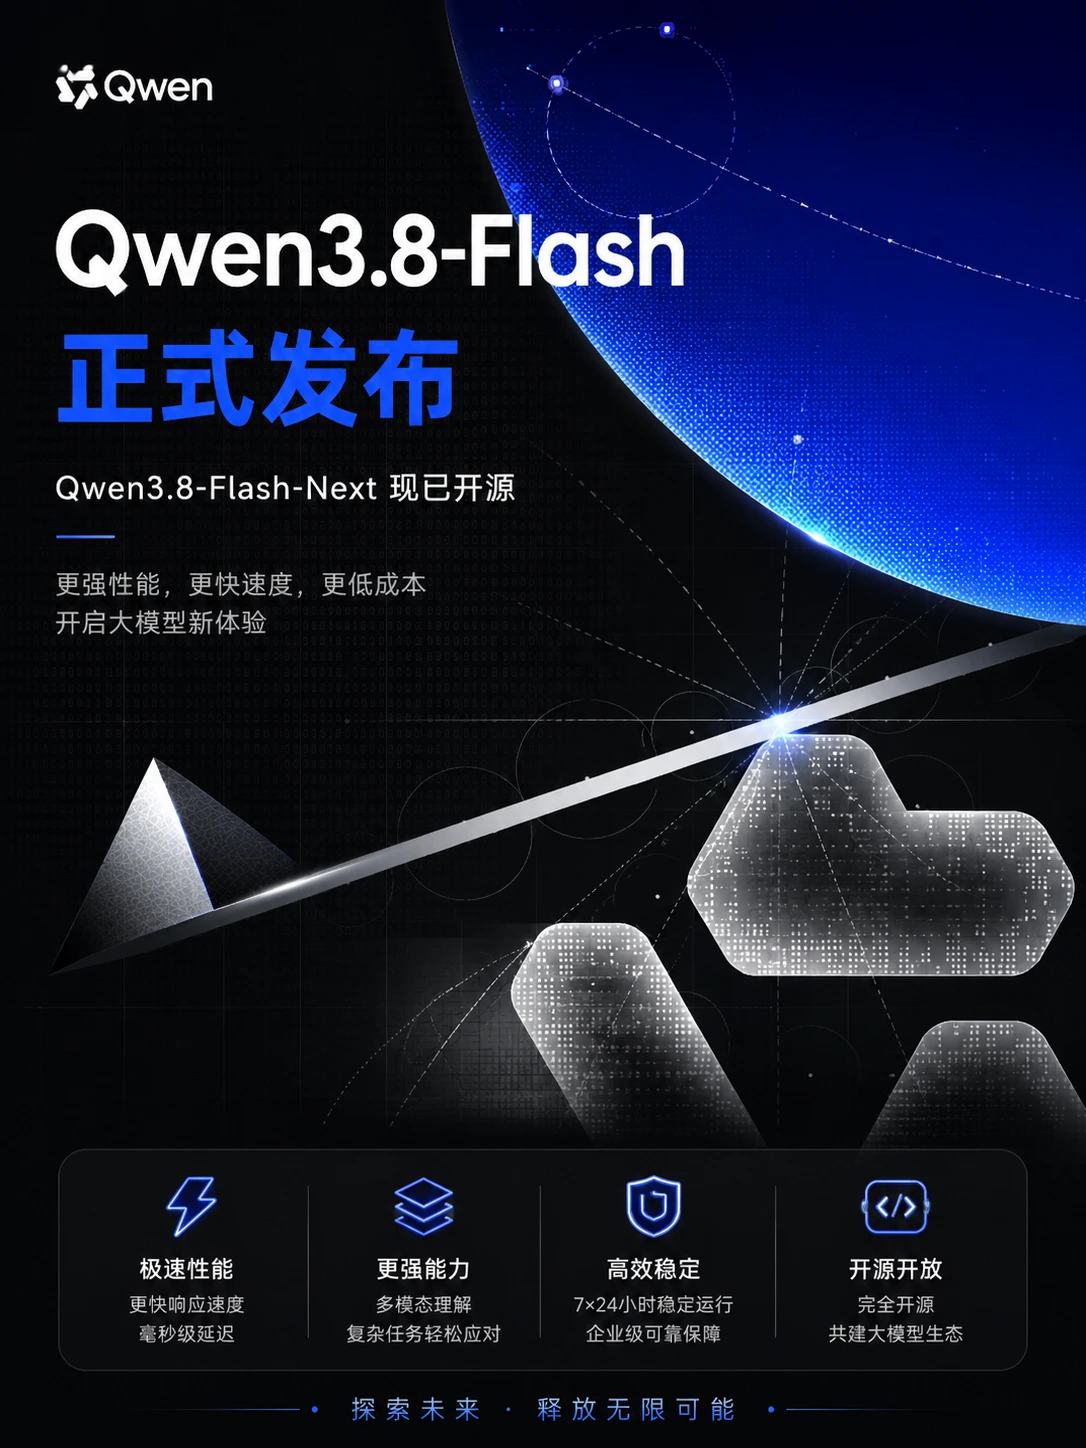
Qwen3.8-Flash是一款采用全新架构的多模态MoE模型,拥有125B主参数和51B N-gram Embedding,每token激活6B参数。它原生支持262K上下文,可通过YaRN扩展至1M。该模型通过GDN+QSA混合注意力、门控残差连接等创新技术,显著提升了计算效率与训练稳定性,同时大幅降低了训练与推理成本。
 49
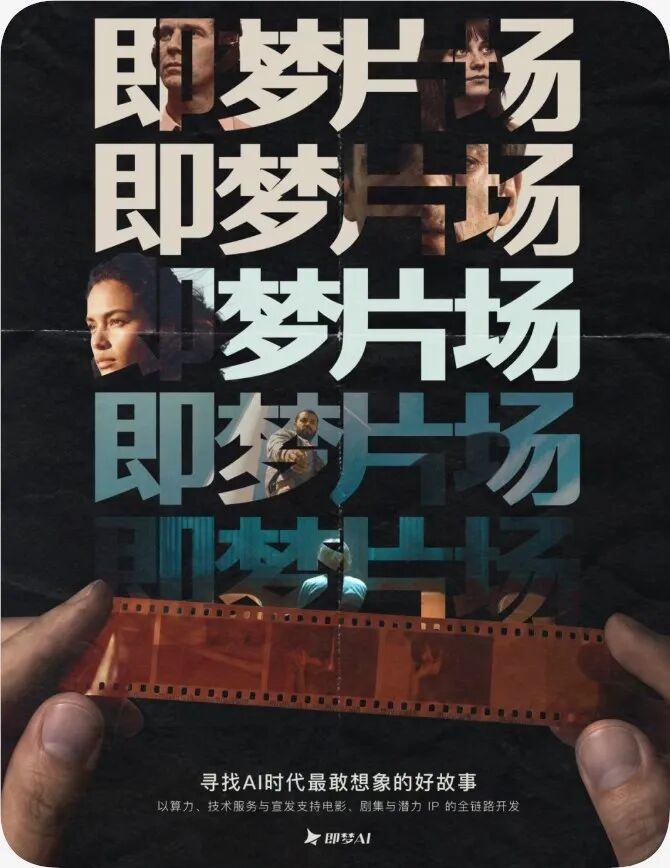
AI 视频这两年最大的变化,不只是: 画质越来越高。 而是大家已经开始不满足于做一个: 5 秒镜头; 15 秒短片; 30 秒广告。 越来越多 AI 创作者开始尝试: 真正拍电影、做剧集。 现在即梦直接往这个方向推了一把。 即梦AI正式推出影视内容厂牌: 「即梦片场」 而且这次不是普通的创作比赛。 它开始真正面向: 电影 + 剧集 两类长篇 AI 影视项目提
 59
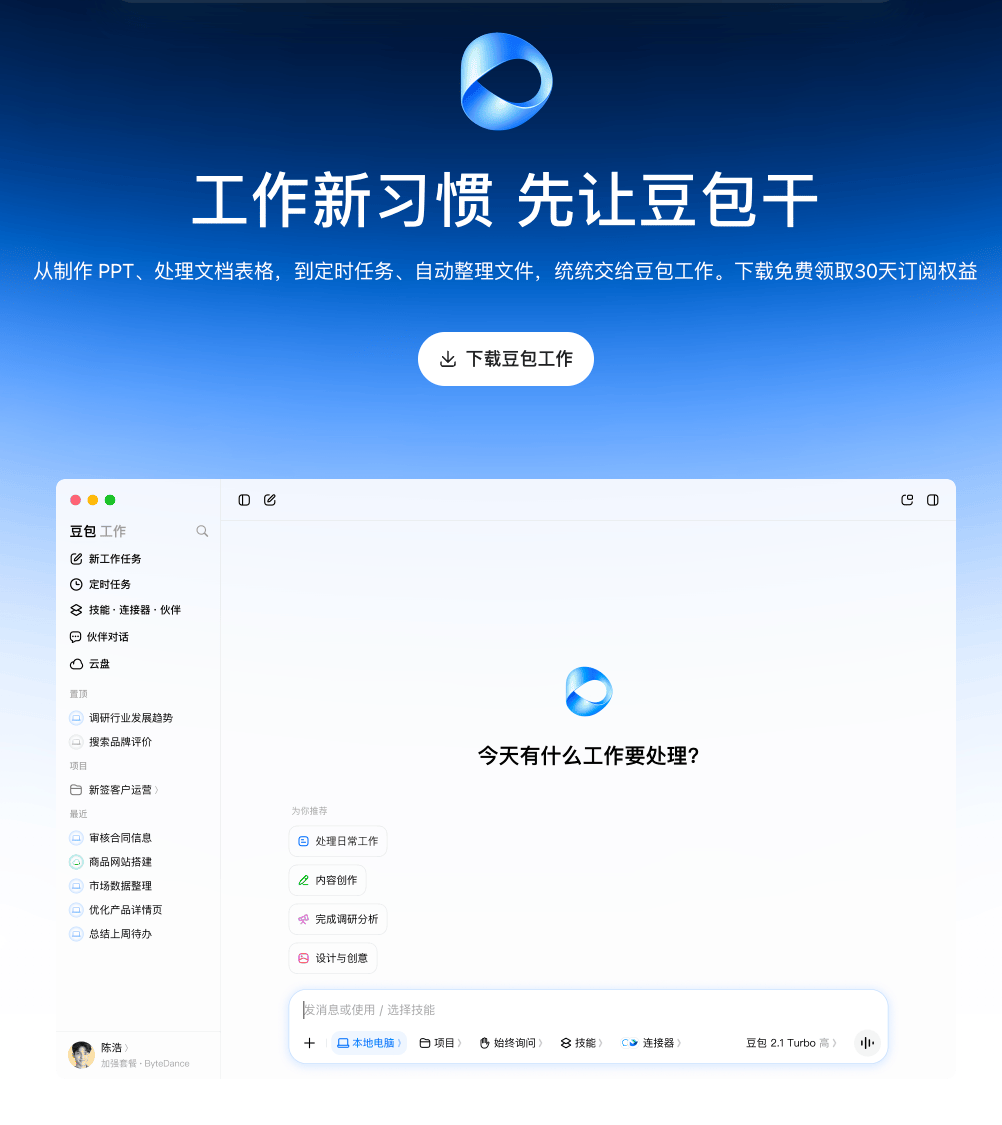
字节跳动正式推出AI办公助手“豆包工作”,旨在提升企业效率。该平台深度融合飞书生态,为企业提供智能文档处理、高效协同等AI能力,是企业级大模型应用的重要落地。
 110
现在 AI 设计工具越来越多,但真正做一个完整项目时,最大的问题反而是: 工具太散了。 生图用一个。 做视频换一个。 PPT 再开一个。 网页视觉又得重新找工具。 素材、参考图和不同版本最后散落在各种聊天记录和文件夹里。 Lovart 中文版 想解决的就是这个问题。 它把: 图片、视频、动效、网页、PPT、灵感采集、Skill 和画布编辑 全部放到了同一个
 242
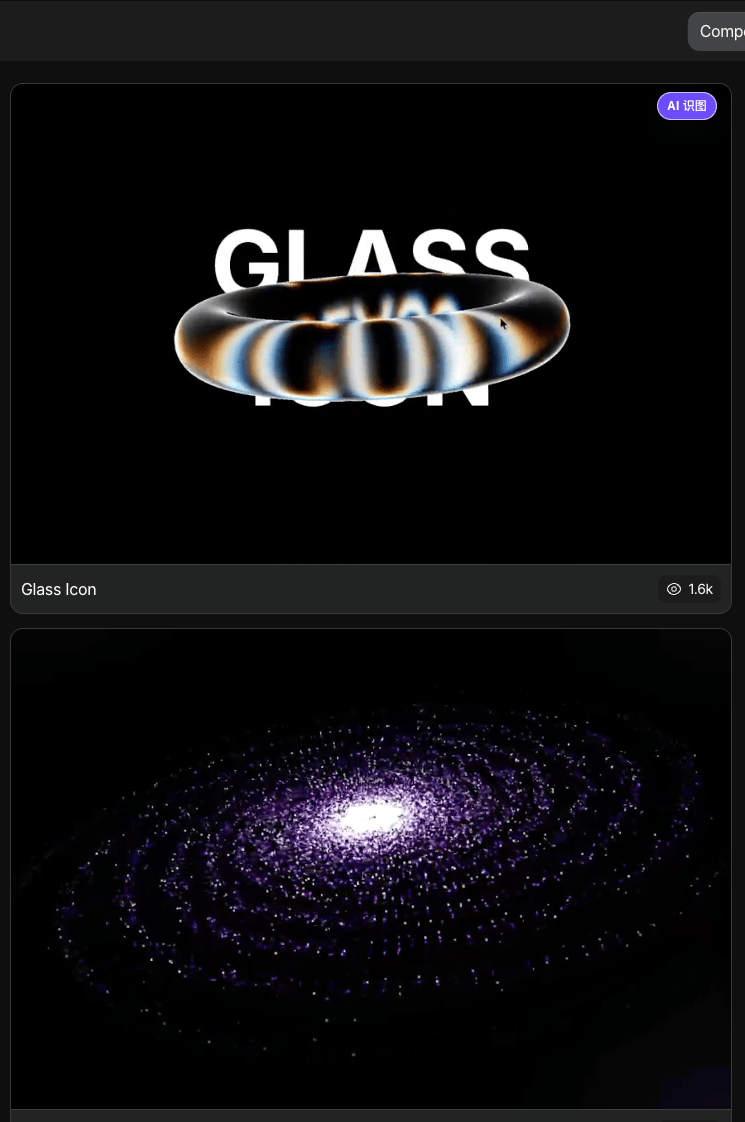
本文分享了8个专为Vibe Coding和AI前端开发设计的UI/动效网站,教你如何将现成的优质代码直接喂给Agent,快速提升页面的设计感和交互体验,告别单调的AI模板,大幅提升开发效率。
 193
阿里万相Wan3.0正式上线,单次最长可生成30秒高清视频,支持图文音视频及PPT、PDF等多种文档作为创作素材。模型增强跨镜头一致性,整合文生、图生等多种功能,并直接生成有声视频,为短剧、广告、电商等内容创作提供高效AI引擎。
 52
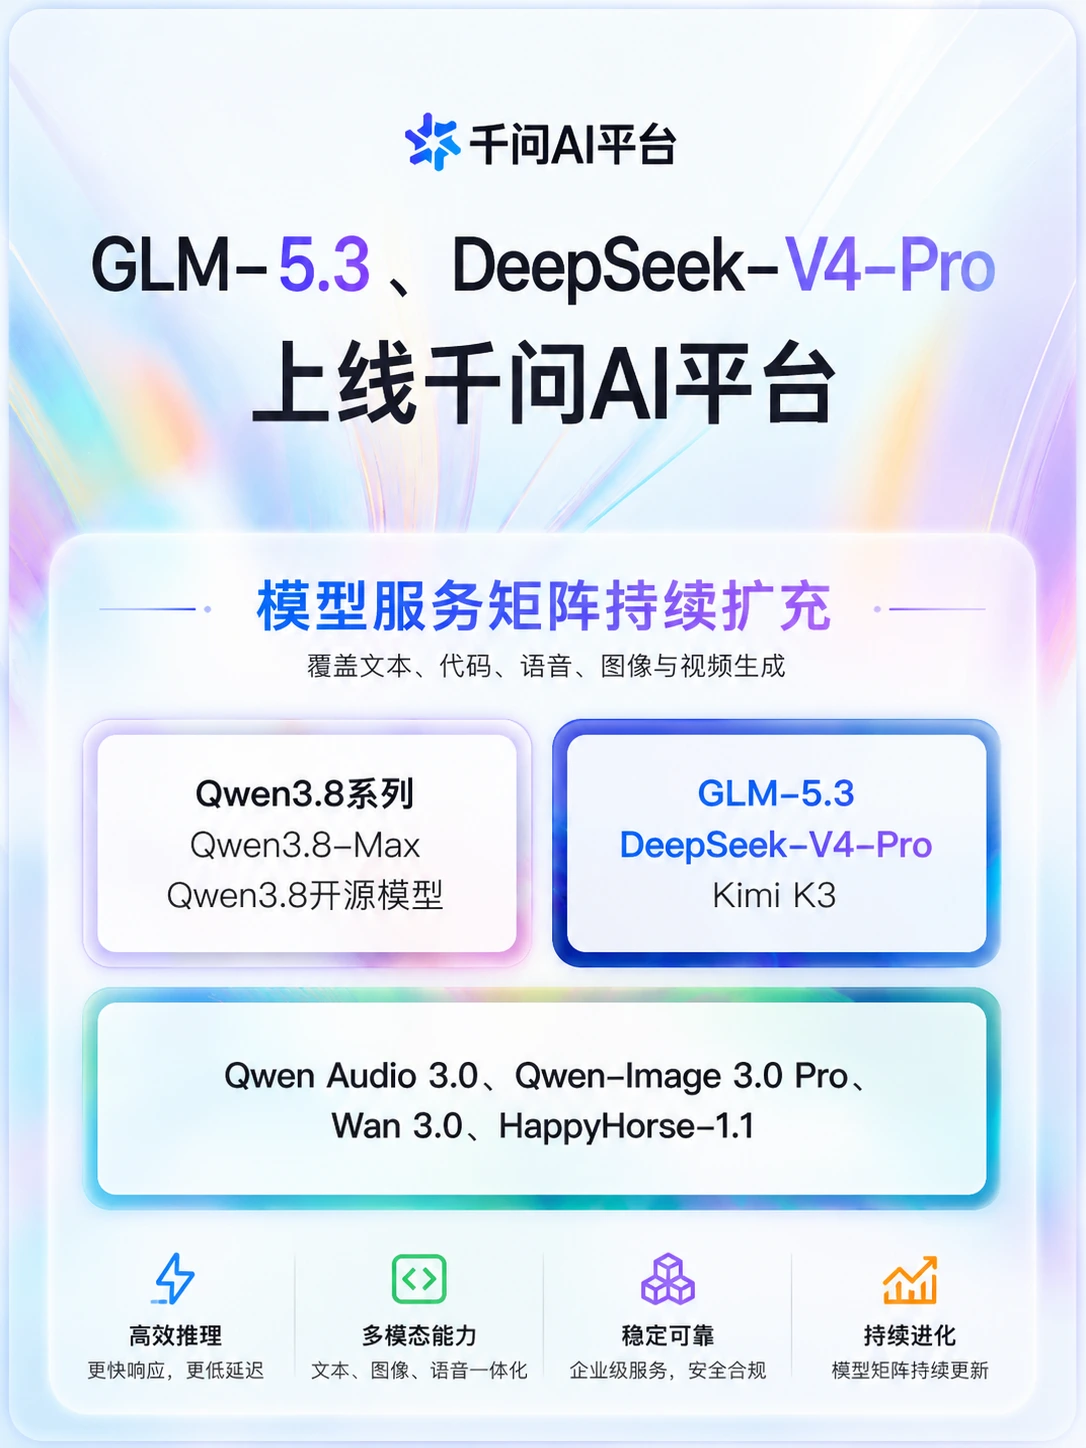
千问AI平台最近又补了两位重量级选手: GLM-5.3 以及: DeepSeek V4 Pro。 这次说的不是前面的“千问办公”,而是面向开发者和企业的: 千问AI平台。 也就是说,你不一定非得自己分别注册智谱、DeepSeek,再维护不同 API。 现在通过千问AI平台,就可以在同一套开发环境中选择不同厂商的大模型。 而随着 GLM-5.3、DeepSee