
Vidu S2 来了:AI 视频开始“边播边改”,人物换衣、换人、换背景都能实时完成


…
AI 视频现在已经不只是在卷:
生成得像不像。
生数科技最新发布的:
Vidu S2
开始解决另一个问题:
视频正在播放的时候,AI 能不能直接改?
答案已经开始变成:
可以。
Vidu S2 这次主要包含两款模型:
Vidu S2-Avatar
以及:
Vidu S2-Editing。
前者负责:
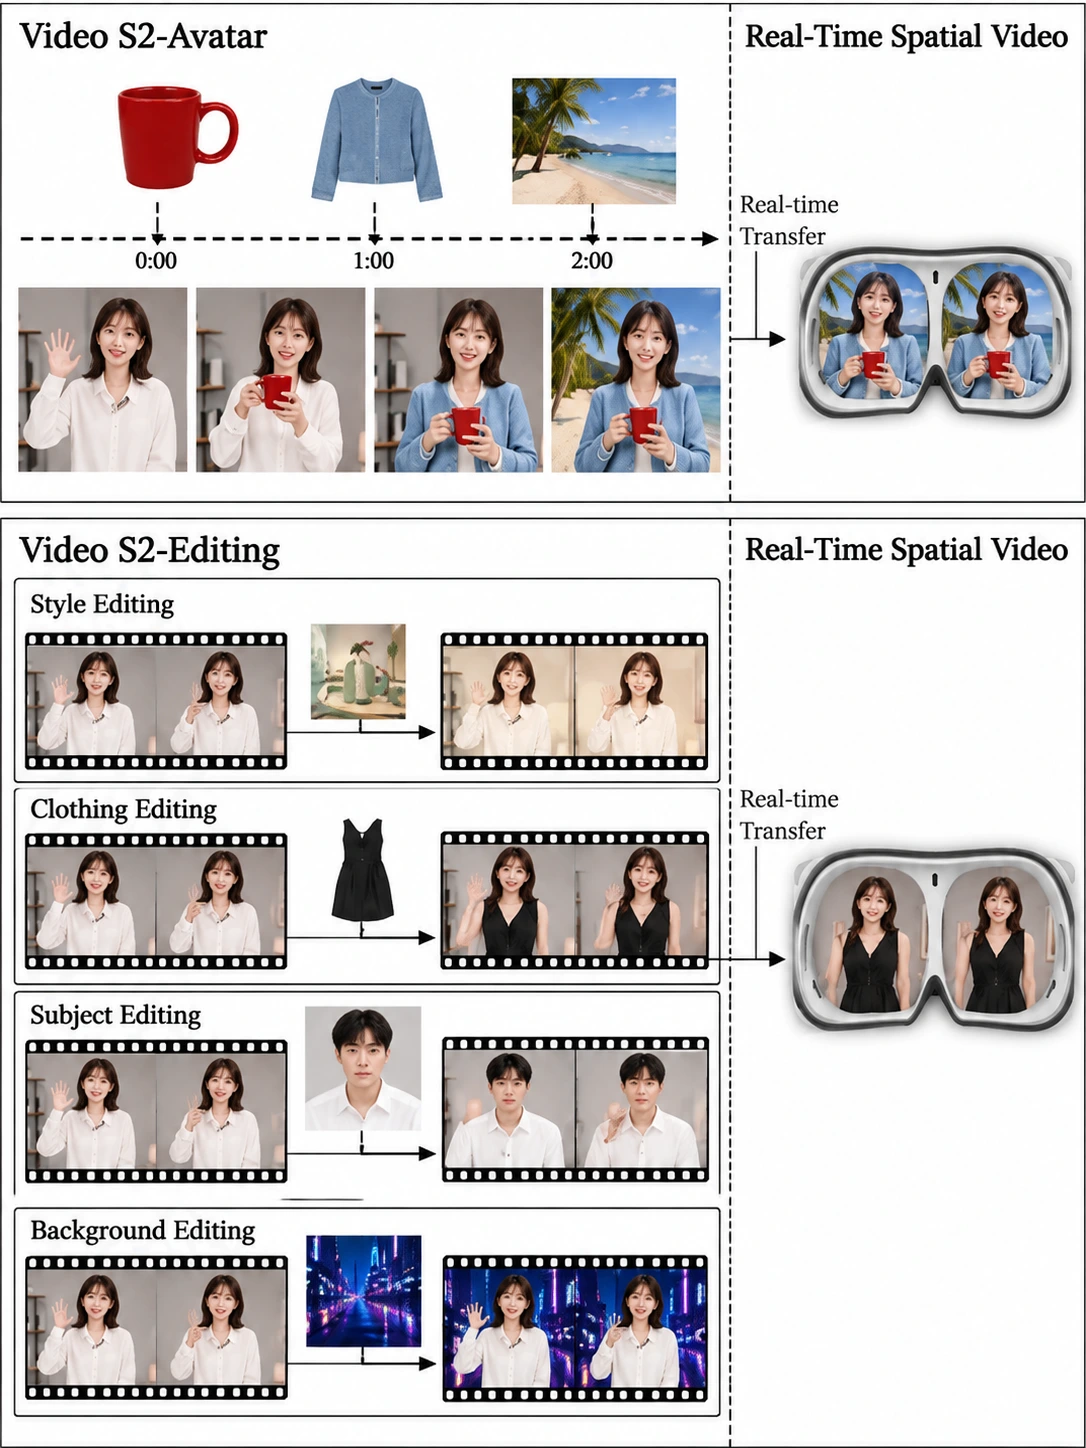
实时生成可以交流、可以做动作的数字角色。
后者更直接:
对正在输入的视频流实时修改。
换衣服。
换人物。
换背景。
甚至整个画面风格都可以继续变化。
AI 视频开始从:
“生成一个文件”
继续走向:
“持续运行的视频世界”。
一、先看 S2-Avatar:数字人终于不是“提前录好再播”
Vidu S2-Avatar 面向的是:
实时交互数字角色。
它支持:
实时语音互动;
复杂动作控制;
参考图驱动;
人物与物体互动。
比如用户正在和数字人对话。
直接说:
跳个舞。
角色可以继续根据指令完成动作。
或者对话进行到一半:
突然传进去一张衣服参考图。
再告诉它:
换成这套衣服。
角色不需要重新创建一个全新视频任务。
而是可以继续在当前交互过程中:
更新视觉状态。
二、最有意思的是“动态参考图”
这次相比 Vidu S1 一个很明显的变化就是:
Dynamic Reference。
传统参考生视频通常是:
生成以前先把参考图全部准备好。
然后开始生成。
一旦视频运行:
参考条件基本固定。
Vidu S2-Avatar 则允许在运行过程中:
继续加入或者更新参考图。
比如直播中的数字人正在介绍商品。
你临时传一张:
包包图片。
它可以继续:
拿起对应商品进行展示。
再传一套衣服:
可以更换穿搭。
再传一个背景:
场景继续跟着变化。
这就让参考图从:
生成前的条件
变成:
实时交互指令的一部分。
三、画质也从540P提高到720P
Vidu S2-Avatar 的实时输出能力这次进一步提升到:
720P。
这点对于实时数字人很重要。
离线生成视频:
慢一点没太大关系。
但是实时数字人需要同时兼顾:
画质;
延迟;
动作;
语音;
持续生成。
任何一块太慢:
互动体验都会马上崩掉。
所以真正难的并不是:
生成一张好看的数字人图片。
而是:
持续几十分钟甚至更久,都能保持一个可以交流的角色。
四、S2-Editing 更狠:直接改“视频流”
如果说 Avatar 还是:
AI 生成角色。
那么:
Vidu S2-Editing
更像是一个实时 AI 视频处理层。
它持续接收:
正在输入的视频流。
然后一边接收:
一边编辑;
一边输出。
不是:
上传视频
↓
等模型生成
↓
下载结果
而是:
输入视频流
↓
Vidu S2实时处理
↓
输出新视频流
真正开始进入:
Streaming Video Generation。
五、目前主要支持四种实时编辑
S2-Editing 当前重点开放四类能力:
1. 实时风格迁移
输入一张目标风格参考图。
正在直播的视频可以持续变成:
动漫;
插画;
电影;
其他视觉风格。
而人物动作和镜头节奏继续保留。
2. 虚拟试穿
上传服装参考图。
模型实时把直播人物身上的衣服:
替换成目标服装。
这对于:
电商直播;
虚拟试衣;
服装展示
非常直接。
3. 人物替换
输入一个新的角色参考图。
模型可以把原视频里的人物:
实时替换。
同时尽量保持原本:
动作;
表情;
时间关系。
4. 背景替换
直接把人物身后的环境:
替换成参考场景。
而且依然是:
视频流持续运行。
六、编辑过程中还可以继续换参考图
这点其实非常关键。
S2-Editing 并不是:
开流以前把参数写死。
在视频运行过程中,可以继续切换:
参考图;
编辑类型;
视觉场景。
例如直播前半段:
使用风格迁移。
过一会儿:
切到虚拟换衣。
再过一会:
换背景。
整个视频流不需要因此重新启动。
也就是说:
AI 编辑开始越来越像传统直播软件里的:
实时滤镜和特效层。
只是这个“滤镜”已经可以理解:
人物;
衣服;
场景;
视觉风格。
七、以后直播间甚至可能不需要真实布景
这个能力如果真正规模化应用,我觉得电商直播会非常有意思。
现在搭一个直播间需要:
灯光;
背景;
服装;
场景;
商品;
设备。
未来可能变成:
一个真人;
一台摄像机;
再加一个生成模型。
主播站在普通背景前。
系统实时生成:
巴黎街头;
海边;
雪山;
豪宅;
产品发布会现场。
衣服也不一定真的一套一套换。
直接:
实时生成。
甚至主播本人都可以:
替换成品牌虚拟角色。
这样看,Vidu S2-Editing 其实已经不是传统意义上的:
AI 视频生成器。
更接近:
实时生成式视频引擎。
八、数字人也开始从“会说话”变成“会表演”
早期数字人基本就是:
一张脸。
嘴巴动。
说话。
现在 Vidu S2-Avatar 已经继续加入:
复杂动作;
语音控制;
商品互动;
换衣;
背景变化。
例如:
让角色跳舞。
或者:
拿起一个参考商品进行介绍。
数字人开始从:
Talking Head
继续往:
Interactive Character
走。
这对:
游戏 NPC;
AI 陪伴;
虚拟偶像;
在线教育;
电商主播
其实比单纯提高口型准确度更重要。
九、再往前一步,就是VR里的“生成世界”
这次 Vidu S2 还有一个更前沿的方向:
Spatial Video。
生数科技正在探索:
将 S2-Avatar 和 S2-Editing 放进:
VR 头显
环境中。
传统视频是:
固定一个平面。
用户看哪里:
画面本身都不会发生变化。
但空间视频需要模型理解:
头部运动;
观察视角;
空间关系。
当用户:
转头;
靠近;
移动视角
以后,
模型需要继续生成:
与新视角匹配的画面。
如果角色也存在其中:
角色的位置、外观和动作还得继续保持一致。
十、不过“头显适配”目前还是探索能力
这里需要区分一下。
Vidu S2 官方论文确实已经展示:
实时空间视频生成与编辑
的可行性探索。
但它目前更接近:
研究成果 + 技术展示。
不是说现在买一个 VR 头显:
安装 Vidu,
就已经可以稳定生成无限空间世界。
所以现阶段更准确的说法应该是:
生数科技正在探索 Vidu S2 面向 VR 头显的空间视频应用。
真正规模化商用:
还需要继续观察。
十一、S系列和Q系列的路线也越来越清楚了
现在 Vidu 的模型体系其实开始明显分成两条线。
Vidu Q 系列
重点是:
高质量视频生成;
参考生视频;
文生视频;
图生视频;
长视频;
多主体一致性。
适合:
影视;
广告;
短剧;
创意内容。
Vidu S 系列
重点则是:
实时。
包括:
实时数字人;
实时互动;
实时视频编辑;
流式生成。
适合:
直播;
AI陪伴;
游戏NPC;
在线教育;
电商;
实时交互。
一个负责:
把视频做好。
一个负责:
让视频活起来。
十二、AI视频下一阶段可能不只是“生成”
这也是 Vidu S2 最值得关注的一点。
过去 AI 视频的典型工作流是:
输入Prompt
↓
等待
↓
得到MP4
生成完成以后:
任务基本结束。
但实时模型的逻辑变成:
持续输入
+
用户指令
+
视频流
+
参考图
↓
模型不断计算
↓
持续输出
视频不再是最终结果。
而变成:
一直运行的界面。
这会打开很多以前纯视频模型很难做的产品。
例如:
AI NPC;
互动影视;
AI直播;
虚拟试衣;
视频客服;
实时陪伴;
沉浸式VR。
结语
Vidu S2 这次可以记住两款模型。
Vidu S2-Avatar
支持:
720P实时数字人。
实时语音互动。
复杂动作控制。
动态参考图。
商品互动。
实时换衣和背景变化。
Vidu S2-Editing
则可以直接持续编辑:
输入视频流。
目前覆盖:
风格迁移。
虚拟试穿。
人物替换。
背景替换。
并且在视频运行过程中:
参考图和编辑场景还可以继续改变。
至于 VR 头显:
目前已经开始探索:
实时空间视频生成和编辑。
但这部分暂时更适合看作:
下一阶段技术方向。
以前 AI 视频竞争的是:
谁生成得更好。
现在开始出现另一条路线:
谁能够实时生成。
甚至:
一边播放,一边生成,一边修改。
当视频从一个 MP4 文件,
变成一个可以不断响应用户的实时界面,
AI 视频这件事:
可能才刚刚开始变得真正有意思。
相关链接
Vidu S2 官方介绍
https://platform.vidu.cn/docs/vidu-s2
Vidu S2 模型地图
https://platform.vidu.com/docs/model-map
Vidu S2-Avatar 开发文档
https://platform.vidu.cn/vidu-stream/doc/s2-avatar/realtime/quick-start
Vidu S2-Editing 开发文档
https://platform.vidu.cn/vidu-stream/doc/s2-editing/introduction
Vidu S2-Editing 快速开始
https://platform.vidu.cn/vidu-stream/doc/s2-editing/quick-start
Vidu S2 论文
https://arxiv.org/abs/2609.11638
Vidu 官网
Vidu API 开放平台
标签




评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。