
Qwen3.8-Omni-Flash:从理解到交付,释放全模态Agent生产力


今天,新一代原生全模态模型 Qwen3.8-Omni-Flash正式上线。该模型的核心目标是提升其在真实生产力场景中的 Agent 能力,推动全模态模型从“理解全模态内容”进一步走向“规划任务、调用工具并完成创作”。在具备编程、文本知识工作和 GUI 操作等通用 Agentic 能力的基础上,Qwen3.8-Omni-Flash 进一步拓展了以音视频为核心的 Agentic 应用,在视频剪辑、音乐视频创作、影视制作与解说、音视频转图文摘要和音视频对话等,需要综合处理文本、图像、音频与视频的工作流中取得了显著效果。
图 1:Qwen3.8-Omni-Flash 与其在生产环境中的应用
支持文本、图像、音频和视频输入,以及 1M 长上下文
Qwen3.8-Omni-Flash现已上线千问AI平台:
https://www.qianwenai.com/models/qwen3.8-omni-flash
Qwen3.8-Omni-Flash 支持 1M 长序列,在保持与同尺寸文本模型相当的文本能力的同时,全模态能力显著提升。
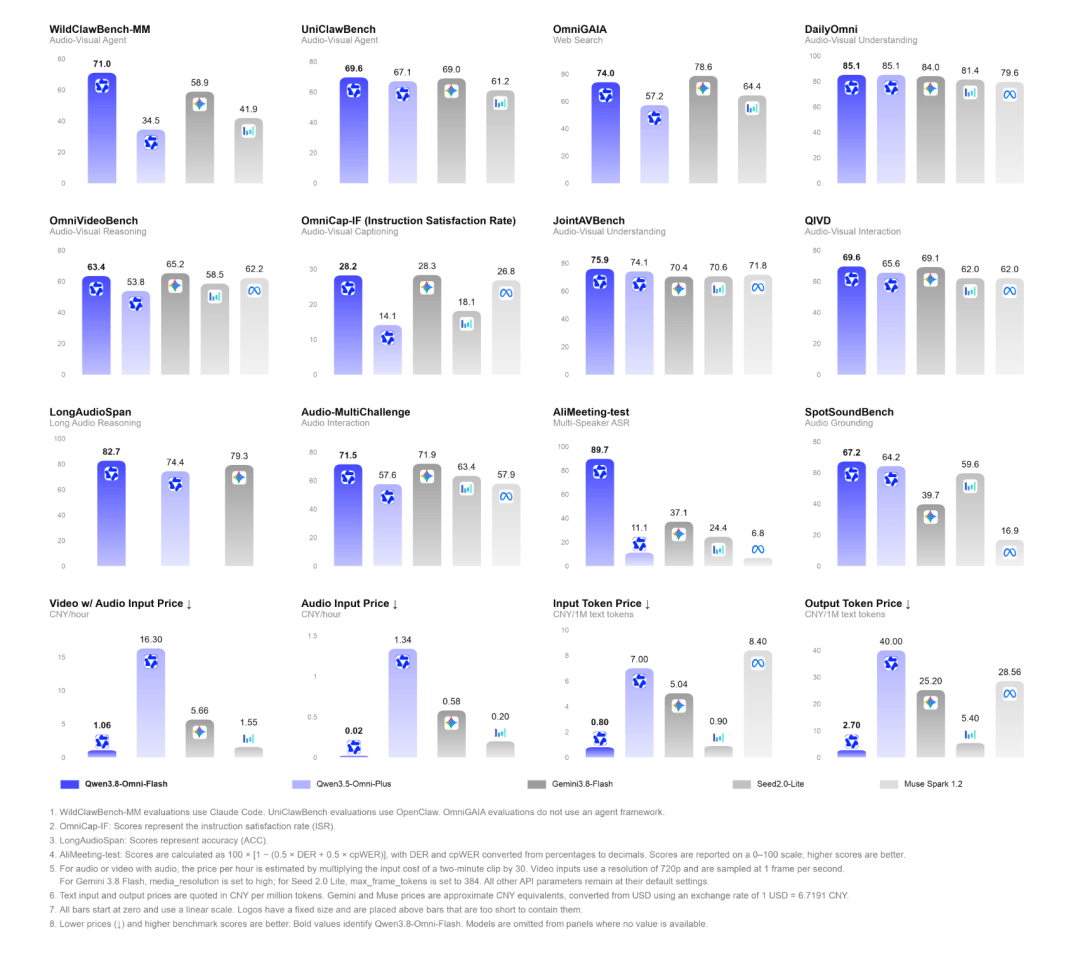
在累计 30 项评测上,相比上一代 Qwen3.5-Omni-Plus,平均得分提升超过26%。
在音视频 Agent、Coding 和长程任务方面,模型在 WildClawBench-MM 上大幅提升36.5分,在 AgenticVBench 上提升22.3分,并在 UniClawBench 上取得 69.6的高分。
基础能力方面,模型在长音频/音视频理解、音视频推理、音视频 Caption 和多说话人识别上均有明显提升:例如,LongAudioSpan 提升8.3分,OmniVideoBench 提升 9.6 分,OmniCap-IF 的 CSR / ISR 分别提升 8.5 / 14.1 分,AliMeeting 的 DER / cpWER 从 88.11 / 89.61 降至 3.35 / 17.18。
通过扩展数据、上下文与 Agentic Environment,Qwen3.8-Omni-Flash 的音视频能力接近 Gemini 3.8 Flash,音频能力整体超过 Gemini 3.8 Flash。
这些能力的进一步提升,也意味着音视频正在从模型的感知输入,进一步成为 Agent 理解环境、开展推理并执行任务的核心载体。
同时,Qwen3.8-Omni-Flash的API 每小时音频输入价格降幅超过98%,每小时音视频输入价格降幅超过93%。
音视频是 Agent 走向真实生产力场景的重要载体,但也带来了一组新的系统挑战:长音视频的文件存储、网络传输与多轮推理成本高昂,现有 Agent Harness 框架缺乏对音视频的原生支持,而从全模态理解到端到端任务执行的工作范式仍处于早期阶段。解决这些问题,需要模型、Harness 工具与运行环境协同演进。
围绕这些挑战,我们在 Qwen3.8-Omni-Flash 上探索了如何贯穿素材理解、任务规划、工具执行与结果交付的完整链路,完成视频剪辑、翻译、电影解说和内容创作等端到端长程工作流,推动 Omni 从理解音视频进一步走向自主行动与任务交付。
为此,我们进一步扩展了 Qwen-MM-Plugins,为长音视频的按需感知、工具调用与工作流执行提供支持;同时开源 Qwen-Live Harness,为实时、持续的全模态交互提供原生运行环境。两者分别面向长程工作流与实时交互,并在与模型的共同迭代中持续拓展全模态 Agent 的能力边界。
- Qwen-MM-Plugins:
- https://github.com/QwenLM/Qwen-MM-Plugins
- Qwen-Live Harness(Coming Soon):
- https://github.com/QwenLM/Qwen-Live-Harness




评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。