
京东也开始“造世界”了:EchoWM 开源,AI 视频一口气生成 10 分钟以上


…
AI 视频,还在卷:
5 秒。
10 秒。
30 秒。
60 秒。
京东这次直接把时间轴继续往后拉了。
在 JDD 2026 上,京东探索研究院集中展示 JoyAI-Echo 系列最新进展:
JoyAI-Echo 1.5
以及:
EchoWM。
前者解决的是:
视频能不能一直生成。
后者解决的则更有意思:
生成出来的世界,能不能真的进去探索。
JoyAI-Echo 1.5 已经展示:
10 分钟以上的连续音视频生成。
而 EchoWM 更进一步:
用户改变方向、移动镜头以后,AI 会继续生成后面的世界。
连:
环境声;
音乐;
人物语音
都会跟着场景一起变化。
AI 视频开始从:
“给我生成一段片子”
走向:
“给我生成一个可以进去的世界”。
一、先把 AI 视频从几十秒拉到 10 分钟
现在绝大多数视频模型最擅长的仍然是:
短 Clip。
问题在于:
视频一旦变长,
人物容易变脸;
衣服容易变化;
声音容易漂;
场景关系开始混乱;
故事也越来越接不上。
JoyAI-Echo 1.5 做的核心事情就是:
跨镜头记忆。
它通过可组合的音视频 Memory Bank,让模型在后续镜头生成时继续参考:
人物外观;
历史画面;
声音特征;
角色关系;
故事信息。
所以即使进入新的镜头:
模型依然尽量记得:
这个人是谁。
他说话是什么声音。
刚才发生了什么。
二、10分钟不是把同一个镜头硬拉长
这里容易理解错。
JoyAI-Echo 1.5 的“10分钟以上”更接近:
多镜头长叙事。
而不是:
让一个扩散模型死撑 10 分钟不停生成同一镜头。
它可以围绕一个故事持续:
规划;
切换镜头;
保留角色;
延续情节;
维护声音。
整个流程更像:
故事需求
↓
剧情展开
↓
分镜规划
↓
逐镜生成
↓
跨镜头记忆
↓
质量审核
↓
继续生成
↓
最终成片
真正要解决的是:
Story-level Consistency。
也就是:
故事级一致性。
三、Director Agent 甚至开始负责“导演”
这一版还有一个很 Agent 的能力:
Director Agent。
用户不一定要自己把十分钟内容拆成几十条 Prompt。
可以直接给:
故事设定;
角色;
主题;
风格。
Director Agent 再继续完成:
故事扩展;
分镜规划;
镜头生成;
结果检查;
成片组装。
这其实意味着视频 Agent 的形态也开始变化。
以前:
AI 是摄影机。
你告诉它:
“生成这个镜头。”
现在开始变成:
AI 是一个小型制作组。
用户给创意目标。
剩下的工作进一步自动化。
四、生成速度最高提高到7.5倍
长视频最大的问题除了稳定性:
还有一个字:
贵。
十分钟视频如果按照传统扩散方式一帧一帧慢慢跑:
成本和时间都会非常夸张。
JoyAI-Echo 系列通过后训练和少步生成,将推理速度最高提升:
7.5 倍。
公开展示中:
使用 2 张 H200
在 480P 分辨率下,
平均可以做到约:
24 FPS。
也就是接近:
1:1 等时生成。
简单理解:
一分钟视频,
理论生成时间开始接近一分钟量级。
当然,实际速度仍然会受到:
配置;
镜头复杂度;
生成参数
等因素影响。
但对于长视频来说,这个方向非常关键。
五、但 EchoWM 才是这次真正有意思的东西
如果说 JoyAI-Echo 1.5 还是:
AI帮你拍电影。
EchoWM 做的就是:
AI直接给你造一个世界。
EchoWM 全称:
Echo World Model。
官方定义是一款:
可进入的全模态世界模型。
它不是预先把整个世界全部建好。
而是:
你往前走,
模型继续生成前面的内容。
你往左转,
它生成左边的世界。
你调整视角,
画面继续变化。
这有点像:
实时生成的游戏。
六、最特别的是:这个世界有声音
很多世界模型目前主要关注:
视觉。
你操作角色向前走。
模型生成新的画面。
但现实世界并不是静音的。
EchoWM 把:
视频;
环境音;
音乐;
语音
直接放进同一个生成过程。
例如你从:
室外走进酒吧。
画面会从街道变成室内。
与此同时:
街道环境声减弱;
室内音乐变强;
附近人的声音开始出现。
你再走远:
声音又继续变化。
也就是说:
声音不是后期贴上去的。
而是跟世界状态一起生成。
这也是 EchoWM 和不少纯视觉 World Model 很不一样的一块。
七、第一人称、第三人称都能控制
EchoWM 把不同操作统一成:
6-DoF Camera Trajectory。
也就是六自由度相机轨迹。
第一人称里:
控制的就是观察者移动。
例如:
前进;
后退;
左右移动;
抬头;
低头;
旋转。
第三人称则更加复杂。
因为模型不仅需要理解:
摄像机怎么走。
还要理解:
角色如何与摄像机保持合理关系。
例如:
角色继续向前跑,
镜头在侧后方跟随。
模型需要同时维持:
角色动作;
环境;
视角;
空间关系。
这已经不是传统:
Image-to-Video。
更接近:
Action-to-World。
八、支持连续多轮探索,而不是操作一下就结束
世界模型真正难的地方是:
滚雪球误差。
第一步:
还挺正常。
走十步:
空间开始漂。
走一百步:
整个世界可能已经崩掉。
EchoWM 因此重点研究:
Long-Horizon Rollout。
通过因果生成、缓存、轨迹控制和长程训练,让世界可以连续往后发展。
JoyAI-Echo 1.5 论文中报告,世界模型版本在 WBench 上取得:
81.7 的平均分。
并在多项世界模型评测中取得领先结果。
不过需要注意:
这些仍然属于研究 Benchmark。
并不意味着现在的公开模型已经可以像成熟 3A 游戏一样无限稳定运行。
九、开源版本已经可以自己跑
EchoWM 目前已经开放:
代码
以及:
模型权重。
公开仓库已经提供:
Echo-WM Base;
Echo-WM Flash Preview。
用户可以输入:
首帧图片;
Prompt;
动作指令。
然后控制:
W / S 前后;
A / D 左右;
视角俯仰;
视角旋转。
系统会生成对应:
视频 + 音频。
甚至官方已经提供:
Gradio Web Demo。
可以本地启动一个交互界面进行测试。
十、不过开源版目前还有一个重要限制
这点我觉得必须说清楚。
虽然 EchoWM 的研究展示强调:
长程、持续交互。
但目前公开的 Echo-WM Base 主要是:
约10秒级生成。
Echo-WM Flash 当前也是:
Preview。
官方已经明确表示:
更长 Horizon 的 Flash 版本还会继续发布。
所以目前更准确的理解是:
核心架构、代码和短时程模型已经开源。
长时间流式探索:
还在继续完善。
另外当前仓库许可主要面向:
学术研究和非商业用途。
如果准备直接用于商业产品:
需要额外注意许可证要求。
十一、为什么“视听世界模型”比视频生成更值得看?
因为视频模型的结果是:
固定的。
Prompt 一提交:
生成什么就是什么。
世界模型则有一个完全不同的变量:
Action。
未来的内容变成:
当前世界状态
+
用户操作
+
模型预测
=
下一刻世界
这意味着每个人进入同一个起点:
后面的结果都可能完全不同。
所以它不仅能用于:
AI视频。
还可能进入:
游戏
VR / AR
数字人
机器人仿真
自动驾驶训练
具身智能
这些场景。
这才是世界模型真正大的想象空间。
十二、世界模型和机器人其实天然是一对
JDD 今年本身的主题就是:
JoyAI · 跃迁物理世界。
因为世界模型还有另一个特别重要的用途:
给机器人练级。
真实机器人训练非常贵。
机器人摔一次:
可能真的坏。
机械臂抓错一次:
可能真的砸东西。
如果能够先在生成世界里:
看;
移动;
操作;
失败;
重新尝试,
模型就可以在进入真实环境之前:
完成大量预训练。
所以京东这次同时展示:
世界模型;
真实数据;
仿真工具;
具身模型,
其实是一条完整链路。
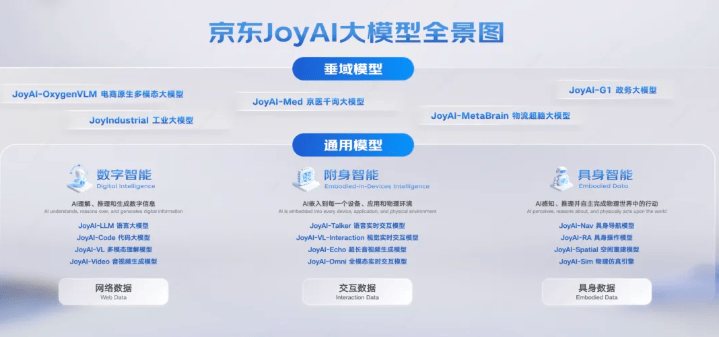
十三、京东把 JoyAI 模型矩阵也摊开了
这次 JDD 上,京东展示的并不只有 Echo。
整个 JoyAI 基础模型体系已经开始覆盖:
图像生成
视频生成
音视频生成
多模态理解
智能语音
世界模型
具身智能
等方向。
整个路线已经比较明显:
过去 AI 主要处理:
文字和数字世界。
下一阶段开始进入:
声音、视频、空间和物理世界。
EchoWM 正好处在这个连接点。
结语
京东这次 JoyAI-Echo 系列可以记住两个关键词:
JoyAI-Echo 1.5
解决:
“AI视频能不能真正变长。”
目前已经展示:
10分钟以上多镜头音视频生成。
拥有:
跨镜头视觉记忆;
声音身份记忆;
Director Agent;
最高7.5倍推理加速。
EchoWM
解决:
“AI生成的世界能不能真正进去。”
它可以围绕用户操作:
持续生成画面;
环境音;
音乐;
语音。
支持:
第一人称;
第三人称;
6DoF控制;
连续多轮探索。
而且:
已经开放代码和模型权重。
以前我们说:
AI 能生成一张图。
后来:
AI 能生成一段视频。
再往后可能真的会变成:
AI 给你生成一个世界。
你不是站在外面看。
而是:
直接进去。
这可能才是 EchoWM 最值得关注的地方。
相关链接
JoyAI-Echo GitHub
https://github.com/jd-opensource/JoyAI-Echo
EchoWM 开源代码
https://github.com/jd-opensource/JoyAI-Echo/tree/main/echo_wm
JoyAI-Echo 1.5 长视频项目
https://github.com/jd-opensource/JoyAI-Echo/tree/main/echo_longvideo
JoyAI-Echo 1.5 论文
https://arxiv.org/abs/2608.23383
EchoWM 论文
https://arxiv.org/abs/2608.23189
JoyAI-Echo 项目主页
https://echo-team-joy-future-academy-jd.github.io/




评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。