
 2167
科大讯飞星火 X2.5 正式发布:293B-A30B MoE,代码与 Agent 能力重点升级
科大讯飞发布星火X2.5大模型,采用293B-A30B的MoE架构,重点升级代码与智能体能力。旗舰模型支持256K上下文,基于国产算力训练。同时,开源的4B/1.7B端侧模型支持百万Token上下文,实现了从云端到边缘的全面覆盖。
2026/09/070
UIED COLLECTION
专题内容聚合
第 4 页
2167科大讯飞发布星火X2.5大模型,采用293B-A30B的MoE架构,重点升级代码与智能体能力。旗舰模型支持256K上下文,基于国产算力训练。同时,开源的4B/1.7B端侧模型支持百万Token上下文,实现了从云端到边缘的全面覆盖。
 638
微软发布MAI-Image-2.6-Flash模型,生图速度提升至GPT-Image-2-Medium的2.8倍,效率提升72%,且输出成本降低50%。该模型支持多图参考、动态宽高比及1.5K分辨率,旨在满足企业高频、大规模、低成本的工业化视觉生产需求,标志着AI生图正式进入实用化竞争阶段。
 517
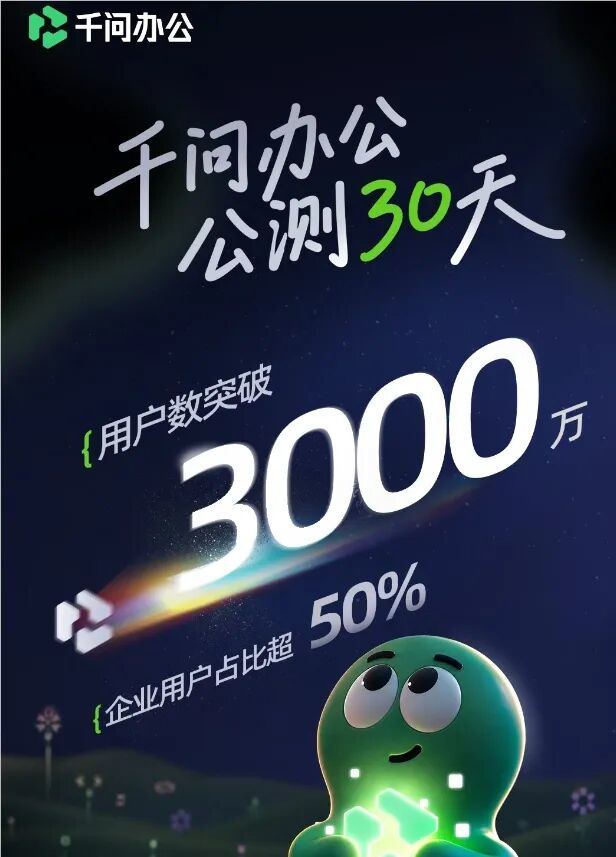
千问办公上线刚满一个月,数据已经有点夸张了: 用户突破3000万。 其中: 超过一半来自企业用户。 从 8 月 3 日正式上线到现在,短短 30 天,千问办公一共完成了: 120 次版本更新。 平均: 一天迭代4次。 累计上线功能超过千项,国际版也已经同步推出。 但如果只看“3000万用户”,其实还没抓到这一个月最关键的变化。 千问办公正在补 Agent 真
 1023
OpenAI 正式发布旗舰模型 GPT-6 Astra,其定位转向执行端到端复杂任务。模型重点强化计算机操作、软件工程与专业办公能力,可理解任务、操作电脑、调用工具并交付成果。Astra 标志着大模型从“聊天机器人”向“数字执行者”的转变,开启了智能体(Agent)高效处理实际工作的新时代。
 3718
夜猫子程序员。 9 月 3 日起,智谱 GLM Coding Plan 正式开启: 「Flash × ZCode」夜间畅蹬活动。 活动一直持续到: 9 月 20 日。 每天晚上: 23:00 到第二天早上: 09:00 只要使用套餐里的: GLM-5.3-Flash 优惠会自动开启。 最狠的是: ZCode 里直接 0 额度消耗。 换句话说,这 10 个小时
 1397
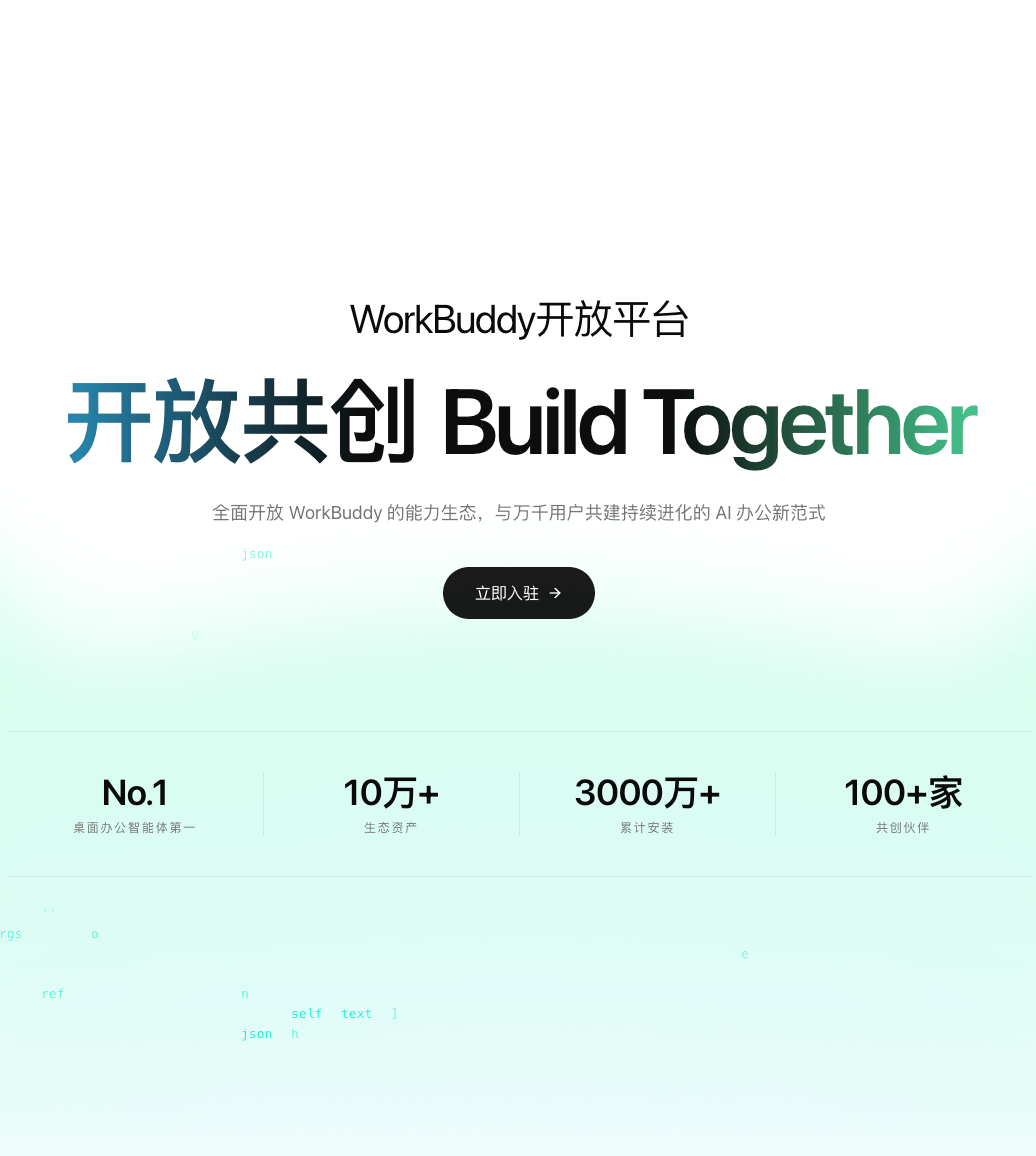
腾讯WorkBuddy正式发布开放平台,首批引入超百家生态伙伴,旨在构建面向Agent时代的操作系统。平台不仅开放API,更开放其完整的Agent工作流基座能力,支持智能硬件、行业应用及开发者接入,让专业工具和硬件都能成为Agent可调用的能力,实现任务驱动的智能协作。
 440
DeepSeek正式开源其首个实验性多模态模型V4-Flash-Vision-Exp,拥有305B参数,该模型为语言模型装上视觉‘眼睛’,旨在构建能看能执行的多模态Agent。它在保持与V4-Flash相近文本与编程能力的同时,新增图像理解、OCR、图表分析等功能,多模态Agent能力已接近Claude Opus 4.8,并以MIT协议开源,为开发者提供了强大的视觉Agent开发基础。
 1089
讯飞译制整合语音识别、多语翻译、AI配音于一体,将视频出海本地化流程从多个工具切换简化为一站式操作,支持17种语言识别与16种语言翻译,显著提升短视频、短剧及课程等内容的多语言版本制作效率。
 924
 1232
 891
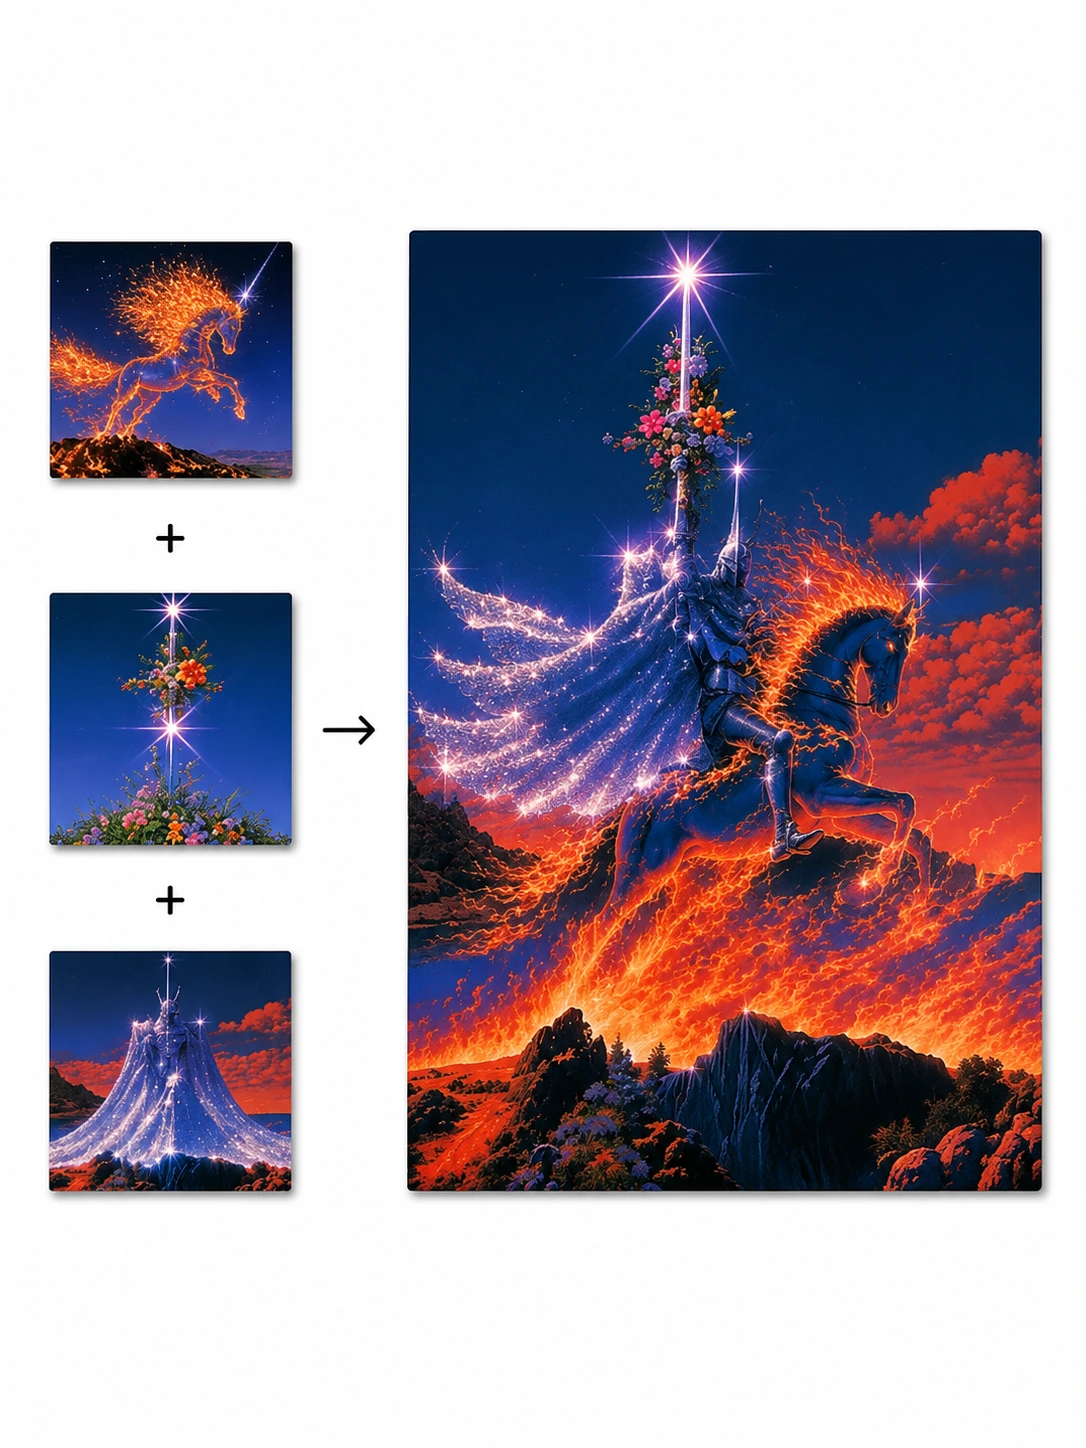
Midjourney 这次更新,重点已经不只是: “再生成一张新图。” 而是开始认真解决另一件事: “已经有了一张图,怎么继续把它改对。” 官方最新上线的 V8.2 图像编辑模型,正式把 Midjourney 的工作流从单纯生图,推进到: 生成 + 编辑 + 局部修改 + 多图参考 + 画布扩展 一整套更完整的创作流程。 对于经常做海报、封面、电商图、角色设
 891
腾讯新一代旗舰大模型 Hy4 preview ,这次不只是上线: 权重也直接开源了。 8 月 28 日,腾讯混元正式发布 Hy4 preview。 核心规格非常猛: 770B 总参数 49B 激活参数 1M 上下文 而且腾讯给它的定位不是普通聊天模型,而是: 为真实生产力任务而生。 重点直接放在: 软件工程、复杂办公、游戏开发、科学研究。 一、从 295B
 1100
智谱AI正式开源GLM-5.3-Flash模型,该模型拥有320B总参数和1M上下文窗口,采用混合注意力架构实现高效推理。作为原生多模态模型,它在保持前沿智能的同时,通过首发折扣将价格降至同级模型的约1/40,旨在推动AI应用更广泛落地。
 95018
ZCode 本周末开启免费额度活动,所有用户均可领取3亿Token,用于体验GLM-5.3-Flash多模态模型。活动从周五持续至下周一,新老用户及订阅用户均可参与,需升级至最新版本客户端。名额有限,先到先得,额度到期未用自动失效。
 2024
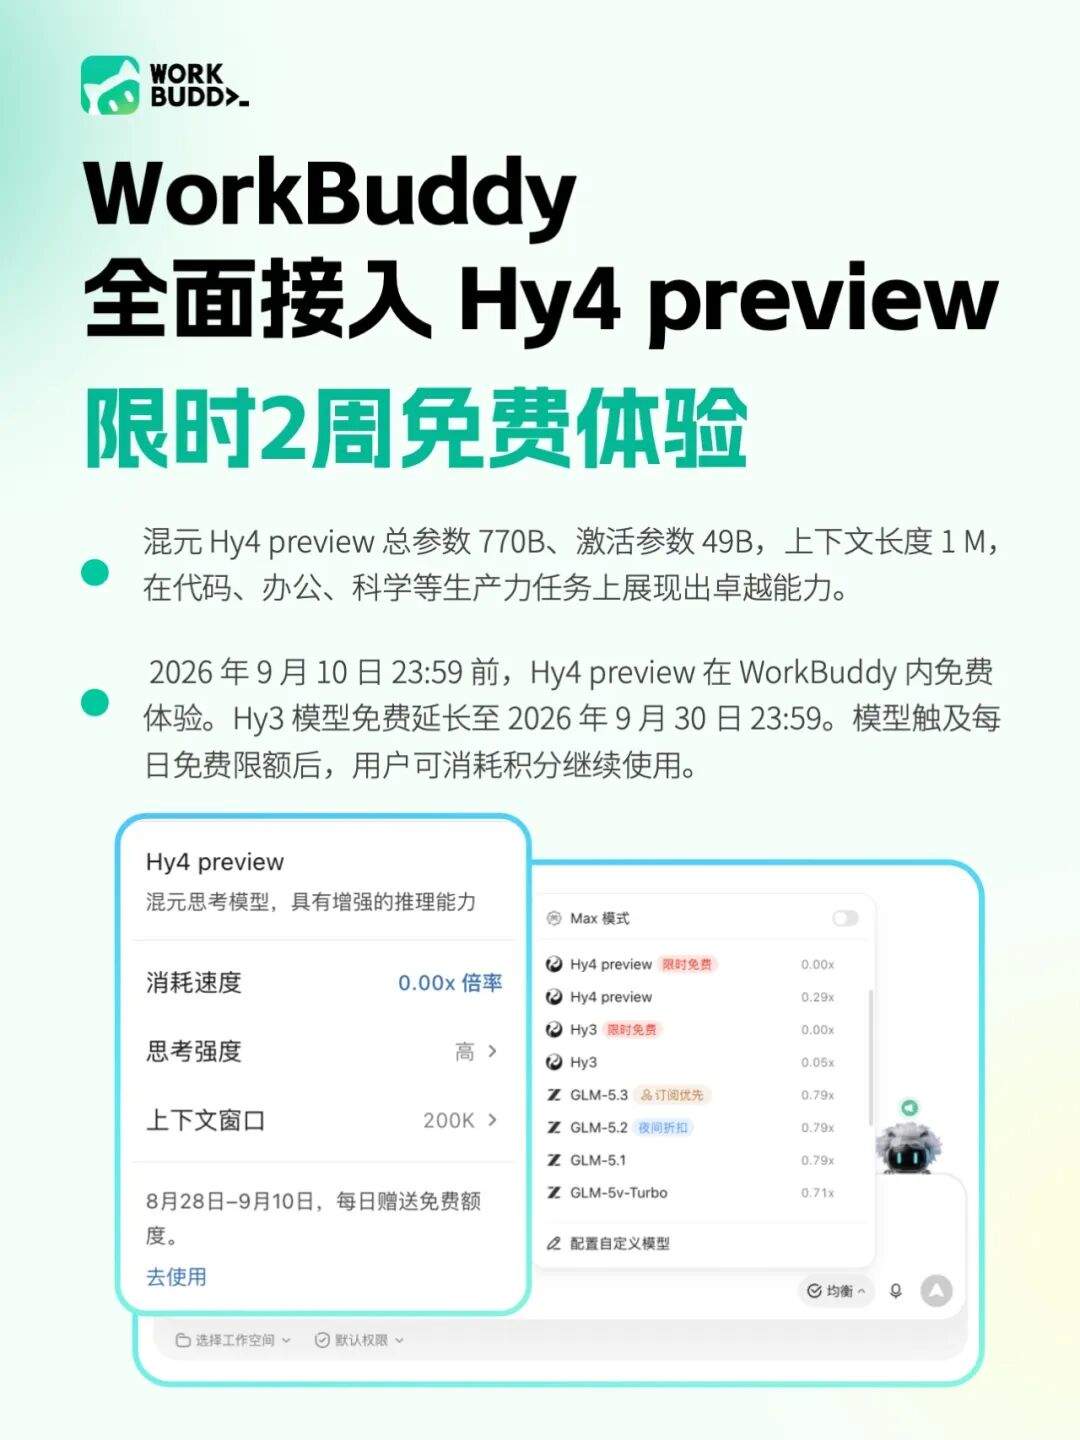
腾讯新一代混元模型 Hy4 preview ,终于来了。 8 月 28 日,腾讯正式上线 Hy4 preview,并同步接入 WorkBuddy 国内版和国际版 。 这次模型规模相比 Hy3 明显提升: 总参数 770B 激活参数 49B 上下文长度 1M 而且定位也非常明确: 为生产力而生。 相比单纯追求聊天和知识问答,Hy4 preview 这次把重点放
 737
Agent 现在越来越能干,但一个现实问题也越来越明显: 太烧 Token 了。 做一次聊天可能只需要几千 Token。 但真正让 Agent 去: 查资料、读文件、规划任务、调用工具、修改内容、反复检查…… 一次复杂任务很容易把 Token 消耗拉到普通聊天的数倍甚至数十倍。 千问办公这次干脆从底层换了一套“省油发动机”。 8 月 26 日晚,千问办公首发
 1287
今天,我们上线并开源GLM-5.3-Flash (320B-A18B),这是GLM-5系列的首个 原生多模态模型 。 大家好像已经习惯将前沿智能与前沿价格绑定,并认为这是技术进步必须支付的成本。今天,GLM-5.3-Flash来了:320B总参数,能力超过GLM-5.2,在全球权...
 1078
Qwen3.8-Flash是一款采用全新架构的多模态MoE模型,拥有125B主参数和51B N-gram Embedding,每token激活6B参数。它原生支持262K上下文,可通过YaRN扩展至1M。该模型通过GDN+QSA混合注意力、门控残差连接等创新技术,显著提升了计算效率与训练稳定性,同时大幅降低了训练与推理成本。