
微信开源 WeKnora:知识库终于不只会回答,开始自己进沙箱“干活”了


…
知识库以前最大的能力是什么?
回答问题。
你上传:
PDF;
Word;
Excel;
公司文档。
然后问:
这份合同什么时候付款?
RAG 找到对应段落。
大模型给你答案。
这套玩法已经非常成熟。
但问题也很明显:
它只会说。
知道这份数据应该怎么算。
但不会真的帮你算。
知道这个 Excel 应该修改。
但不会真的生成一个新文件。
知道项目应该怎么处理。
最后还是得:
人自己动手。
腾讯开源的:
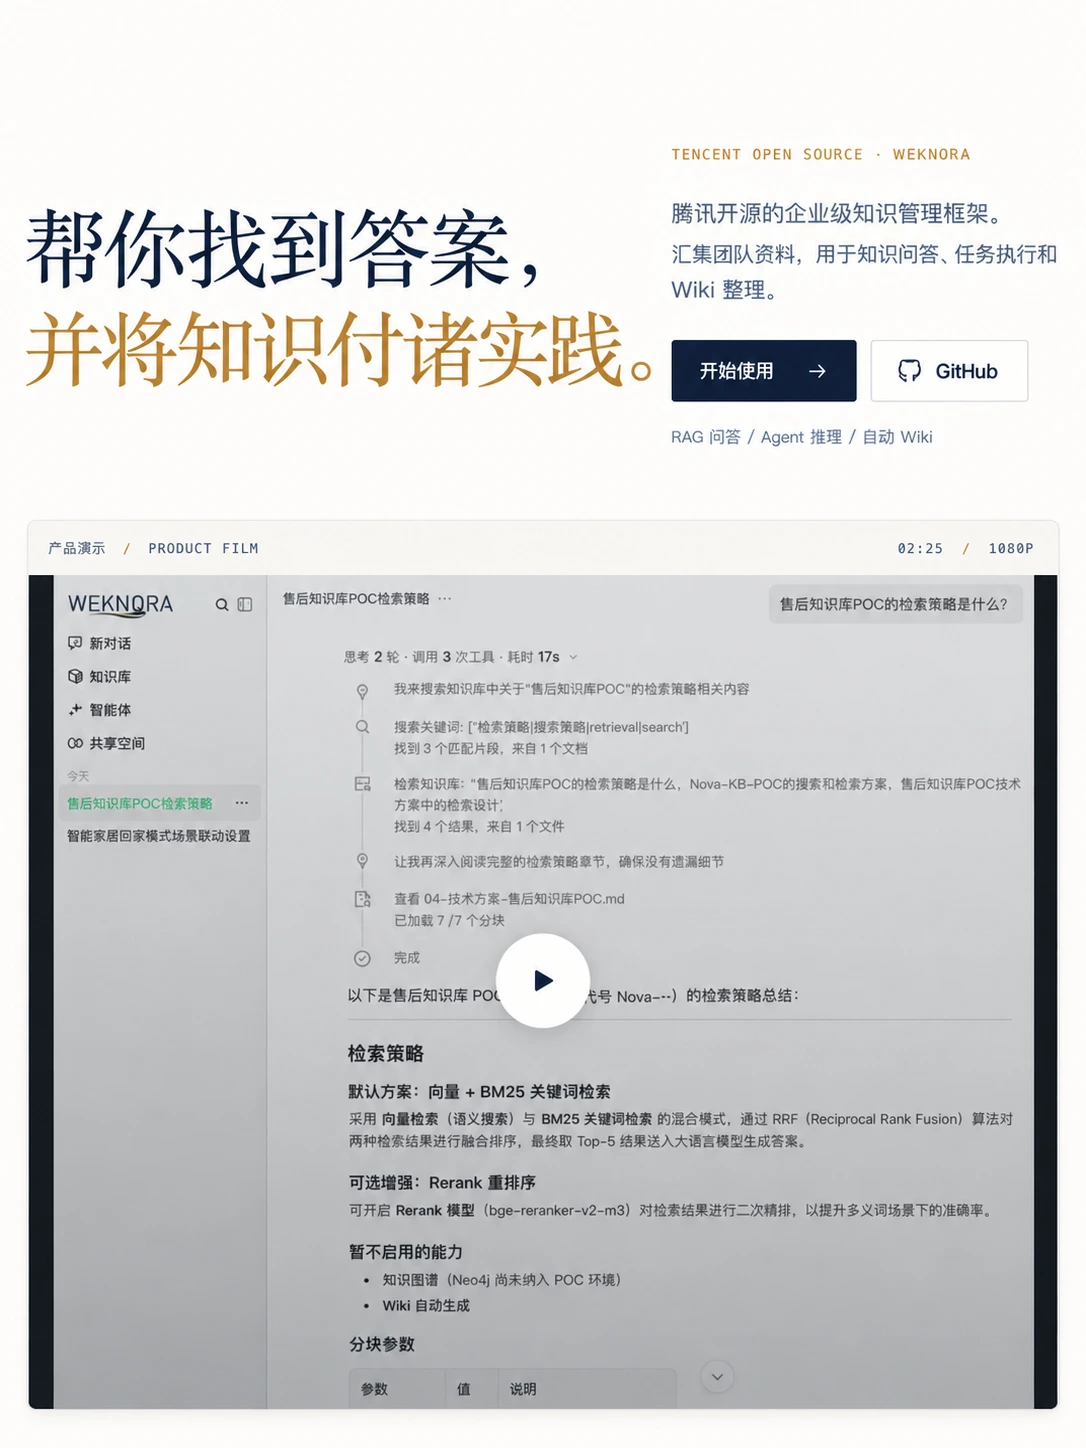
WeKnora
现在开始往前走了一步。
它不只想做:
Knowledge Base。
而是想让知识真正进入:
Agent Runtime。
简单理解就是:
解析知识
↓
组织知识
↓
检索知识
↓
Agent推理
↓
调用Skill
↓
进入Sandbox执行
↓
生成最终结果
知识库开始从:
“告诉你怎么做”
变成:
“自己动手做”。
一、WeKnora 本来就是一套企业级 RAG
WeKnora 中文名:
维娜拉。
它是一套腾讯开源的 LLM 知识管理框架。
目前官方项目主要围绕三个核心能力:
RAG 快速问答
ReAct Agent 推理
以及:
自动 Wiki。
传统用法很直接。
上传:
PDF;
Word;
Excel;
网页;
图片;
知识平台数据。
系统完成:
解析;
分块;
Embedding;
索引;
检索。
然后用户围绕自己的资料直接问问题。
而且回答可以继续:
回溯原始引用。
这已经是传统企业知识库比较完整的一套链路。
二、但它现在已经远远不只是RAG了
WeKnora 最近的路线明显发生了变化。
以前整个链路更像:
文档
↓
解析
↓
向量检索
↓
大模型
↓
回答
现在则变成:
文档
↓
结构化解析
↓
RAG / GraphRAG / Wiki
↓
Agent规划
↓
知识检索
↓
MCP / Skills / Web
↓
Sandbox执行
↓
生成文件
↓
长期记忆
也就是说:
知识库成为Agent的上下文基础设施。
它负责告诉 Agent:
公司有什么资料;
项目以前发生过什么;
数据在哪里;
有哪些规则。
然后 Agent 再继续:
真正行动。
三、anydoc:先把乱七八糟的Office文件吃进去
知识库的第一道坎永远是:
文档解析。
真实企业资料不可能全是:
干干净净的 Markdown。
更多时候是:
Word;
PPT;
Excel;
PDF;
RTF;
CSV;
甚至各种老格式 Office 文件。
WeKnora 现在加入了:
anydoc。
这是一个基于 Rust 的文档转换能力。
在 WeKnora 中可以直接链接到 Go 主进程里执行。
支持包括:
DOC / DOCX;
PPT / PPTX;
XLS / XLSX;
PDF;
CSV;
EPUB;
ODT;
ODS
等格式。
这些文件可以直接转换成:
Markdown结构。
而且不需要每次绕到独立 Python 服务再回来。
对于轻量部署和需要降低解析延迟的场景:
会方便很多。
四、更复杂的文档,则还有完整DocReader
anydoc 不是 WeKnora 唯一的解析器。
整个系统还有专门的:
docreader。
目前可以处理:
25+ 类型内容。
包括:
PDF版面分析;
扫描件OCR;
Office;
网页抓取;
图片内容
等。
因此实际使用时,可以根据资料类型选择:
不同解析链路。
企业知识库很容易遇到:
表格;
扫描PDF;
复杂排版;
图片说明。
所以真正决定 RAG 好不好用的:
往往并不是模型。
而是:
文件有没有先被正确读懂。
五、GraphRAG:不只是找“相似段落”
传统 Vector RAG 很擅长:
找到语义相似内容。
比如问:
A公司的合同金额是多少?
直接搜索对应段落即可。
但如果问题变成:
A公司和B项目、张经理、供应商C之间分别是什么关系?
仅靠向量相似度:
就不一定好用了。
WeKnora 因此支持:
Knowledge Graph / GraphRAG。
开启以后:
系统可以从文档中继续抽取:
Entity
以及:
Relationship。
例如:
张三
↓ 负责
项目A
↓ 使用
供应商B
↓ 签署
合同C
最终把大量碎片文档:
连接成一张知识关系网络。
六、不过GraphRAG不是默认强行打开
这里需要注意。
WeKnora 的知识图谱属于:
可选能力。
目前可以通过:
Neo4j
存储知识图谱。
用户需要在知识库里启用:
实体提取;
关系提取;
Knowledge Graph。
之后上传文档:
系统才会继续构建关系图谱。
查询时:
Agent 可以再结合:
向量检索;
关键词检索;
知识图谱
获得不同类型的信息。
所以更准确的理解不是:
“所有文件自动全部变知识图谱。”
而是:
需要的时候,可以把GraphRAG作为RAG之外的第二层知识结构。
七、再往上一层,还有自动Wiki
如果只是给机器查:
GraphRAG 很好用。
但人也需要阅读。
WeKnora 现在还有:
Wiki Mode。
Agent 可以读取原始文档以后:
自动整理出:
Markdown知识页面;
页面之间的链接;
知识结构;
知识图谱。
例如你上传几十份:
产品文档;
项目记录;
会议纪要;
技术资料。
Agent 可以进一步整理成:
产品介绍
├─ 核心架构
├─ API
├─ 使用场景
└─ 常见问题

技术架构
├─ 数据层
├─ 服务层
└─ 模型层
而不是让人一直面对:
1000个原始文件。
八、真正的变化来了:Skill Sandbox Runtime
WeKnora v0.8.0 最值得看的升级就是:
Skill Sandbox Runtime。
Agent 以前即使知道:
该运行一段代码。
也存在一个问题:
到底在哪运行?
直接在服务器宿主机执行:
显然风险很大。
所以 WeKnora 现在把 Skill 放进:
隔离沙箱。
目前支持三种 Backend:
Docker
E2B
CubeSandbox。
每一次 Chat Session 都可以拥有自己的:
持久 Sandbox Workspace。
九、知识库终于可以“动手”了
进入沙箱以后:
Agent 可以执行:
shell_exec
也可以:
读取文件;
写文件;
编辑文件;
处理附件;
运行脚本;
收集最终产物。
例如给它:
一份销售知识库;
一份 Excel;
然后说:
根据知识库中的最新产品规则,重新计算Excel里的所有客户报价,并生成新版文件。
传统 RAG:
只能告诉你:
应该怎么算。
现在则可以变成:
搜索产品规则
↓
读取报价文件
↓
Agent分析
↓
调用Skill
↓
进入Sandbox
↓
执行Python
↓
修改Excel
↓
生成新版文件
↓
返回给用户
这就是:
Knowledge → Action。
十、Skill也已经变成知识库里的“一等公民”
WeKnora 现在还有专门的:
Skill Catalog。
Skill 可以从:
ClawHub;
SkillHub;
Git;
ZIP文件
安装。
并在 Workspace 中统一管理。
Agent 执行任务时:
可以同时获得:
企业知识;
Skill;
MCP工具;
Web Search。
例如:
知识库负责告诉它:
公司的报销标准是什么。
Excel Skill:
负责处理表格。
PDF Skill:
负责生成最终报告。
Web Search:
负责查询外部信息。
组合起来以后:
Agent 才真正能够完成:
端到端任务。
十一、安全这块做得比“直接执行代码”复杂很多
让 Agent 执行代码:
风险明显比 RAG 高。
所以 WeKnora 这套 Sandbox 不是简单:
exec()
一下就完事。
每个 Workspace 可以继续配置:
CPU;
内存;
TTL;
DNS;
镜像;
Snapshot。
同时还支持:
网络策略。
例如:
默认禁止外网;
只允许访问指定域名;
禁止访问特定地址。
Docker Backend 甚至默认:
不开启。
因为如果直接挂载宿主机:
docker.sock
本质上等同拥有非常高的主机权限。
所以需要管理员主动打开。
这个设计其实很重要。
知识库从“能回答”升级到“能执行”以后:
安全边界也必须跟着升级。
十二、还可以用E2B或者腾讯自己的CubeSandbox
如果不想让 Agent 在本机 Docker 里运行:
WeKnora 还可以接:
E2B。
或者:
CubeSandbox。
CubeSandbox 是腾讯的 AI Agent 沙箱基础设施。
同样用于给 Agent 提供:
隔离代码执行环境。
这样企业可以进一步把:
知识系统
和:
执行环境
彻底分离。
Agent 拿到知识以后:
任务丢到远程 Sandbox。
执行完成:
只把结果收回来。
这个架构明显更适合:
企业生产环境。
十三、长期记忆也补上了
WeKnora v0.8.0 还加入:
Cross-Session Long-Term Memory。
以前:
知识库存的是企业资料。
但 Agent 不一定记得:
这个用户是谁。
现在还可以进一步保存:
Profile;
Preference;
Fact;
Task;
Interest。
也就是:
身份;
偏好;
事实;
任务;
兴趣。
例如你经常说:
报告不要超过10页。
以后它可以把这类偏好:
保留下来。
但自动推断出来的记忆不会直接默默写死:
需要用户确认。
这比完全黑盒地自动记忆:
要可控很多。
十四、MCP也已经接进来了
WeKnora 现在还拥有自己的:
MCP Server。
外部 Agent 可以通过 MCP 直接使用:
知识搜索;
文档读取;
知识库管理
等能力。
反过来:
WeKnora 自己的 Agent 也能继续调用:
其他 MCP 工具。
于是架构就变成:
WeKnora知识
↕
MCP
↕
Codex / Claude / DeepSeek Harness / 其他Agent
甚至在 v0.8.0 中:
WeKnora 还直接发布了官方:
DeepSeek Harness Plugin。
可以让 DeepSeek Harness Agent 直接:
搜索 WeKnora;
读取文档;
查询知识库。
知识库不需要和某一个 Agent:
绑死。
十五、微信自己也在用这套框架
WeKnora 还有一个比较重要的身份:
它是:
微信对话开放平台
背后的核心技术框架之一。
通过微信生态,可以把知识问答能力进一步部署到:
公众号;
小程序
等场景。
所以它并不只是:
GitHub 上的 Demo 项目。
整套系统的目标一直偏向:
企业级知识基础设施。
现在加入 Agent、Skills 和 Sandbox 以后:
范围进一步扩到了:
Knowledge Agent。
十六、现在GitHub已经27K+ Star
目前腾讯官方:
Tencent/WeKnora
GitHub 仓库已经达到约:
27.7K Star。
Fork:
约 3.7K。
采用:
MIT License。
支持:
本地部署;
Docker;
Kubernetes / Helm;
Web UI;
REST API;
CLI;
MCP;
Chrome Extension;
微信小程序
等多种使用方式。
同时模型层并不绑定腾讯自己。
可以接:
OpenAI兼容接口;
DeepSeek;
Qwen;
GLM;
混元;
Gemini;
MiniMax;
Ollama;
LiteLLM
等模型体系。
十七、自己部署也不复杂
最常见的方式还是:
Docker Compose。
先克隆项目:
git clone https://github.com/Tencent/WeKnora.git
cd WeKnora
复制环境配置:
cp .env.example .env然后启动:
./scripts/start_all.sh或者:
make start-all启动以后:
直接通过 Web UI 创建知识库、配置模型、上传资料即可。
如果想使用:
GraphRAG;
Sandbox;
外部搜索;
Langfuse
这些能力,
再根据需要打开对应组件。
结语
我觉得 WeKnora 现在最值得看的已经不是:
“又一个开源RAG知识库。”
而是它正在把知识系统往 Agent 基础设施推进。
整个链路已经越来越完整:
anydoc / docreader
↓
把文件读懂

RAG / GraphRAG
↓
把知识找到

Wiki
↓
把知识组织起来

Agent
↓
理解应该做什么

MCP / Skills
↓
获得工具

Sandbox
↓
真正执行任务

Memory
↓
记住长期上下文
这其实就是一个完整的:
Knowledge Agent Stack。
过去我们搭知识库:
目标是:
员工问问题的时候,AI能回答正确。
现在下一阶段的问题变成:
AI知道答案以后,能不能直接把事情办了?
比如:
读公司制度。
检查合同。
计算数据。
修改 Excel。
生成报告。
运行代码。
最后:
直接把文件交付回来。
当知识库开始拥有:
知识 + 推理 + 工具 + 执行环境
以后,
它就不再只是:
一个会回答问题的企业Chatbot。
而开始真正变成:
一个懂公司知识、还能自己动手干活的Agent。
这可能才是 WeKnora 这轮升级最值得关注的地方。
相关链接
WeKnora GitHub
https://github.com/Tencent/WeKnora
WeKnora 官方文档
https://weknora.weixin.qq.com/
WeKnora Releases
https://github.com/Tencent/WeKnora/releases
WeKnora 中文 README
https://github.com/Tencent/WeKnora/blob/main/README_CN.md
WeKnora 文档解析说明
https://github.com/Tencent/WeKnora/blob/main/website-docs/03-features/03-document-parsing.md
WeKnora 知识图谱说明
https://github.com/Tencent/WeKnora/blob/main/docs/KnowledgeGraph.md
WeKnora CLI
https://github.com/Tencent/WeKnora/tree/main/cli
CubeSandbox
https://github.com/TencentCloud/CubeSandbox
标签




评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。