
刚刚,DeepSeek 新模型突然上线:Flash 的模型,Pro 的野心


…
就在刚刚,DeepSeek 又突然扔出来一个新模型。
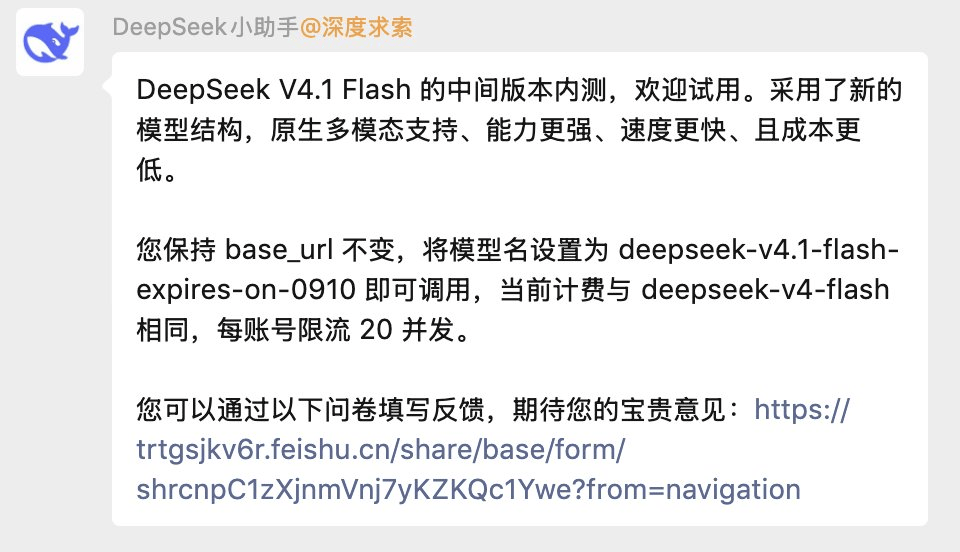
没有正式发布会。
没有长篇技术报告。
甚至连模型名称都写得非常直接:
deepseek-v4.1-flash-expires-on-0910
意思基本已经写在脸上了:
9 月 10 日到期。
这是 DeepSeek 最新开启限时测试的:
DeepSeek V4.1 Flash。
官方将它定义为一个面向用户开放测试的:
中间版本。
但这次给出的几个关键词已经非常值得关注:
新模型结构。
原生多模态。
能力更强。
速度更快。
成本更低。
名字虽然还叫 Flash,但看 DeepSeek 自己在反馈问卷里的问题:
V4.1 Flash 能否全面替代当前线上 V4 Pro?
这野心显然已经不只是:
“再做一个便宜小模型。”
一、调用方式简单到只需要改模型名
这次对现有 DeepSeek API 用户非常友好。
原来的:
base_url 完全不用修改。
只需要把模型名称替换成:
deepseek-v4.1-flash-expires-on-0910
即可直接进入测试。
也就是说,如果项目本身已经接入 DeepSeek:
基本不需要重新改一套 API 架构。
换模型 ID 就能跑。
不过需要注意:
这是一个非常短期的内测模型。
从命名就能看出来:
9 月 10 日后会失效。
更适合开发者现在快速拿自己的真实任务去压测,而不是直接作为长期生产模型写死在项目里。
二、最大变化:原生多模态
DeepSeek 最近其实已经通过:
V4-Flash-Vision-Exp
开始补视觉能力。
但 V4.1 Flash 的描述更值得关注:
新架构原生支持多模态。
这两个概念还是有区别的。
如果视觉只是后面接入的一套能力,文本模型和视觉模块之间可能仍然存在明显边界。
原生多模态则更强调:
模型从架构和训练阶段,就统一处理不同类型的信息。
对于 Agent 来说尤其重要。
因为真正的工作环境本来就不是纯文字世界。
它可能需要同时理解:
代码;
网页;
截图;
图表;
文档;
软件界面。
以后 Coding Agent 的流程可以更自然地变成:
写代码
↓
运行页面
↓
看截图
↓
发现视觉问题
↓
修改代码
↓
重新验证
DeepSeek 明显也开始往:
多模态 Agent
这个方向继续推进。
三、Flash越来越不像传统意义上的“Flash”
以前看到模型后缀:
Flash。
大家基本会自动理解成:
速度快、价格低,但能力弱一点。
但最近这一代 Flash 模型的路线已经开始变化。
DeepSeek V4 Flash 本身就已经拥有非常强的 Coding 和 Agent 能力。
现在 V4.1 Flash 又继续强调:
更强;
更快;
更便宜;
原生多模态。
甚至官方直接询问测试用户:
能不能全面替代 V4 Pro。
这意味着 DeepSeek 可能正在尝试一件很有意思的事:
把原本属于 Pro 档位的能力,继续压进 Flash 的成本和速度区间。
如果真的能做到:
那它对 Agent 场景的意义会非常大。
四、为什么 Agent 时代大家都开始疯狂做 Flash?
因为 Agent 实在太能烧 Token 了。
普通聊天:
你问一句。
模型答一句。
Agent 则可能:
读取几十个文件
↓
分析代码
↓
搜索项目
↓
调用工具
↓
运行 Terminal
↓
读取报错
↓
修改代码
↓
重新运行
↓
再检查结果
一个任务可能持续几十分钟。
甚至几个小时。
在这种工作方式下,旗舰模型即使能力再强:
成本如果一直很高,
也很难真正大规模使用。
所以现在 DeepSeek、Qwen、GLM 等模型都在做类似事情:
提高智能密度。
目标不是简单把模型变小。
而是:
用更少计算完成原本需要旗舰模型做的工作。
五、目前价格和 V4 Flash 完全一样
虽然官方描述里提到了:
成本更低。
但需要区分:
模型运行成本
和:
当前 API 对用户的实际收费。
这次内测期间,DeepSeek V4.1 Flash 的 API 计费:
与 DeepSeek V4 Flash 完全相同。
目前 V4 Flash 采用峰谷定价。
工作日高峰:
缓存命中输入:
0.10 元 / 百万 Token
缓存未命中:
3 元 / 百万 Token
输出:
9 元 / 百万 Token。
其他空闲时段:
全部半价。
因此至少在本次测试阶段:
V4.1 Flash 并没有额外涨价。
六、但并发暂时只有20
这里有一个很明显的限制:
每个账号最多20并发。
相比当前正式 V4 Flash 的高并发能力:
V4.1 Flash 明显还是测试阶段。
这也再次说明:
DeepSeek 现在主要目的应该不是立即让企业大规模迁移。
而是希望大家:
先跑起来。
拿真实 Coding、Agent、多模态任务帮它找问题。
正式版本最终叫什么、价格怎么定、并发多少:
还要等下一步。
七、社区实测速率已经很猛
虽然目前还没有看到 DeepSeek 发布完整的官方性能 Benchmark,但社区已经开始大量测试。
目前流出的多组体验结果显示:
输出速度普遍已经进入:
300 tokens/s 以上。
部分测试甚至出现:
500 tokens/s 左右。
其中有测试记录达到约:
507 tokens/s。
当然,这些数字受到:
请求内容;
服务器负载;
网络环境;
思考模式
等因素影响。
不能直接当成 DeepSeek 官方固定速度。
但至少说明:
“Flash”这个名字确实不是白叫的。
八、真正值得看的还是:它能不能替代Pro
这可能是整个 V4.1 Flash 测试里最有意思的问题。
DeepSeek 官方反馈问卷里直接问:
这个中间版本能否全面替代线上 DeepSeek V4 Pro?
这个问题其实已经透露很多东西。
如果答案最终是:
可以。
那么 DeepSeek 接下来可能会出现一种很有意思的路线:
更强模型架构
↓
更高智能密度
↓
更少计算
↓
更快生成
↓
更低成本
↓
逐渐吞掉原来的Pro能力区间
这和过去单纯:
模型越强 → 模型越大 → 模型越贵
的逻辑完全不同。
九、为什么这次只开放两天?
从 expires-on-0910 这个名字来看:
DeepSeek 根本没有准备让大家把它当正式产品。
更像一次:
超大规模真实用户 Eval。
开发者直接拿:
真实项目;
Coding Agent;
网页;
工具调用;
多模态任务
去压。
哪里失败。
哪里速度慢。
哪里视觉理解有问题。
哪里 Tool Calling 不稳定。
这些真实反馈,比单纯跑几套 Benchmark 更有价值。
有点类似之前越来越常见的:
匿名模型盲测。
只是这次 DeepSeek 直接把:
“模型两天后消失”
写进模型名字里了。
结语
DeepSeek V4.1 Flash 这次其实没有公布多少参数。
也没有放一张几十项 Benchmark 的表。
但透露出来的信息反而很有意思:
全新模型架构。
原生多模态。
能力更强。
生成更快。
成本更低。
API 接入不用改:
base_url
只需要换成:
deepseek-v4.1-flash-expires-on-0910
就可以直接测试。
内测价格:
和 V4 Flash 相同。
每个账号:
20 并发。
然后:
9 月 10 日到期。
最值得看的还是 DeepSeek 自己问的那句话:
“它能不能全面替代 V4 Pro?”
如果最终答案真的可以,
那么这次虽然名字只是:
V4.1 Flash。
背后的目标可能已经不是:
再做一个更便宜的模型。
而是:
Flash 的成本,Pro 的能力。
这两天,有 API 的确实可以赶紧拿真实项目试一下。
毕竟模型名都已经提醒你了:
过期不候。
相关链接
DeepSeek 官网
DeepSeek API 开放平台
https://platform.deepseek.com/
DeepSeek API 官方文档
https://api-docs.deepseek.com/
DeepSeek 模型与价格
https://api-docs.deepseek.com/zh-cn/quick_start/pricing/
DeepSeek API 更新日志
https://api-docs.deepseek.com/zh-cn/updates/
DeepSeek V4 官方介绍
https://deepseek.com/news/v4-preview/
标签




评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。