
CatPaw 模型上新|智谱 GLM-5.3-Flash 上线


今天,GLM-5.3-Flash 正式上线 CatPaw!
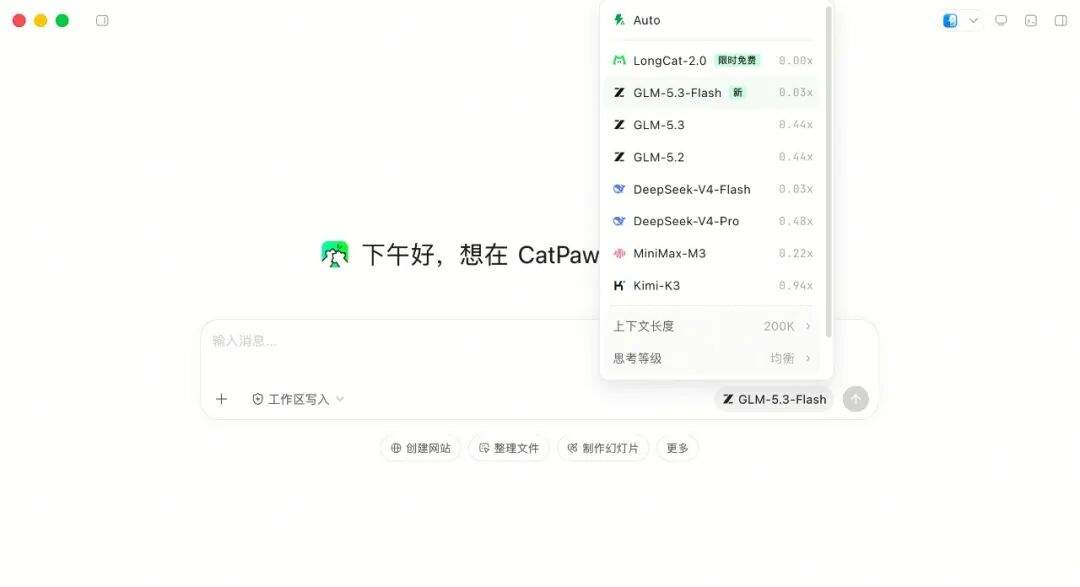
打开 CatPaw → 切换模型 → 开始体验
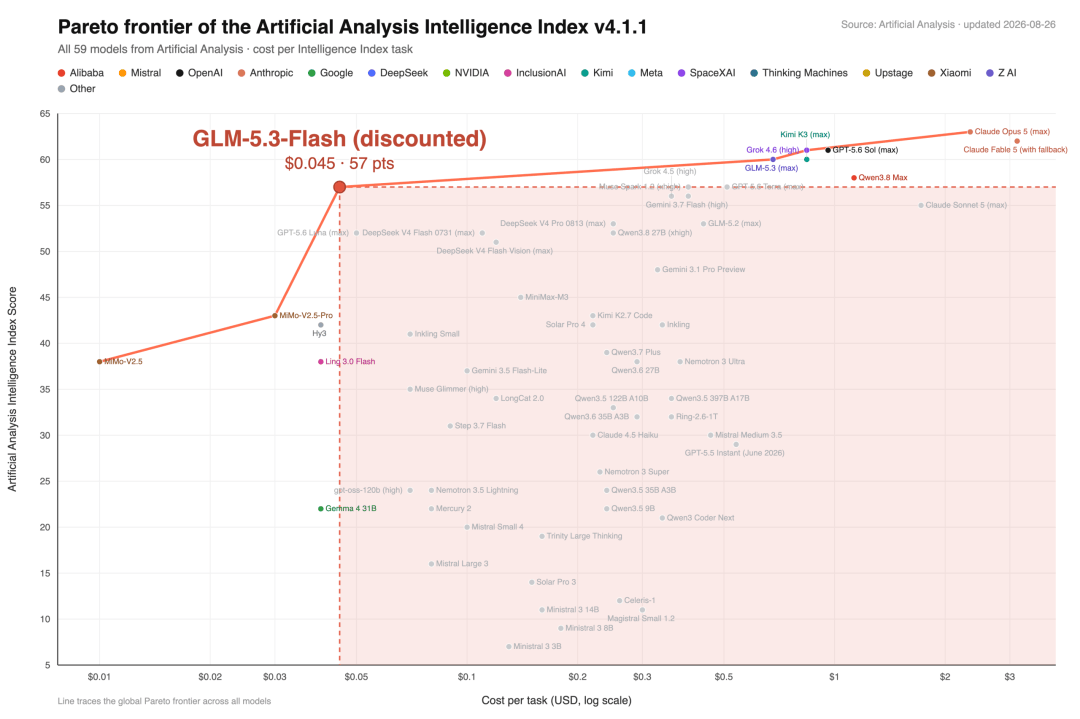
GLM-5.3-Flash (320B-A18B) 是 GLM-5 系列首个原生多模态模型。大家好像已经习惯把前沿智能和前沿价格绑定。这次不同:它在 Artificial Analysis 综合智能指数取得 57 分,与 Claude Opus 4.8 持平;定价仅为后者的 1/40。同样智力,1/40 价格,前沿智能,第一次不需要省着用。
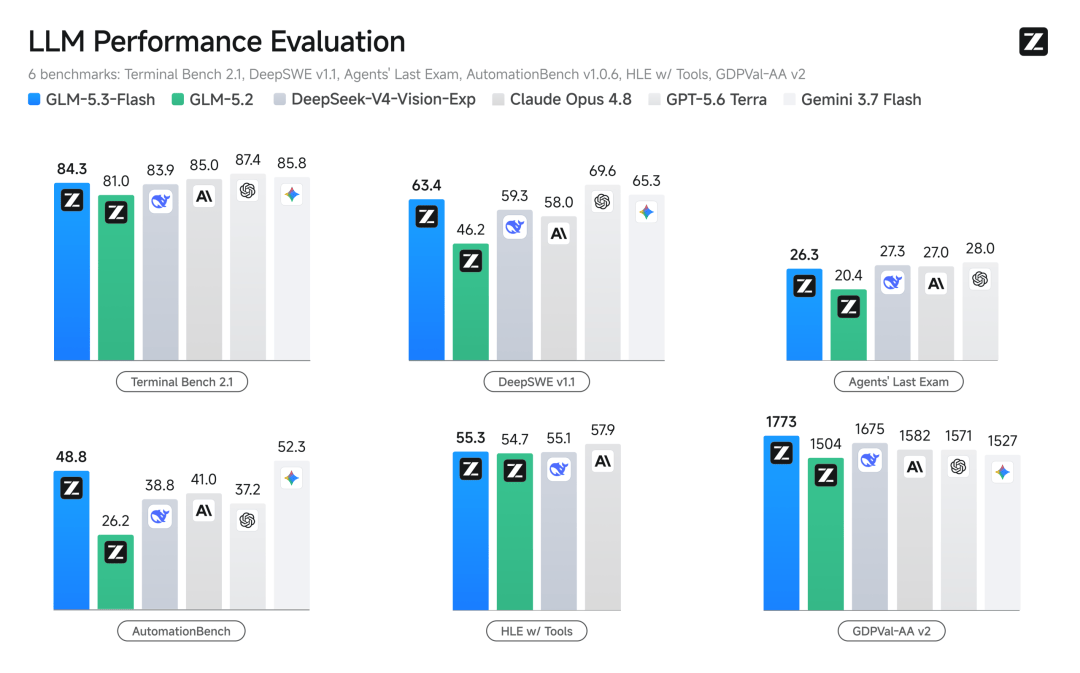
GLM-5.3-Flash 模型表现
1
极致低成本:前沿智能的普惠之路
低成本不是降价降出来的,是架构设计出来的:GLM-5.3-Flash 的激活参数从 32B 降至 18B、层数从 92 减至 45,几乎减半;作为采用稀疏注意力与线性注意力混合架构的开源前沿模型,其注意力计算量和 KV 缓存较 GLM-5.3 分别降低 3.01 倍和 4.44 倍。最终定价仅为 GLM-5.3 的 1/10、Claude Opus 4.8 的 1/40,同时支持 1M 上下文窗口、最大输出 128K,长文档、多素材任务,放心丢给它。
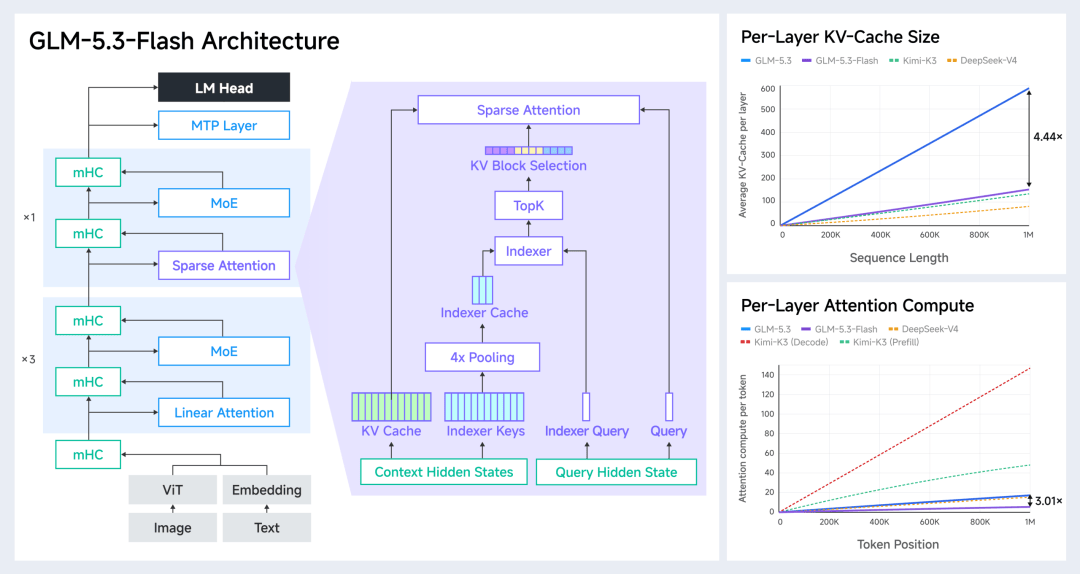
GLM-5.3-Flash 架构
2
代码循环中的视觉反馈:从“写代码”到“看效果”
以前,模型只能读代码、改代码,写完对不对,全靠人工验收;现在,视觉能力被原生融入 Coding 循环,模型自己判断何时需要“观察”,看渲染结果和交互反馈,再决定下一步怎么改。给它一组产品页面截图,可以直接说:“根据这些截图,用 Next.js 和 TypeScript 复刻这个产品,完成后启动项目逐页截图对比修正。”更直观的例子是:在没有任何外部素材的情况下,GLM-5.3-Flash 自主运行 16 小时,在 Blender 中搭建出一套约 400 平方米的专业主厨自宅与测试厨房——每一步都靠观察画面推进。
3
跑在国产算力上:软硬协同的正向循环
发布前,智谱以匿名模型 Ox-Alpha(牛来)在 OpenCode 和 OpenRouter 上公开测试,创下双平台调用量新高——而这些流量,全部由国产算力集群承载。经过推理引擎和内存层面的持续优化,端到端服务性能较初始基线提升 3 倍,单 Token 成本已与主流英伟达 GPU 相当。1/40 的价格,由此而来。
标签




评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。