
阶跃星辰开放 Step 5 Preview 权重600B MoE
…
前几天,Step 5 Preview 刚刚接入腾讯 WorkBuddy,开放了为期两周的免费体验。
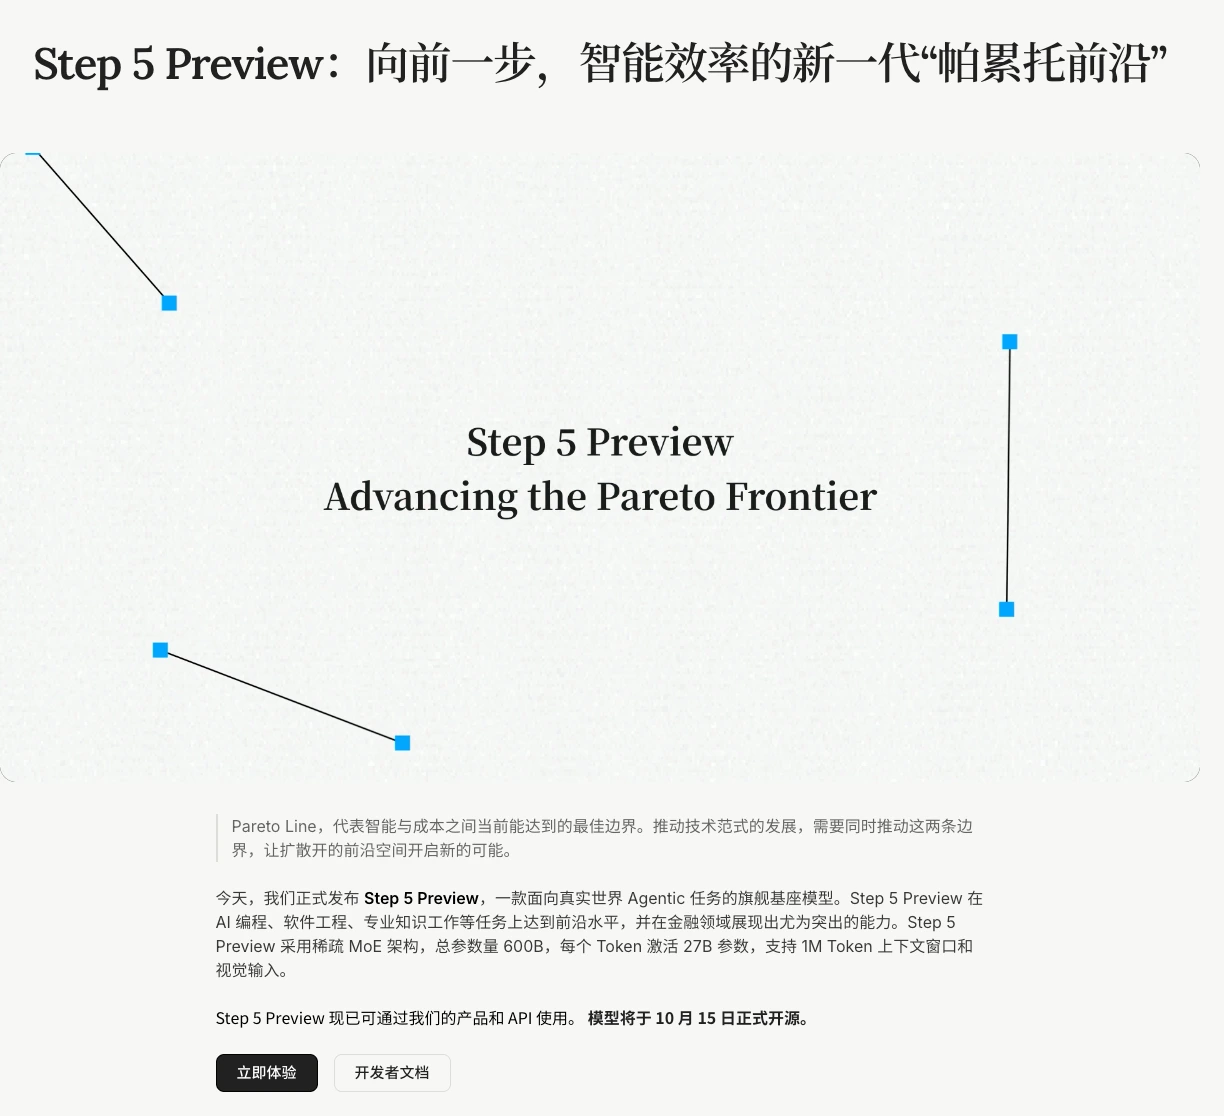
现在,阶跃星辰又把更重要的一步补上了:
Step 5 Preview 模型权重正式开放。
这意味着开发者不再只能通过:
阶跃 API;
WorkBuddy;
第三方模型平台
调用这款模型。
具备服务器级算力的企业和研究团队,现在可以直接下载权重,在自己的环境中完成:
私有化部署;
推理优化;
Agent 接入;
工具调用适配;
模型研究;
业务测试。
Step 5 Preview 的核心规格依然非常亮眼:
600B 总参数。
每个 Token 激活约 27B 参数。
最高 1M Token 上下文。
原生支持长程 Agent 和多模态工作流。
它不是一款单纯为聊天设计的大模型,而是一款明显围绕:
真实任务执行
打造的 Agent 基座。Hugging Face
一、这次到底开放了哪些内容?
目前,阶跃星辰已经在 Hugging Face 发布三个 Step 5 Preview 权重版本:
Step-5-Preview
官方默认模型仓库,当前主要对应 FP8 权重。
Step-5-Preview-BF16
保留更高精度的 BF16 权重,更适合研究、进一步量化和对精度要求较高的部署场景。
Step-5-Preview-NVFP4
采用更低精度格式进一步压缩权重体积,面向支持相应硬件与推理工具的高效部署场景。
除了权重,官方还同步开放或公布了:
GitHub 推理代码;
模型配置;
Tokenizer;
FP8 与 BF16 转换工具;
Transformers 离线生成实现;
vLLM 部署容器;
SGLang 部署方案;
OpenAI 兼容接口配置;
技术博客;
模型评测说明;
工具调用和推理解析器。
所以这次不只是:
“放出一个几百 GB 的模型文件。”
而是尽量把从下载权重到启动服务的路径一起补齐。Hugging Face
二、600B 总参数,为什么只激活 27B?
Step 5 Preview 采用:
Sparse MoE,稀疏混合专家架构。
模型整体拥有约:
6000 亿参数。
但处理每一个 Token 时,并不会把全部参数都运行一遍。
系统只会根据当前输入,选择一部分最相关的专家参与计算,实际激活规模约为:
270 亿参数。
可以把它理解成一家拥有大量专业部门的公司。
公司整体知识和能力非常大。
但接到一个具体任务时,不需要所有部门同时参与。
模型会根据任务,动态选择最适合的专家。
这类架构希望同时获得两种优势:
一方面,保留大模型的知识容量和任务能力。
另一方面,避免每次推理都支付 600B 稠密模型的完整计算成本。
因此,Step 5 Preview 虽然总参数很大,但实际计算规模更接近几十 B 级模型。
当然,激活参数少不等于部署时只需要加载 27B 权重。
完整模型权重仍然需要进入显存或分布式系统,这也是它依然需要 B300、H200 等服务器级 GPU 的原因。
三、它为什么特别强调“窄而深”?
阶跃星辰在技术博客中将 Step 5 Preview 的架构概括为:
Narrow but Deep,窄而深。
模型一共包含:
92 个 Transformer Block。
相比单纯增加每一层的宽度,阶跃选择继续增加网络深度。
原因和长程 Agent 的工作方式有关。
一个 Agent 执行复杂任务时,经常需要经历:
理解需求
↓
读取大量上下文
↓
调用工具
↓
观察工具结果
↓
修改计划
↓
继续执行
↓
验证结果
↓
发现问题后再次修正
大量信息会在 Prefill 阶段进入模型。
如果模型深度不足,长距离、多步骤信息很难在网络内部持续传递和组合。
更深的网络,则有机会在不输出大量显式思维过程的情况下,完成更多隐式的多跳推理。
阶跃希望通过这种架构,让模型在复杂 Agent 任务中既能保持较强推理能力,又避免无限生成冗长的思考 Token。StepFun开放平台
四、3:1 混合注意力,专门为百万上下文降成本
Step 5 Preview 并不是每一层都使用完整注意力。
它采用:
3 层高效注意力 + 1 层稀疏完整注意力
交替组合的方式。
高效注意力部分使用:
Gated Sliding Window Attention。
它更关注当前位置附近的信息,计算成本更低。
完整注意力部分则使用:
Sparse GQA。
模型不会让每个 Token 都与整个百万上下文进行完整计算,而是先通过索引机制,从历史内容中挑出真正相关的部分。
官方还将相邻历史位置合并成 Block 表示,把索引和 Top-K 筛选成本降低到原来的约:
1/8。
这套设计主要解决的是百万上下文里的两个矛盾:
模型需要记住很远的信息。
但又不能让每一步计算都扫描完整历史。
最终思路是:
大部分层
→ 高效处理局部信息

少部分关键层
→ 从全局历史中筛选重要内容

真正相关的信息
→ 进入完整注意力计算
这也是 Step 5 Preview 能够把上下文扩展到 1M,同时控制推理成本的重要原因。StepFun开放平台
五、1M 上下文,真正适合的是长程 Agent
100 万 Token 可以容纳大量代码、文档和任务历史。
例如:
大型代码仓库;
数十份行业报告;
大量财务文档;
历史会议纪要;
长时间终端执行日志;
多轮工具调用结果;
复杂项目上下文。
对于 Coding Agent 来说,它可以在同一次任务中保留更多:
源码;
依赖关系;
测试结果;
错误日志;
历史修改;
用户反馈。
对于办公与研究 Agent 来说,则可以同时处理:
PDF;
图表;
截图;
研究资料;
表格;
历史方案;
会议记录。
不过需要注意:
1M 是输入和输出共享的总上下文预算。
而且真正部署时,能不能稳定跑满 1M,还取决于:
GPU 显存;
KV Cache;
并发量;
推理框架;
Prefix Cache;
量化版本。
官方也明确提醒,示例硬件可以加载模型,并不代表在高并发情况下仍然可以无压力跑满 1M。显存不足时,需要降低最大上下文或并发数。GitHub
六、它重点不是聊天,而是软件工程和专业工作
Step 5 Preview 的官方定位是:
Flagship Model for Agentic Work。
主要能力集中在四个方向。
软件工程
模型可以处理:
代码仓库级任务;
跨文件修改;
前端和视觉开发;
设备编程;
代码运行和验证;
失败后的多轮修复。
它的目标不是只生成一个函数。
而是尽量完成:
理解整个项目
↓
找到相关文件
↓
完成代码修改
↓
运行测试
↓
检查实际结果
↓
继续迭代
长程 Agent 执行
模型可以在多轮工具调用、执行、验证和修改中持续推进任务。
专业知识工作
可以结合研究、长文档、图表、截图和多模态信息,生成结构化报告与分析。
金融分析
阶跃特别强调了金融场景,包括财务数据、支持文档和量化推理的综合分析。Hugging Face
七、多模态能力需要注意一个官方文档差异
阶跃官方介绍和 GitHub README 都表示,Step 5 Preview 可以处理:
文本;
图片;
视频。
并能围绕图片、截图、图表和视频进行理解与分析。
不过当前模型卡的规格表中,输入类型一栏只明确列出了:
Text、Image。
也就是说,官方介绍与规格表之间目前存在轻微差异。
因此更加稳妥的表述是:
Step 5 Preview 面向文本和视觉多模态任务,官方介绍包含视频理解能力;但本地部署视频输入时,应以最新推理框架、模型代码和官方文档为准。
不要因为在线 API 或 WorkBuddy 支持视频,就默认所有本地推理方案都已经完整适配相同的视频输入流程。Hugging Face
八、为什么这款模型特别适合 Agent 后训练?
阶跃并没有只围绕普通问答数据训练 Step 5 Preview。
官方为它搭建了一套:
Agent-native Data Construction System。
在这套系统中,Agent 会参与:
寻找知识;
构造任务;
搭建执行环境;
检查结果;
发现任务漏洞;
调整任务难度。
人类专家则负责:
定义原则;
提供专业判断;
审核关键环节;
控制任务质量。
最终,阶跃构建了百万级可验证任务环境,覆盖:
科学推理;
软件工程;
机器学习研发;
专业知识工作。
这些任务不是普通的“问题—答案”数据。
模型需要真的进入环境:
读取文件;
调用工具;
运行代码;
修改内容;
通过验证。
这更接近真实 Agent 每天面对的任务。StepFun开放平台
九、强化学习也围绕“长任务”重新设计
长程 Agent 的强化学习,比普通问答 RL 更难。
一次任务可能持续:
几十轮;
几百轮;
甚至上百万 Token。
如果最后任务失败,只给模型一个:
0 分
很难判断到底是哪一步做错了。
Step 5 Preview 的训练系统因此重点解决:
训练与推理一致性;
长轨迹 Rollout 效率;
工具调用错误定位;
Token 与轮次级信用分配;
上下文压缩与任务恢复;
Reward Hacking 检测。
官方还公布了几项系统优化:
MTP-3 推测解码带来约 30% 端到端提速;
原生 FP8 MoE 再提供约 20% 效率提升;
通过专家并行、KV Offload、MXFP4 权重存储和 FP8 KV 量化,将有效 KV Cache 容量扩大约 8~12 倍。
这些优化真正服务的不是普通聊天速度。
而是:
让 Agent 可以更长时间、更低成本地持续工作。StepFun开放平台
十、FP8、BF16 和 NVFP4 应该怎么选?
FP8
更适合直接部署和高效推理。
官方默认 Step-5-Preview 仓库主要对应 FP8 权重。
优势是:
显存占用更低;
推理效率更高;
部署门槛相对更低。
BF16
保留更高精度,更适合:
模型研究;
进一步量化;
精度敏感场景;
分析不同精度带来的差异。
但硬件要求也更高。
NVFP4
进一步压缩模型体积,适合支持相应 Blackwell 硬件和推理技术的场景。
它可能降低权重存储和部署成本,但仍需要评估:
精度变化;
算子支持;
框架兼容性;
实际业务表现。
三种权重不是简单的“高级、中级、低级”关系。
更像是在:
精度;
显存;
速度;
硬件条件
之间提供不同选择。Hugging Face
十一、本地部署到底需要多少卡?
官方当前提供的参考方案如下。
FP8 + B300
4 张 B300。
支持 vLLM 或 SGLang。
可选择:
TP4;
TEP4;
DEP4。
FP8 + H200
8 张 H200。
支持 vLLM、SGLang 或 Transformers 离线生成。
BF16 + B300
8 张 B300。
BF16 + H200
两台 8 卡 H200 节点,共 16 张 H200。
所以“4 卡部署”必须带完整限定:
4 张 B300 运行 FP8 权重。
它不是指:
4 张 RTX 4090;
4 张普通工作站显卡;
任意 4 张服务器 GPU。
另外,官方还提醒,BF16 的完整 Transformers 分片转换与生成流程尚未完成全模型端到端验证,目前公开的是参考实现与初始部署路径。
真正用于生产环境前,仍然需要完成:
稳定性测试;
精度验证;
吞吐测试;
长上下文测试;
并发压测。GitHub
十二、支持哪些推理框架?
官方目前提供三条主要部署路线。
vLLM
适合搭建 OpenAI 兼容 API 服务。
支持:
推理解析;
自动工具选择;
Tool Call Parser;
Prefix Cache;
MTP 推测解码;
Tensor / Data / Expert Parallel。
SGLang
同样可以提供 OpenAI 兼容服务,并支持:
Expert Parallel;
MegaMoE;
不同 Attention Backend;
Speculative Decoding;
高并发服务。
Transformers
主要用于离线生成与研究。
官方提供权重分片转换和多进程运行方式。
这意味着开发者可以根据任务选择:
在线 API 服务;
高吞吐 Agent 平台;
离线研究与测试。
同时,上层应用可以继续通过 OpenAI 兼容协议接入,不需要为 Step 5 Preview 重新设计一整套调用接口。Hugging Face
十三、许可证不是普通 Apache 2.0
这次最容易被忽略的,就是许可证。
Step 5 Preview 并没有直接采用:
MIT;
Apache 2.0;
或者纯粹的开源软件许可证。
模型使用的是:
StepFun Model License 1.0。
官方称其为:
Apache-2.0-Style License。
但同时加入了针对模型使用、修改、分发和商业应用的额外条件。
因此,更准确的说法是:
阶跃星辰开放了模型权重和部署代码。
如果是个人研究和技术验证,可以按照许可证使用。
如果准备进行:
大规模商业服务;
模型再分发;
托管 API;
二次模型发布;
企业产品集成,
应先完整阅读许可证,而不是默认它和 Apache 2.0 完全相同。GitHub
十四、开放权重以后,企业真正得到了什么?
只提供 API 时,企业可以调用模型,但很多关键能力仍然掌握在平台手中。
例如:
模型版本;
数据经过哪里;
服务是否调整;
并发和限流;
长期成本;
模型何时下线。
开放权重以后,团队可以进一步:
在自有服务器部署;
处理内部文档和代码;
控制模型版本;
连接私有知识库;
搭建内部 Agent;
测试不同量化方案;
优化推理吞吐;
研究模型结构;
建立自己的服务和权限体系。
对于金融、研发、企业知识和其他对数据边界要求较高的场景,这种控制能力非常重要。
不过,开放权重并不等于部署成本很低。
Step 5 Preview 依然是一款 600B 级模型。
更适合:
云服务商;
大型企业;
模型推理团队;
高校和研究机构;
拥有服务器级 GPU 集群的开发团队。
普通个人用户直接使用 API 或 WorkBuddy,仍然会更加现实。
十五、这次开放真正值得关注的是什么?
表面上看,这次新闻可以浓缩成一句:
600B 模型开源了。
但真正有价值的是,阶跃把几个关键部分一起补上了:
FP8 / BF16 / NVFP4权重
+
模型架构说明
+
长程Agent训练方法
+
vLLM / SGLang / Transformers适配
+
OpenAI兼容服务
+
多卡部署方案
+
工具调用解析
+
技术博客与代码仓库
这让 Step 5 Preview 不再只是排行榜和产品中的一个模型名称。
开发者终于可以真正研究:
它为什么适合长任务;
稀疏注意力如何工作;
不同并行策略有什么差异;
FP8 与 BF16 的效果如何;
它在自己的 Agent Harness 中表现怎么样。
这才是开放权重最实际的价值。
结语
Step 5 Preview 这次可以记住几组核心信息:
600B 总参数。
27B 激活参数。
92 层 Transformer。
最高 1M Token 上下文。
稀疏 MoE + Gated SWA + Sparse GQA。
权重版本包括:
FP8。
BF16。
NVFP4。
推理框架包括:
vLLM。
SGLang。
Transformers。
官方当前最低参考部署方案是:
4 张 B300 运行 FP8。
H200 运行 FP8 则需要:
8 张。
BF16 的硬件要求还会进一步提高。
所以这次真正值得关注的,不只是:
“阶跃也开放了一个600B模型。”
而是它把模型、架构、长程 Agent 训练思路和部署路径同时交给了开发者。
以前只能在 WorkBuddy 或 API 中体验它。
现在,具备足够算力的团队终于可以把它真正拿回自己的环境里:
自己部署、自己测试,也自己决定怎么用。
相关链接
Step 5 Preview 官方介绍
https://www.stepfun.com/step-5-preview

Step 5 Preview Hugging Face 合集
https://huggingface.co/collections/stepfun-ai/step-5-preview

Step 5 Preview FP8 权重
https://huggingface.co/stepfun-ai/Step-5-Preview

Step 5 Preview BF16 权重
https://huggingface.co/stepfun-ai/Step-5-Preview-BF16

Step 5 Preview NVFP4 权重
https://huggingface.co/stepfun-ai/Step-5-Preview-NVFP4

Step 5 Preview ModelScope
https://www.modelscope.cn/models/stepfun-ai/Step-5-Preview

Step 5 Preview GitHub
https://github.com/stepfun-ai/Step-5-Preview
标签
评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。