
阿里发布 AI 音乐模型 HappyShrimp 1.0:一句自然语言,从作词、作曲到演唱直接生成完整歌曲


…
HappyShrimp 国内官网:
https://www.happyshrimp.cn/
HappyShrimp 海外官网:
https://www.happyshrimp.ai/
现在 AI 生成图片、视频已经越来越普及。
写一句 Prompt:
图片出来了。
再写一段描述:
30 秒视频也出来了。
现在阿里又把生成式 AI 的能力推进到了音乐领域。
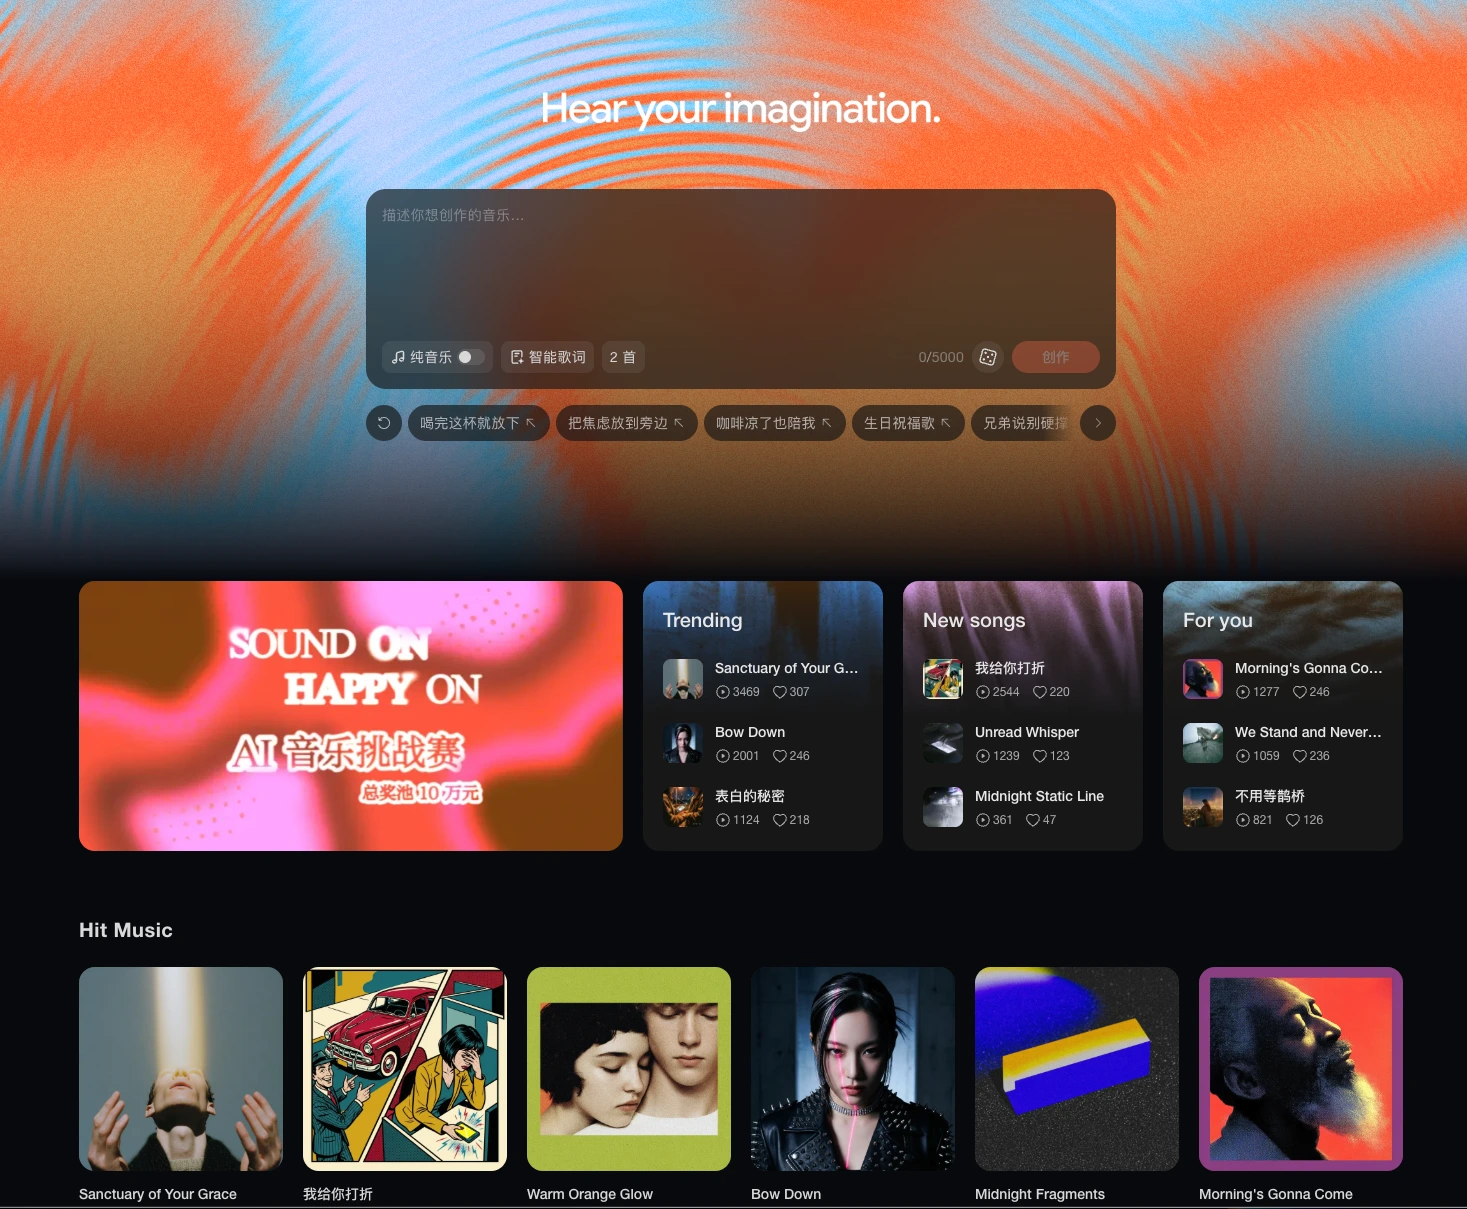
2026 年 8 月 17 日,阿里巴巴正式推出 AI 音乐生成模型 HappyShrimp 1.0,中文名“快乐虾米”。
目前产品处于 Beta 测试阶段,由阿里巴巴 Token Hub(ATH)业务团队开发。用户只需要输入一段自然语言,就可以从一个模糊想法出发,生成一首包含旋律、编曲、歌词和人声演唱的完整歌曲。
比如以前想做一首歌,你可能需要告诉音乐生成工具:
BPM 92
C minor
Neo Soul
Rhodes Piano
Warm Bass
Male Vocal
70s
Tape Saturation
不知道这些专业音乐标签怎么办?
HappyShrimp 想解决的恰恰就是这个问题。
你甚至可以只说:
做一首关于凌晨一个人开车回家的歌,有点孤独,但不是悲伤,城市霓虹从车窗外慢慢划过去。
剩下的:
作词、旋律、编曲、人声、音乐结构
都可以继续交给模型完成。
阿里在官方介绍中明确表示,HappyShrimp 1.0 不要求普通用户掌握 BPM、调性或者具体乐器配置等音乐专业知识,仅凭情绪、故事概念或者目标音乐类型,就可以开始生成完整歌曲。
对于普通用户来说:
音乐生成的输入方式,开始越来越接近“说人话”。
一、HappyShrimp 1.0 是什么?
HappyShrimp 1.0 是阿里巴巴推出的一款:
AI Music Generation Model,AI 音乐生成模型。
中文名叫:
快乐虾米。
目前 HappyShrimp 1.0 已经以 Beta 形式上线,国内和海外用户均可以直接通过 PC 网页端体验。阿里官方海外介绍页面也已经提供 HappyShrimp 国际版入口。
国内:
海外:
它最核心的能力,可以概括成一句话:
把自然语言描述直接变成完整音乐。
你可以给它:
一个情绪;
一个故事;
一段记忆;
一个音乐类型;
一段自己写好的歌词。
然后让 AI 继续完成音乐制作。
阿里官方表示,目前 HappyShrimp 支持 Text-to-Music,也就是 T2M 音乐生成,可以生成:
完整人声歌曲
以及:
纯器乐作品。
用户既可以完全从零生成歌词和歌曲,也可以自己提供歌词,再让模型负责作曲、编曲和人声演唱。
二、和很多 AI 音乐工具不同,它重点强调“自然语言”
HappyShrimp 1.0 最值得关注的一点,不单单是:
“AI 能生成歌曲。”
这件事现在已经不是第一次出现。
真正有意思的是:
它把自然语言理解放到了音乐创作入口的核心位置。
很多传统 AI 音乐生成工具,更适合熟悉音乐标签的人。
例如:
Lo-fi
Dream Pop
Synthwave
90 BPM
Female Vocal
Piano
Ambient
Cinematic
你得先知道:
自己需要什么 Style;
什么 Instrument;
什么 Vocal;
什么 BPM。
这实际上仍然存在一定学习成本。
HappyShrimp 则希望你可以直接说:
写一首像凌晨四点城市刚刚开始下雨时的歌,一个人刚结束一段感情,但已经慢慢接受了现实。
模型再自己理解:
应该使用什么音乐情绪;
怎样安排旋律;
如何推进歌曲能量;
人声应该是什么状态;
歌词应该表达什么。
阿里官方介绍中甚至给出了类似:
“千禧年华语流行”
“都市民谣中像黎明一样的感觉”
以及:
“副歌加入歌剧式人声”
这样的自然语言要求。
模型需要做的并不是简单识别几个关键词。
而是理解:
整句话到底想表达什么音乐。
三、从作词、作曲、编曲到演唱,一句话完成整首歌
HappyShrimp 1.0 采用的是:
完整歌曲生成路线。
根据阿里官方说明,一条 Prompt 就可以同时生成:
- Lyrics;
- Melody;
- Arrangement;
- Vocals。
也就是:
歌词 + 旋律 + 编曲 + 演唱。
整个工作方式可以简单理解成:
一句自然语言
↓
理解故事 / 情绪 / 曲风
↓
规划歌曲结构
↓
生成歌词
↓
生成旋律
↓
完成编曲
↓
生成人声
↓
输出完整歌曲
过去很多 AI 音乐工作流更接近:
先生成歌词;
再生成旋律;
再合成人声;
最后拼成一首歌。
环节越多,就越容易出现一个问题:
词、旋律和音乐情绪各干各的。
比如歌词已经进入副歌高潮。
伴奏还没起来。
或者歌词内容很悲伤。
配乐却非常欢乐。
HappyShrimp 强调的思路,是把音乐看成一种同时具有:
Grammar、Semantics 和 Context
的特殊语言。阿里介绍称,模型会同时建立歌曲结构、节奏推进、和声发展等“音乐语法”,以及情绪、能量变化、歌词意图等“音乐语义”的结构化表示。
简单理解:
它不是最后把几个生成结果拼成一首歌,而是从一开始就按照“一整首歌”去考虑。
四、为什么“端到端整曲生成”很重要?
一首真正完整的歌并不是:
主歌 + 副歌 + 人声
简单叠在一起。
它通常还有:
Intro;
Verse;
Pre-Chorus;
Chorus;
Bridge;
Drop;
Outro。
与此同时:
乐器;
和声;
情绪;
人声;
动态
也需要随着歌曲结构一起变化。
比如一首赛车电影主题曲:
开场可能先用低频和弦建立压迫感;
随后加入节奏;
进入副歌时弦乐和鼓点同时增强;
Rap 部分再切换人声和节奏;
最终完成高潮。
如果每一部分都是独立生成:
整体很容易散掉。
HappyShrimp 的设计目标则是让模型兼顾:
长程音乐结构。
国内发布信息也明确提到,模型面对语言描述、歌词、曲风、情绪、年代、人声等要求时,会进行整体规划和同步创作,而不是分别处理以后再简单拼接。
这也是“整曲生成”比单纯生成一段 Loop 难得多的地方。
五、不懂乐理,也可以直接描述脑子里的画面
我觉得 HappyShrimp 最适合普通用户的一种使用方式,不是:
“帮我生成 R&B。”
而是:
直接描述画面。
比如:
一个男生坐在凌晨最后一班地铁上,车厢里几乎没人,窗户里一直倒映着自己的脸。做一首克制的都市流行歌曲,前半段孤独,后半段慢慢释然。
或者:
夏天傍晚,一群大学生骑着自行车沿海边回家,风很大,大家一直笑。做一首年轻、明亮、有青春电影片尾感的中文歌曲。
甚至:
做一首关于程序员凌晨三点终于修好 Bug 的歌,前面非常压抑,副歌突然释放,带一点摇滚和电子音乐。
以前这些描述更多是:
给人类制作人看的 Brief。
现在直接给模型,也能成为音乐生成指令。
HappyShrimp 官方表示,模型拥有广泛的音乐知识,可以理解不同:
Genre、Region、Era 和 Cultural Context。
这让自然语言真正有机会成为音乐创作界面。
六、它并不排斥专业音乐术语
自然语言创作并不意味着:
专业用户只能说大白话。
实际上 HappyShrimp 可以同时接受更加精确的音乐控制。
官方表示,用户可以进一步指定:
- Narrative Flow;
- Instrumentation;
- Vocal Style;
- Emotional Dynamics。
也就是:
故事推进;
配器;
演唱方式;
情绪变化。
国内公开体验信息中还提到,它能够理解包括:
人声性别;
唱法;
调性;
BPM;
配器组合;
情绪推进
在内的多维要求。
所以它实际上同时兼顾两种输入方式。
普通用户
一首夏天下午坐在海边发呆的轻松歌曲。
专业用户
92 BPM,女声,Neo Soul / R&B,以 Rhodes、Soft Bass 和轻鼓为主,主歌保持低动态,第二遍副歌增加和声,人声温暖克制。
都可以继续使用。
七、HappyShrimp 能生成哪些音乐类型?
按照阿里官方目前公布的信息,HappyShrimp 1.0 已经覆盖多个常见音乐类型,例如:
- 中国风;
- Pop;
- R&B / Soul;
- Hip-Hop;
- Rock;
- Funk;
- Electronic;
- Classical;
- Jazz。
HappyShrimp 海外官网目前展示的示例方向也包括:
K-Pop Dance
Mandopop Ballad
Arena Rock Anthem
Old-School Hip-Hop
Synth-Pop
Tropical House
Folk
等不同类型。
这说明它的定位并不是:
只做中文流行歌。
而是希望覆盖比较广泛的音乐风格与创作场景。
八、你也可以自己写歌词,让 AI 负责剩下的部分
如果你不想让 AI 帮你写词,也没问题。
HappyShrimp 目前支持:
用户自定义歌词。
阿里官方说明称,用户可以提交自己的歌词,再让模型继续完成:
Composition;
Arrangement;
Vocal Performance。
也就是:
作曲、编曲和演唱。
这对于内容创作者其实很实用。
例如你已经写了一段:
品牌歌词;
短视频歌词;
生日歌;
活动主题文案。
但不会:
写旋律;
编曲;
唱歌。
就可以尝试:
自己的歌词
+
音乐方向描述
↓
HappyShrimp
↓
完整歌曲
这样 AI 不一定取代你的创作内容,而是在继续完成你不会的部分。
九、还可以直接生成纯音乐
不是所有内容都需要唱歌。
做视频的人应该特别有感。
很多时候真正缺的是:
BGM。
例如:
Vlog;
科技产品宣传片;
品牌短片;
纪录片;
游戏视频;
旅行视频;
电影概念片。
HappyShrimp 当前已经提供:
Instrumental
模式,可以生成纯器乐音乐。海外官网当前创作界面也直接提供 Instrumental 选项。
比如可以说:
做一首适合冰川纪录片的氛围电子音乐,冷、空旷、缓慢、有一点未来感,从安静逐渐进入宏大的情绪,但不要出现明显鼓点。
官方文章中实际上就展示过 Future Garage / 冰川氛围方向的案例,并指出模型能够根据“冰川融化”这样的描述控制声音设计、空间感和情绪氛围。
对短视频创作者来说,这类能力的实用性可能比“生成一首流行歌曲”还高。
十、HappyShrimp 最适合哪些人?
1. 普通音乐爱好者
以前不会:
作词;
作曲;
编曲;
录音。
现在也可以直接从一个故事开始做歌。
2. 短视频创作者
可以生成:
短视频 BGM;
Vlog 配乐;
剧情配乐;
产品展示音乐。
3. 自媒体创作者
比如做一期:
“我让 AI 把自己的故事写成了一首歌。”
内容本身就非常适合传播。
4. 广告与品牌团队
可以快速测试:
品牌音乐;
Campaign Demo;
活动氛围音乐;
广告配乐方向。
正式商用前仍然建议确认具体平台授权和版权条款。
5. 游戏与独立开发者
可以快速制作:
Menu Music;
Ambient;
Battle Concept;
Trailer Demo。
尤其适合前期概念验证。
6. 专业音乐人
专业音乐人未必需要 AI:
“帮我一键完成一切。”
更可能把它当成:
Idea Generator。
例如快速测试:
十种编曲方向;
不同人声;
不同 Genre;
不同情绪推进。
再选择最喜欢的方向继续人工制作。
十一、AI 音乐真正降低的是“试错成本”
我觉得这类模型最值得关注的地方,其实不是:
“人人以后都能成为专业音乐人。”
这种说法太夸张。
更实际的价值是:
一个音乐想法,可以非常便宜地先听见。
以前脑子里突然想到:
如果把中国风和 Future Garage 放一起会怎么样?
你可能需要:
找制作人;
沟通;
编曲;
录 Demo。
最后才能知道:
好不好听。
现在则可以先生成。
不好听?
换一个方向。
再生成。
整个创作流程逐渐从:
想法
↓
需要掌握大量专业技能
↓
制作 Demo
↓
判断是否值得继续
变成:
想法
↓
自然语言
↓
AI Demo
↓
快速判断
↓
继续调整
这对音乐创作最大的影响之一,就是:
大量想法终于可以低成本被试听。
十二、真正厉害的不是“一句话写歌”,而是复杂 Prompt 控制
AI 音乐模型最容易 Demo 的功能就是:
给我一首悲伤的歌。
真正决定模型能不能进入创作工作流的,反而是:
复杂要求能不能同时听懂。
例如:
70 年代 Soul,男性主唱,模拟磁带录音的温暖质感。第一段保持非常克制,第二次副歌加入女声和声,Bridge 降低鼓点,最后重新进入完整乐队。
这里同时包含:
年代;
Genre;
人声;
音色;
歌曲结构;
动态;
编曲变化。
HappyShrimp 官方将“Precise Controllability”作为 1.0 的重点之一,表示模型能够让用户定义的叙事流程、配器、人声风格和情绪变化体现在最终歌曲里。
如果这类复合控制足够稳定,它的价值就不仅是:
“AI 娱乐玩具。”
而会逐渐进入真正的音乐 Demo 与内容生产流程。
十三、HappyShrimp 和 Suno、Udio 这类 AI 音乐产品有什么区别?
提到 AI 音乐生成,很多人首先想到的可能还是:
Suno;
Udio。
HappyShrimp 进入的其实也是相同的大方向:
Text to Music / AI Song Generation。
但目前阿里公开介绍中反复强调的差异化重点主要有两个。
第一:自然语言理解
不要求用户一定先掌握大量音乐标签。
更强调:
情绪、故事、记忆和自然语言表达。
第二:完整歌曲结构
强调音乐中的:
Grammar;
Semantics;
Context;
Long-range Structure。
希望模型能够从全曲角度安排音乐,而不是只完成局部片段。
至于 HappyShrimp 与 Suno、Udio 在:
音质;
生成速度;
人声自然度;
风格覆盖;
版权规则;
商用授权;
编辑能力
等方面谁更适合具体用户,目前还需要更多长期实测,不能仅根据官方 Demo 下结论。
十四、上线首日就和太合音乐集团合作
HappyShrimp 上线的另一个重要动作,是与:
太合音乐集团 TAIHE MUSIC GROUP
展开合作。
阿里官方表示,双方会结合 HappyShrimp 的 AI 技术以及太合音乐在音乐产业生态方面的经验,探索包括:
Artist Co-creation
以及:
High-quality Content Development
等合作方向。
国内公开信息进一步披露,双方计划围绕:
音乐产业生态共建;
AI 音乐平台合作;
音乐人共创
等方向进行探索。
太合音乐集团本身业务覆盖音乐内容、艺人、版权、发行和演出等多个音乐产业环节。其官方网站目前也持续运营相关音乐业务。
这意味着 HappyShrimp 后续值得看的,不只是:
C 端用户能不能用 AI 玩音乐。
还包括:
AI 到底怎么进入真正的音乐产业。
十五、HappyShrimp 还将亮相 2026 阿那亚·虾米音乐节
这次合作还有一个非常有意思的线下场景。
根据目前公开信息:
2026 年 8 月 28 日至 30 日
HappyShrimp 计划亮相:
2026 阿那亚·虾米音乐节。
并会以音乐节为灵感,创作现场氛围音乐。
2026 阿那亚·虾米音乐节本身也已经定档 8 月 28 日至 30 日。
这其实是非常典型的一次 AI 音乐现实场景测试。
因为在网页里听一个 AI Demo:
效果不错。
和:
真正放到音乐节这样的现场环境中。
是完全不同的体验。
未来 AI 音乐能不能从:
“网页里生成一首歌”
进入:
现场;
影视;
游戏;
广告;
商业音乐内容。
这种合作会很值得继续观察。
十六、“快乐虾米”这个名字也很有意思
HappyShrimp 的中文名:
快乐虾米。
对于很多老互联网用户来说,“虾米”这个名字本身就天然带有很强的音乐记忆。
而且这次 HappyShrimp 又会出现在:
阿那亚·虾米音乐节。
从传播层面来说,整个品牌记忆非常直接:
Happy Shrimp。
快乐虾米。
AI 音乐。
几乎第一次看到就能记住。
不过需要区分的是:
HappyShrimp 当前是一款由阿里巴巴 Token Hub(ATH)业务团队开发的 AI 音乐生成模型。
十七、AI 音乐还有一个不能忽略的问题:版权和商用
如果只是:
自己玩;
生成生日歌;
发朋友圈;
测试音乐方向。
相对简单。
但如果要拿 HappyShrimp 生成内容去:
广告;
商业短片;
游戏;
影视;
音乐平台发行;
付费项目;
品牌 Campaign。
就必须认真关注:
版权和商业使用规则。
AI 音乐涉及的问题比普通生成文本复杂很多,包括:
训练数据;
生成音乐权利;
歌词;
声音;
特定艺人风格;
版权歌曲模仿;
商业授权。
截至目前公开的阿里 HappyShrimp 发布介绍,重点主要集中在模型生成能力,并没有在该页面详细说明全部商业授权细则。
所以如果要用于正式商业项目:
不要仅凭“AI 生成”就默认可以无限制商用。
最好以 HappyShrimp 最新:
用户协议;
版权规则;
商用条款
为准。
尤其不要直接要求 AI:
复制某位在世歌手的声音;
复刻某首受版权保护歌曲;
一比一模仿具体作品。
这是正式生产中必须提前考虑的一层。
十八、HappyShrimp 可以怎么写 Prompt?
它最适合的一种写法其实不是堆关键词。
而是:
场景 + 情绪 + 音乐方向 + 人声 + 结构变化。
例如:
创作一首中文都市流行歌曲。故事是一名 30 岁的男生凌晨下班后独自开车回家,城市刚刚下过雨,他突然意识到自己已经很久没有认真休息。整体不是悲伤,而是一种疲惫后的释然。男声,温暖克制,主歌使用钢琴和轻微电子氛围,副歌逐渐加入鼓和弦乐,最后一遍副歌情绪完全打开,但结尾重新回到安静。
这种 Prompt 已经非常接近:
给音乐制作人的 Brief。
而不是:
传统生成工具参数表。
十九、做短视频 BGM 可以这样说
如果你是视频创作者,可以更加直接:
为一段 60 秒的科技产品发布视频制作纯音乐。前 10 秒神秘克制,随后逐渐建立节奏,30 秒进入明显高潮,最后 10 秒留下干净、未来感的结束空间。电子音乐为主,不要人声,不要过于激烈,适合 AI 产品宣传片。
或者:
做一首适合东方神话巨构幻想短片的电影感纯音乐。开场非常空旷,有风声般的空间感,中段逐渐加入低沉鼓点和弦乐,后半段进入宏大高潮,但不要好莱坞式过度轰炸,整体保持神秘、庄严、朝圣感。
对于视频创作者来说:
这类“画面描述 → 音乐”的工作流非常值得尝试。
二十、AI 音乐正在从“标签生成”走向“创作意图生成”
我觉得 HappyShrimp 这次最值得关注的,其实不是又多了一个:
Text to Music 工具。
而是音乐生成的输入方式继续发生变化。
早期更像:
Genre
+
BPM
+
Instrument
+
Vocal
现在开始变成:
我想表达什么
+
这个故事是什么
+
情绪怎么变化
+
最后希望观众有什么感觉
然后 AI 自己再把这些创作意图翻译成:
旋律;
结构;
和声;
配器;
人声。
从操作逻辑来看:
Prompt 正在越来越像 Creative Brief。
这和 AI 图片、AI 视频的发展其实很像。
最开始要堆:
镜头;
参数;
风格词;
渲染关键词。
后来模型越来越强以后:
直接讲你想拍什么。
模型自己理解。
音乐也开始走这条路。
二十一、对普通人来说,它最大的意义可能就是“先做出来”
以前很多人都有过这种经历。
脑子里突然冒出来一句歌词。
或者一个故事。
甚至只是:
我好想把今天发生的事情写成一首歌。
但下一秒就放弃了。
因为不会:
乐理;
钢琴;
吉他;
编曲;
DAW;
录音;
混音。
现在 HappyShrimp 这样的 AI 音乐模型做的事情,就是把中间这堵墙压低。
你不一定因为用了 AI 就突然成为专业音乐人。
但至少:
你可以先把那首歌做出来听听。
这本身就已经很有价值。
结语
阿里这次推出的 HappyShrimp 1.0(快乐虾米),核心思路其实非常明确:
让音乐创作从专业参数输入,进一步走向自然语言表达。
用户不需要一定知道:
BPM;
Key;
Chord;
Instrumentation。
可以先说:
你的故事。
你的情绪。
你想象中的画面。
模型再继续完成:
作词 → 作曲 → 编曲 → 人声 → 完整歌曲。
HappyShrimp 当前已经支持完整人声歌曲、纯音乐以及用户自定义歌词等创作模式,并覆盖中国风、Pop、R&B、Hip-Hop、Rock、Electronic、Classical、Jazz 等多种音乐类型。
更值得关注的是,它并不只停留在普通用户的 AI 音乐生成工具。
上线首日,HappyShrimp 便宣布与太合音乐集团展开合作,双方将继续探索音乐人共创和音乐产业内容合作;8 月 28 日至 30 日,HappyShrimp 还计划亮相 2026 阿那亚·虾米音乐节。
从 AI 图片到 AI 视频。
现在连一整首歌,也开始越来越接近:
一句自然语言直接生成。
以后真正拉开 AI 创作工具差距的,可能不只是:
“能不能生成。”
而是:
它到底能不能听懂你真正想表达什么。
HappyShrimp 1.0 现在才刚刚 Beta。
后面在:
复杂指令控制;
音乐结构;
人声表现;
编辑能力;
版权;
商业化;
产业合作
这些方面还能走到哪里,值得继续关注。
相关链接
- HappyShrimp 国内官网 / 快乐虾米
https://www.happyshrimp.cn/ - HappyShrimp 国际版官网
https://www.happyshrimp.ai/
标签




评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。