
小红书发布开源多模态大模型dots.vlm1,NaViT视觉编码器领跑行业

AIGC资讯
2025-08-07浏览 365725 字 · 约 3 分钟
…
小红书发布开源多模态大模型dots.vlm1,NaViT视觉编码器引领行业发展
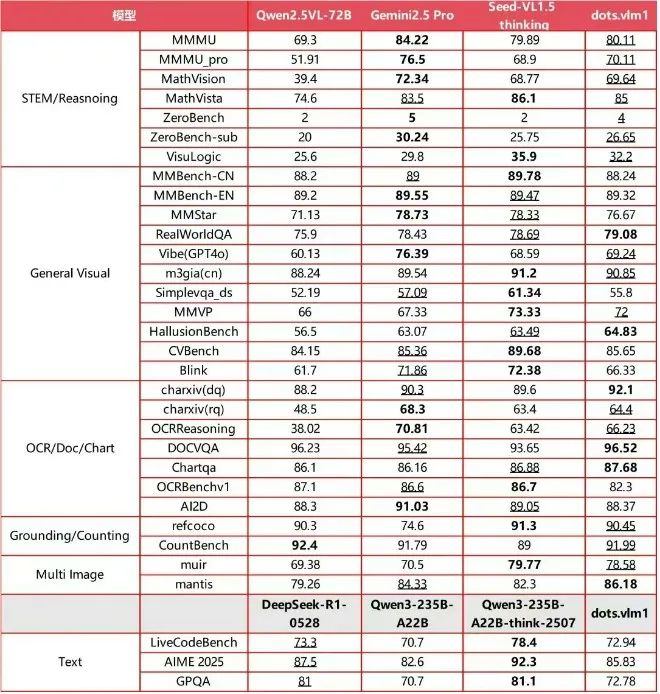
小红书Hi Lab近日发布了全新的开源多模态大模型dots.vlm1,该模型结合了NaViT视觉编码器和DeepSeek V3大语言模型,展现出了在多模态任务中的卓越性能。dots.vlm1在图表推理和STEM数学推理等领域的表现尤为突出,标志着开源多模态模型迈上了新台阶,进一步推动了视觉与语言融合的技术进步。
亮点提要:
- NaViT视觉编码器:dots.vlm1采用了原生自研的NaViT视觉编码器,该编码器支持动态分辨率,能够提升模型在多种视觉输入下的泛化能力。其在处理不同分辨率的图像时能够提供高效的性能,展现出其在多模态应用中的优势。
- 大规模清洗精细的训练集:该模型构建了一个大规模、清洗精细的训练集,以提升图文对齐的质量,从而在图像和文本之间实现更为准确的映射。通过精细的数据处理,dots.vlm1能够更好地理解和生成图像与文本的多模态内容。
- 与闭源模型的对比:在多模态评测中,dots.vlm1的表现接近闭源模型Gemini2.5Pro和Seed-VL1.5,为开源多模态模型的发展提供了新的里程碑。这一成绩展示了dots.vlm1在多模态任务中的强大能力,进一步证明了开源模型的竞争力。
数据对比表:dots.vlm1模型亮点对比
| 领域 | 传统多模态模型 | dots.vlm1开源多模态模型 | 提升幅度 |
|---|---|---|---|
| 视觉编码器 | 常规视觉编码器,固定分辨率 | 原生自研NaViT编码器,支持动态分辨率 | 提升了视觉输入的泛化能力 |
| 训练集质量 | 训练集较为简单,缺乏精细数据清洗 | 构建大规模清洗精细的训练集,提升图文对齐质量 | 提升了训练集的质量和效果 |
| 多模态评测表现 | 表现一般,较难接近闭源大模型 | 在多模态评测中接近Gemini2.5Pro和Seed-VL1.5 | 在多模态任务中展现了卓越性能 |
总结:
小红书发布的dots.vlm1开源多模态大模型,通过结合NaViT视觉编码器和DeepSeek V3大语言模型,推动了多模态技术的进一步发展。其在图表推理和STEM数学推理等领域的突出表现,不仅展示了模型在实际应用中的潜力,也证明了开源多模态模型在技术创新方面的巨大竞争力。随着dots.vlm1的发布,开源社区将在多模态领域迈向新的高度。
声明:本站所有文章,如无特殊说明或标注,均为本站作者原创发布。任何个人或组织,在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。本文来自作者自媒体,不代表UIED观点和立场。 如若本站内容侵犯了原著者的合法权益,可联系我们进行处理以减少您的损失。
标签



评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。