
百度开源文心5.5 Flash Base:2800亿参数,主打高效专业模型定制
…
大模型发布,大家通常先问两件事:好不好用,调用贵不贵。
但对于想做专业模型的团队,还有一个更实际的问题:
能不能不从零开始训练,也能按照自己的需求,把模型继续做下去?
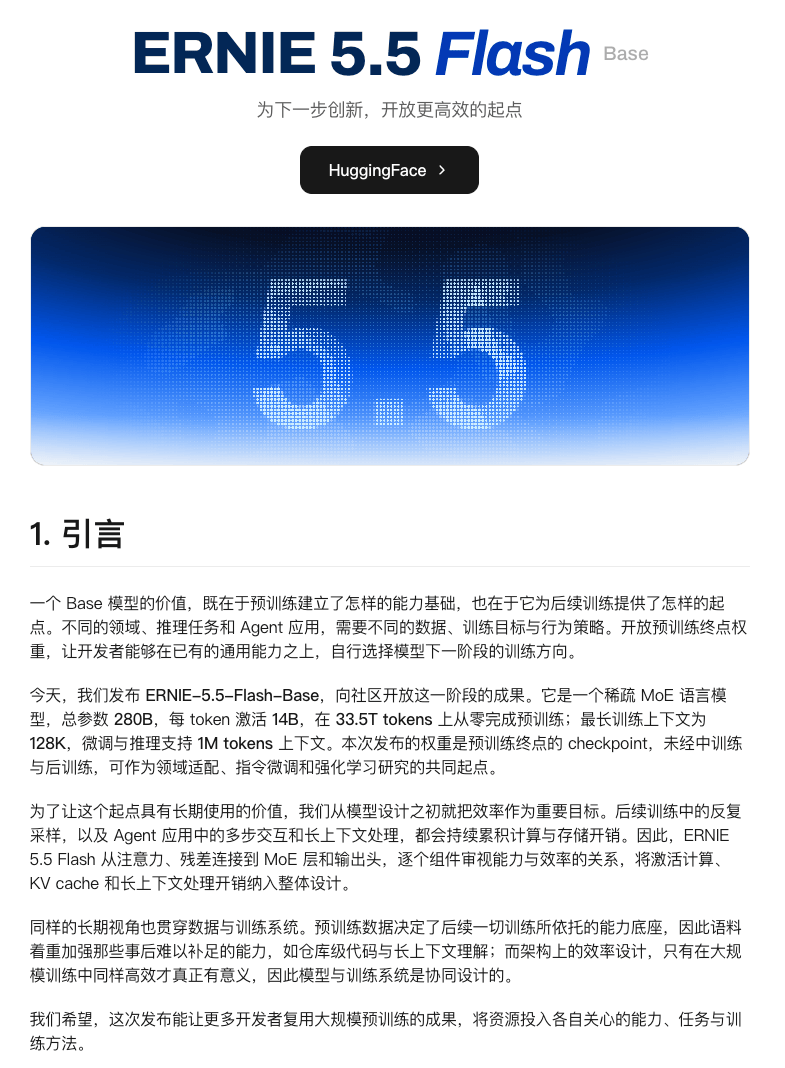
2026年11月5日,百度正式开放最新基座模型 文心5.5 Flash Base,英文名称ERNIE-5.5-Flash-Base。
这款模型采用MoE混合专家架构,总参数量达到2800亿,每个Token激活约140亿参数,使用33.5万亿Token完成预训练。
它的重点,不是给普通用户再增加一个聊天入口,而是向开发者开放已经完成预训练的模型权重,让后续的专业知识适配、指令微调和强化学习研究,有一个可以继续训练的起点。
别人已经完成的大规模预训练,开发者不必再从头做一遍。
不过,这次发布的是Base版本,不是经过完整后训练的聊天或Agent成品模型。看懂这一点,才能理解它真正适合谁。
01|Base是什么意思?它是模型开发的起点,不是即用型助手
很多人看到“开源大模型”,会下意识想到:下载以后,就能像聊天App一样直接使用。
但文心5.5 Flash Base的定位不同。
官方明确说明,此次开放的是预训练结束时的权重,尚未经过中训练和后训练。它主要面向需要进一步训练模型的开发者和研究团队。
可以用一个不完全严格的比喻理解:
通用聊天助手更像已经完成岗位培训、能够直接接待用户的员工;Base模型则更像已经具备广泛基础知识,但还没有按照具体岗位要求完成专项训练的人。
例如,一家团队希望模型理解自己的技术文档、代码规范和回答格式,就需要继续准备训练数据与评估任务,而不是只把公司名称写进提示词。
它开放的是进一步塑造模型的空间,不是承诺下载后就能完成所有工作。
此外,官方模型卡将本次版本标注为文本模型,不能因为文心系列还有其他多模态产品,就推定这个Base权重也支持图片、音频和视频输入。
02|2800亿参数只激活140亿,省在哪里?
文心5.5 Flash Base采用MoE,也就是混合专家架构。
模型内部包含多个专家模块。处理一个Token时,系统选择其中一部分参与计算,而不是让全部参数同时工作。
按照官方公布的数字计算,140亿约占2800亿的5%。
这也是稀疏模型值得关注的地方:保留较大的整体参数容量,同时控制每个Token需要执行的计算量。
但需要分清两个概念:
少量参数参与计算,不等于只需要存储这些参数。
运行模型时,整体权重、缓存和计算过程仍然需要占用资源。因此,不能把“140亿激活参数”理解为“只需要一台能运行140亿参数模型的电脑”。
对于准备部署的团队,应该分别评估权重存储、显存容量、上下文长度和并发需求,而不是只看激活参数。
这次的效率优化,也不只是MoE架构本身,而是进一步延伸到了注意力、专家选择和训练目标。
03|注意力优化:长内容不必在每一层都用同一种方式处理
文心5.5 Flash Base组合使用HCA与MLA等注意力机制。
大部分层通过HCA压缩历史信息,少数层保留更细粒度的上下文访问能力,并结合稀疏注意力减少不必要的计算。
可以把这个思路理解为:多数时候先看整理过的信息,需要时再查更细的内容。
它不是简单地把长文本截断,而是在不同层之间安排不同的信息处理方式,尝试平衡理解能力与缓存开销。
另一项容易引起误解的数据,是“门控参数减少75%”。
官方介绍,低秩门控注意力利用已有的低维表示计算门控,使门控投影的权重参数减少75%。
这里减少的是一个特定组件的参数,不是整个模型缩小75%,也不是部署费用直接降低75%。
如果要判断它最终能节省多少成本,还需要看完整模型在具体硬件、上下文和并发条件下的运行表现。
04|专家路由与ECHO:不仅算得少,还要把计算用在合适的地方
MoE模型有很多专家,但专家多,并不意味着每次都能选对。
文心5.5 Flash Base使用Multi-Router方案,由多个路由器共同参与专家选择,而不是完全依赖单一路由器的判断。
这些路由器可以形成不同偏好,减少某一次判断失误对最终选择的影响。按照官方说明,这项改动保持激活专家数量、专家计算量和通信量不变,重点改善选择质量。
可以类比为分配工作:
不是不断增加参与人数,而是在相同人数的条件下,尽量把任务分给更合适的人。
训练目标方面,模型还采用了ECHO。
它复用模型主干的最后一层预测后续Token,让预测未来内容的训练信号直接作用于主干参数;在推理时,这一层也可以参与投机解码,为生成过程提供候选内容。
一个方向是把专家选得更合适,另一个方向是让训练和推理复用更多已有能力。
这些技术不应被简单包装成“某个参数一改,所有任务立即提速”。它们的价值,需要放到完整系统中观察。
05|多项基准领先,但“同尺寸SOTA”不是全面第一
此次官方评测,主要比较了四款规模接近的Base模型:
文心5.5 Flash Base,以及DeepSeek-V4-Flash-Base、Hy3-preview-Base和MiMo-V2.5-Base。
百度说明,四款模型使用相同的评测框架、提示词和示例设置进行比较。
部分结果如下:
| 评测项目 | 文心5.5 Flash Base成绩 | 官方对比表中的表现 |
|---|---|---|
| MMLU-Pro | 78.4 | 四款模型中最高 |
| HumanEval+ | 82.3 | 四款模型中最高 |
| LiveCodeBench | 40.1 | 四款模型中最高 |
| LongBench-v2 | 48.7 | 四款模型中最高 |
| ChineseSimpleQA | 73.0 | 低于DeepSeek的75.3及Hy3的73.2 |
| FullStackBench | 54.6 | 低于Hy3的56.7 |
因此,更准确的说法是:
在百度公布的同规模基座模型比较中,文心5.5 Flash Base在多项评测上领先,但不是每项测试都第一。
这组结果也不能直接与经过不同后训练、使用不同工具和评测配置的聊天模型成绩混比。
对于准备继续训练的团队,Base评测能够帮助判断基础能力;对于普通用户,它不能直接回答“哪个聊天助手更好用”。
真正投入业务前,还需要建立自己的测试集,检查模型是否能处理实际输入、遵守输出格式,以及在困难案例中保持稳定。
06|支持百万Token上下文,但预训练长度要分开看
文心5.5 Flash Base的预训练上下文最高为128K,官方标注微调与推理支持最长约100万Token。
这两个数字描述的是不同阶段,不能写成“全程使用百万Token上下文预训练”。
更长的上下文,为处理大批文档、较大代码范围和复杂任务资料提供了空间。
但“能够输入很多内容”和“准确用好全部内容”,并不是同一件事。
假设一个代码分析任务同时放入需求、实现代码、历史日志和多份旧方案,模型仍然需要分辨哪些信息有效,哪些已经过时。
因此,整理资料仍有价值。长上下文可以保留更多必要背景,却不能自动替代清晰的任务说明。
部署时也一样。
支持百万Token,并不意味着默认配置就能跑满。推理文档要求根据硬件容量调整上下文长度、缓存和并发参数。
窗口变大了,资源需求和信息组织问题并不会随之消失。
07|适合用来做什么?专业模型定制比普通聊天更值得关注
文心5.5 Flash Base最直接的用途,是作为后续训练的基础。
以下几个方向,可以作为开发团队评估时的参考,并不代表下载模型后就已经具备相应产品能力。
企业文档与专业术语适配
例如,一家企业有大量内部流程、产品说明和技术资料,希望模型更好地理解特定术语与表达方式。
可以研究通过领域数据和任务样例进行适配,再检查准确率和输出稳定性。
但不应该默认所有企业资料都需要写入模型权重。对于经常变化的信息,也应比较知识检索、提示词配置与微调等不同方案。
面向特定代码库的开发辅助
有些团队希望模型遵守自己的代码规范,理解项目结构,并输出符合内部要求的修改建议。
这类需求不只是“生成一段代码”,还涉及样例质量、测试方法和错误反馈。
基座模型提供了训练起点,真正的工程能力仍然需要后续建设。
垂直内容与结构化输出
例如,希望模型按照固定栏目整理资料,或者将非结构化文本转换成约定格式。
评估时不能只看语言是否流畅,还要检查字段是否完整、内容是否准确,以及输入变化后能否继续遵守规则。
强化学习与Agent研究
研究团队可以在同一基座上比较不同训练目标、反馈机制和任务设计。
但完整Agent还需要工具、权限、执行环境和结果验证,不能把一个Base权重直接等同于可持续运行的智能体。
开源基座减少的是从零预训练的重复投入,不是替开发者完成全部产品工程。
08|模型在哪里下载?部署前先确认这几件事
目前,官方提供Hugging Face和魔搭社区入口,并开放FP8与BF16两种精度的权重。
推理部署支持SGLang和vLLM,相关文档已经提供专门配置。
不过,它仍然是一款大规模模型。
按照推理文档中的近似权重体积,FP8约为280GB,BF16约为560GB;运行时还需要额外空间存放缓存和中间结果。
因此,不宜把它宣传成普通个人电脑下载后即可轻松运行的模型。
对于准备测试的团队,可以先明确精度、上下文和并发目标,再选择对应部署方案。先验证基本推理,再扩大输入长度,比一开始就开启最高配置更容易定位问题。
还有一个关键细节:
Base版本主要通过文本补全接口使用,不应直接套用已经完成聊天、推理和工具调用后训练的模型配置。
官方表示,经过后训练的ERNIE 5.5 Flash将随后推出。它与此次发布的Base版本,应当分开理解。
09|开放权重不等于无限制商用,许可证需要单独看
文心5.5 Flash Base采用 ERNIE 5.5 Flash Base Model License Agreement v1.0,不是MIT或Apache 2.0许可证。
协议对商业使用、标识展示、通知、收入门槛和地域范围等设置了条件。
因此,“权重可以下载”不能直接改写成“所有个人和企业都能在任何地区无限制商用”。
准备对外提供API、销售相关产品,或者发布衍生模型的团队,应先核对具体条款,而不是只根据新闻标题判断授权范围。
同时,开放权重也不意味着全部训练数据和完整训练过程同步公开。
对使用者来说,最实际的检查方式,是分别确认拿到了哪些文件、允许怎样使用,以及后续分发或商业服务需要履行什么要求。
总结|这次不是多一个聊天入口,而是多一个模型开发起点
文心5.5 Flash Base最值得关注的,并不是2800亿参数这个数字本身。
它把稀疏计算、长上下文处理、专家路由和训练目标放在一起优化,再将预训练结束时的权重交给开发者。
对于研究团队和需要专业模型的企业,这意味着可以把更多精力放在自己的数据、任务与训练方法上,而不必重复承担完整的预训练过程。
但基础能力强,不代表业务模型已经完成;激活参数少,也不代表部署没有门槛。
最终需要验证的,仍然是训练后能否解决实际问题,以及这份能力能否以可接受的成本稳定运行。
普通用户关心AI能替自己做什么,开发者还关心:能不能把AI继续训练成自己真正需要的样子。
这正是文心5.5 Flash Base此次开放的价值所在。
文心5.5 Flash Base官方技术介绍
https://ernie.baidu.com/release/ernie-5-5-flash-base/
标签
评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。