
腾讯混元发布Hyra 2.0:AI不只会解题,还开始自己造科研工具
…
以前把一道难题交给AI,期待的是一个答案。
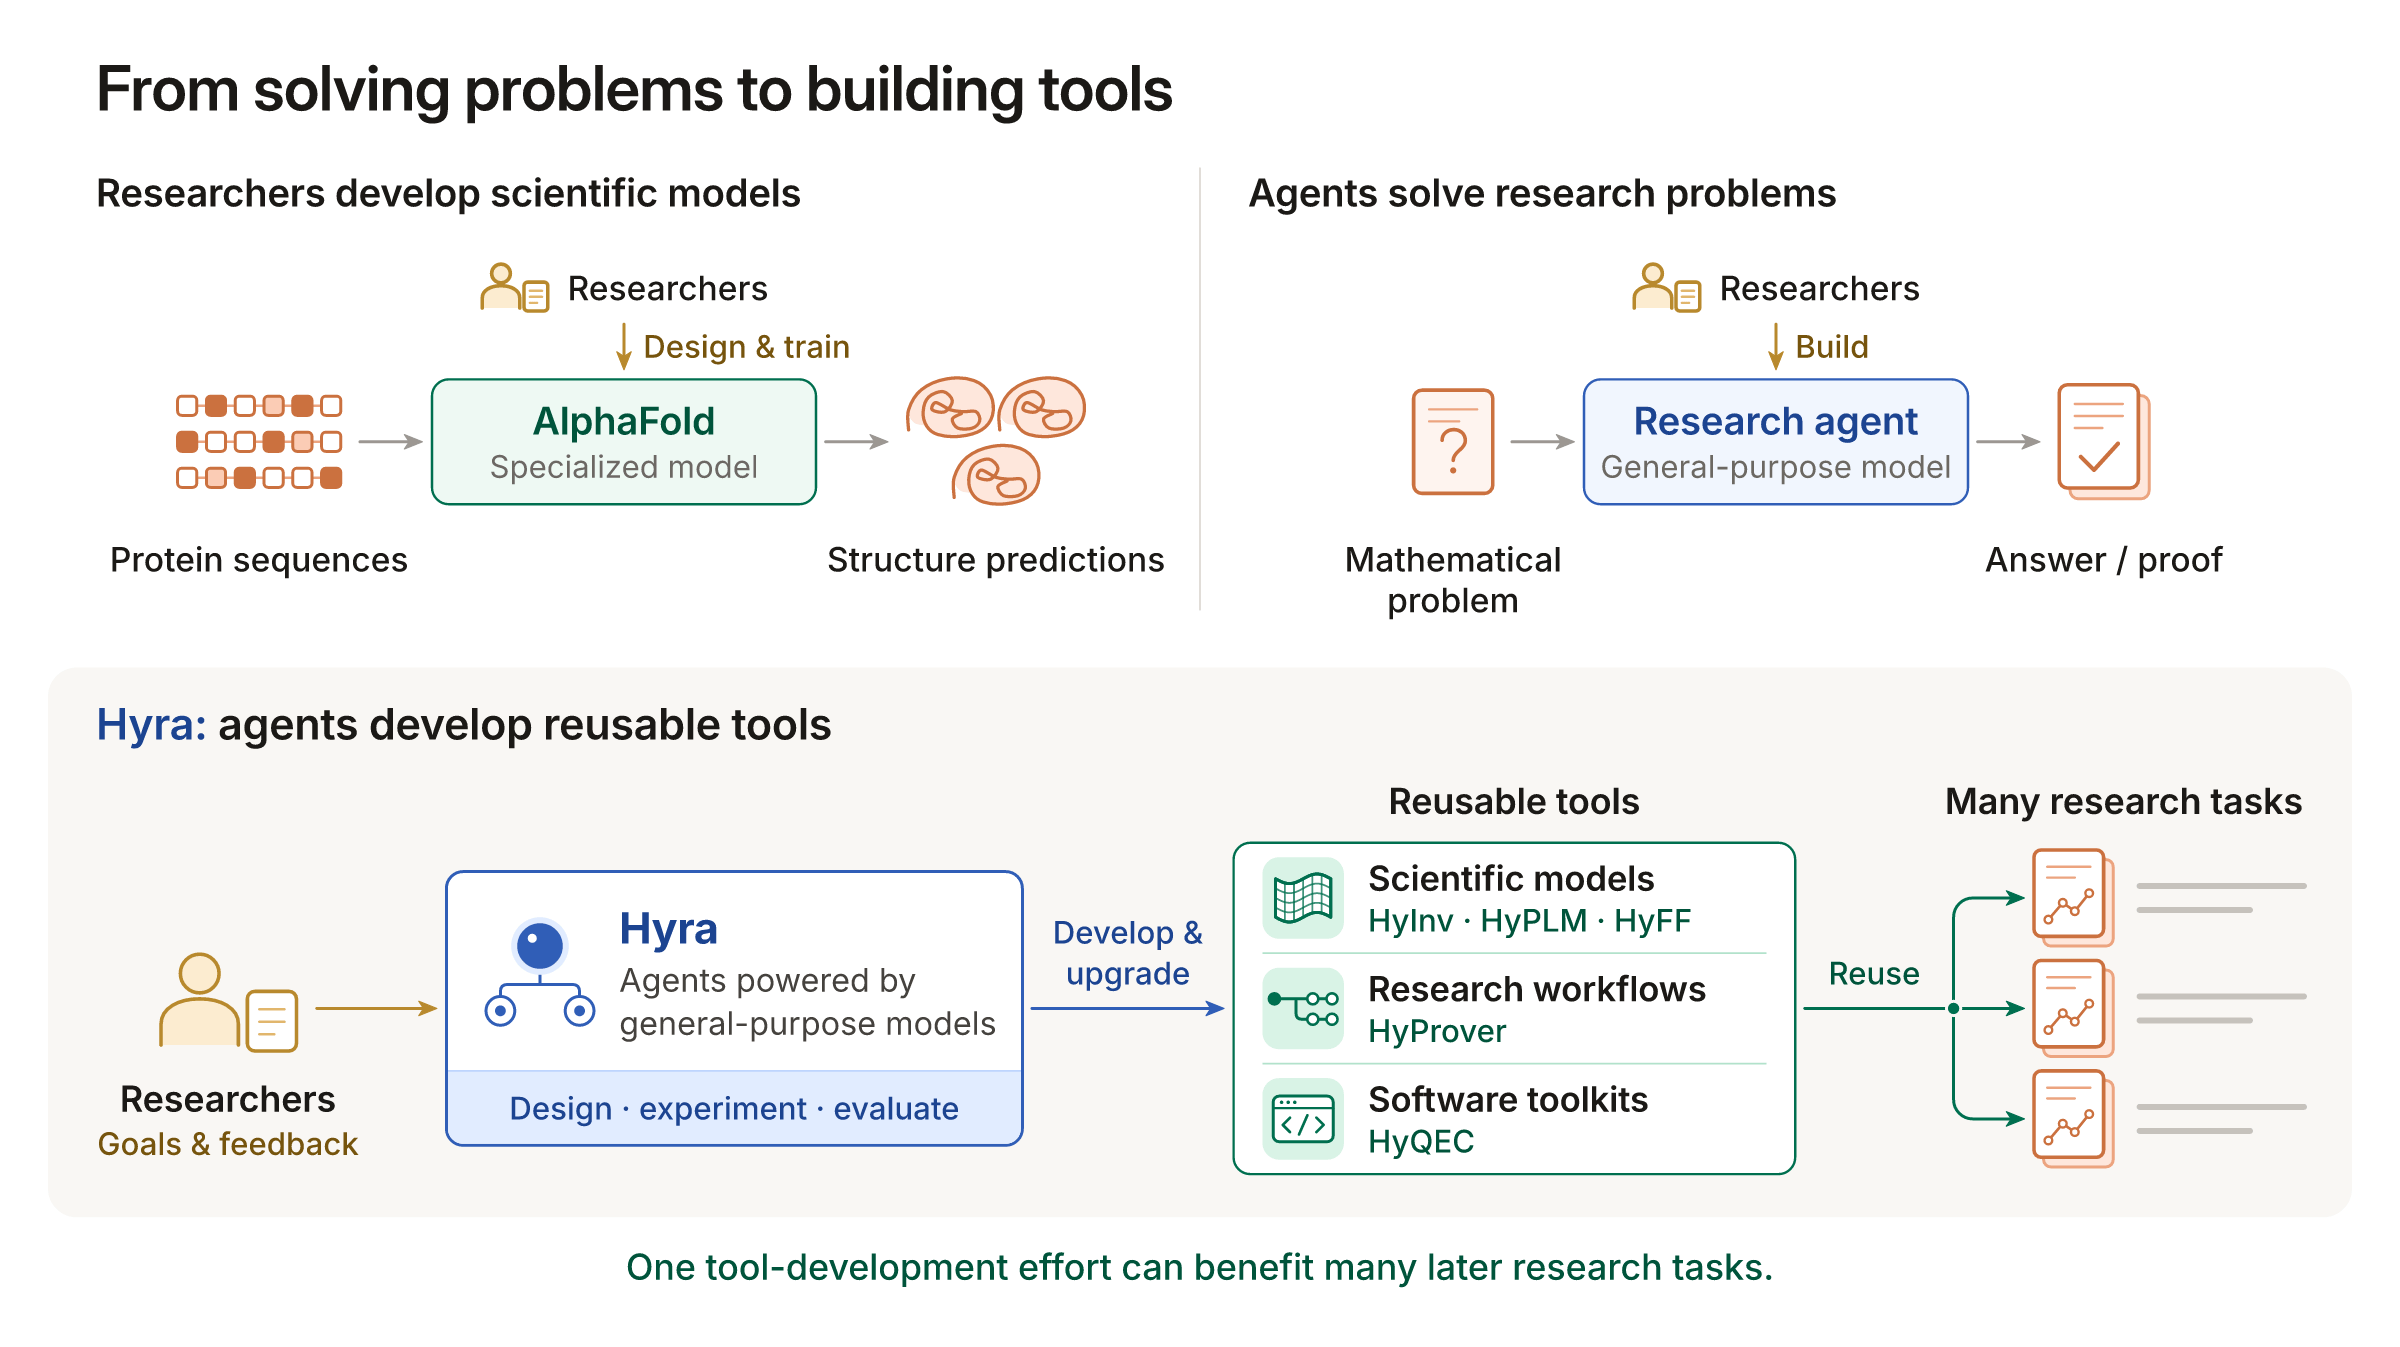
现在,腾讯混元提出了一个更长线的目标:让AI把解决问题需要的工具,也研发出来。
2026年11月2日,腾讯混元发布AI科研系统 Hyra 2.0,将重点从解决单个科研问题,推进到研发可以反复使用的科学模型、研究流程和软件工具。
这次更新,不是让AI多写几份研究报告,也不是简单增加几个自动执行任务的按钮。
它希望让Agent参与模型设计、代码实现、实验分析和结果验证,把一次研究中得到的方法,变成下一次研究能够直接使用的能力。
从蛋白质模型到量子纠错,从机器人结构到芯片优化,Hyra 2.0已经展示了多个方向的初步成果。
真正值得关注的,不只是AI这次完成了什么,而是它为下一次研究留下了什么。
01|Hyra 2.0是什么?不是新聊天模型,而是一套科研Agent系统
Hyra是Hunyuan Research Agent,也就是混元研究智能体。
理解Hyra 2.0,可以先区分两种工作方式。
第一种,是让AI解决一个具体问题。任务完成以后,留下答案、代码或者分析结果。
第二种,是让AI研发解决一类问题的工具。成果可能是一套验证程序、一个科学模型,或者经过测试的实验流程。
举个容易理解的例子。
让AI帮忙分析一次程序性能,得到的是一份优化建议。
如果AI进一步开发了可以重复运行的测试工具,并把有效的优化方法整理下来,那么后续项目也能使用这些成果,不必每次从零开始。
Hyra 2.0强调的,就是第二种方向。
这里的“工具”也不局限于脚本和软件。训练完成的蛋白质模型、分子模拟模型,同样可以成为研究者或其他Agent调用的工具。
从完成一次任务,到改善后续完成任务的方法,这才是这次升级的核心。
02|三层Agent分工,让长期研究不再挤进一个聊天窗口
如果一个项目需要持续数天甚至数周,只靠不断延长的对话,很难清楚管理所有工作。
哪些实验已经完成,哪些假设被排除,哪些结果需要复核,都会影响后续决策。
Hyra 2.0采用了三层分工。
Overall负责对齐目标。 它与人类研究者沟通,协调项目优先级、资源和关键决策。
Mission负责研究路线。 每个Mission长期跟进一个研究问题,安排实验、组织执行,并判断是否需要调整方向。
Worker负责具体探索。 它可以阅读代码、执行实验、分析失败原因,也可以对已有判断提出不同意见。
这套组织方式不是单纯“多开几个AI窗口”,而是让不同层级分别处理目标、路线和执行。
系统还通过持久化任务队列安排工作,并在Research Board研究看板中记录进展。一项任务等待实验结果时,其他任务可以继续推进。
对于实际研发来说,这种设计的意义很直接:等待不应该让整个项目停下来,信息也不应该只留在某个临时对话里。
03|AI说“做完了”还不够,结果需要证据和复核
科研Agent最需要警惕的,不是表达不够流畅,而是把不可靠的结果说得过于确定。
Hyra 2.0要求执行结果附带代码版本、实验记录或日志等证据,并通过独立的Review Worker进行复核。
这意味着,“任务完成”和“结论成立”不是同一件事。
例如,一次性能测试变快了,还需要继续检查:是否改变了精度要求,是否遗漏了某些输入,或者是否只是特定条件下的偶然结果。
独立复核的价值,就在于重新检查证据能够支持多大的结论,而不是只替前一个Agent润色报告。
与此同时,Hyra 2.0将项目状态、Agent工作记忆和跨任务经验分开保存,并把可迁移的方法整理成Skill。
这里的Skill,更适合理解为可重复使用的方法与流程,而不是一次成功回答的收藏。
当然,增加复核并不代表错误会自动消失。真正重要的是,错误能否被发现、记录和纠正,而不是被下一项任务继续沿用。
04|七个研究方向,Hyra 2.0已经做出了哪些东西?
这次发布覆盖了七个主要研究方向,但它们的成果形态并不相同:有的是已经提供代码和权重的模型,有的是工作流或验证工具,还有的仍处于仿真阶段。
因此,不能把所有结果都理解为已经完成商业落地。
1. HyInv:从蛋白质结构出发,设计候选序列
HyInv是一款约196万参数的蛋白质逆折叠模型,由Hyra 2.0训练。
它处理的问题是:给定目标蛋白质骨架,生成可能与这一结构匹配的氨基酸序列。
模型采用先生成初稿、再修改序列的采样方式,公开项目提供权重、命令行工具和Python调用方式,并支持CPU与GPU运行。
在项目列出的H20测试条件下,针对402个残基的目标,一次生成128条候选序列,BF16加速路径耗时约54毫秒,不包含首次编译和图捕获时间。
这个数字说明的是特定配置下的生成效率,不能直接当成所有设备的速度,也不代表候选序列的实际功能已经得到实验确认。
2. HyPLM-Flash:训练更高效的蛋白质语言模型
HyPLM-Flash是一款6.5亿参数的蛋白质语言模型,能够把蛋白质序列转化为可用于后续分析的表示。
它的“语言”是蛋白质序列,不是面向用户聊天的自然语言。
官方项目说明显示,其推理引擎在单张H20上可处理约每秒13万个残基,具体吞吐量仍受到输入和运行配置影响。
相比只完成一次序列分析,训练一个可以重复调用的模型,能够为后续大量分析任务提供基础能力。
这也是Hyra 2.0“研发工具”思路比较直观的体现。
3. HyFF:为分子模拟提供可复用的力场模型
HyFF是一组面向分子模拟的机器学习力场模型。
它根据原子的种类、位置等信息预测能量与受力,为分子动力学计算提供支持。
公开项目包含五种规模,参数量约从230万到12亿,覆盖83种元素,并提供推理、分子动力学和批量预测工具。
不同规模对应不同的精度与计算开销选择,研究者可以根据任务决定使用哪一种模型。
需要注意,项目性能测试有明确的硬件、数据集和模拟条件,不能直接推导为所有分子体系都会获得相同的加速效果。
4. HyProver:把数学探索组织成工作流
HyProver面向数学证明任务,重点不是一次性输出一段看起来完整的证明,而是组织探索、推理和复核过程。
官方成果仓库已经列出五维Petty等距点猜想的结果,以及圆作用猜想非限定形式的反例。
这里尤其需要尊重问题的具体条件。例如,后者不能被扩大解释为同时解决了单连通版本。
对于数学研究工具,表达得像证明并不够,关键仍是论证是否成立、适用条件是否清楚,以及能否接受进一步检查。
5. HyQEC:既构造量子纠错码,也检查结果
HyQEC面向量子纠错码的构造与验证。
它的价值不只在于提出新的候选方案,还包括检查码距等关键性质,为不同方案的比较提供依据。
这属于量子计算相关的软件和算法工具研究,不能直接理解为发布了一颗量子芯片,或者已经解决全部量子纠错问题。
6. 机器人灵巧手:探索结构与控制策略的组合
在机器人方向,Hyra 2.0探索了一种被称为“旋梯手”的五指结构。
这个案例值得关注的地方,是把机械结构与训练后的控制效果放在一起考虑,而不是只比较初始表现。
但其公开结果仍来自仿真评测,尚未经过真机验证。
因此,更准确的说法是AI探索出了有潜力的结构方案,而不是已经交付了可以直接投入生产的机器人产品。
7. 香山处理器:参与性能优化与正确性验证
在芯片研发方向,Hyra 2.0围绕开源RISC-V处理器项目香山开展了性能调优和正确性检查。
这类工作不只是生成代码,还需要证明修改后是否更快,以及是否引入新的错误。
对于处理器研发,性能提升和行为正确同样重要。某个基准表现更好,也不能直接等同于所有实际应用都会获得相同收益。
05|可复用Skill为什么重要?别让每次实验都从零开始
七个方向看起来差异很大,但它们有一个共同点:研究成果可以成为后续任务的起点。
这也是“智能复利”比较容易理解的含义。
假设某个项目发现了一套有效的训练故障排查流程。如果只把它留在聊天记录里,下一次遇到相似问题时,团队仍可能重复尝试。
但如果把适用条件、检查步骤、判断标准和失败情况整理成可执行流程,后续任务就有机会少走弯路。
同样,优化一个被频繁调用的模型,收益也不只发生在发布当天,而可能体现在之后的多次调用中。
不过,经验复用还有一个前提:知道什么时候能用,什么时候不能用。
只保存“这个方法有效”,却没有记录硬件、数据和实验条件,反而可能把局部经验变成错误的通用规则。
所以,Skill的价值不应该只看数量,更应该看是否可复现、是否写清适用范围,以及能否随着新证据更新。
另外,把经验保存为Skill,并不等于底层大模型权重已经实时更新。这是工作流程和外部知识的积累,需要与模型训练层面的变化区分开。
06|Hyra 2.0开源了吗?先分清系统与研究成果
对于开发者来说,最关心的问题之一,就是能不能下载使用。
目前可以直接确认的公开入口,是腾讯混元的研究介绍与Hyra-results成果仓库。
仓库已经提供HyInv、HyPLM-Flash、HyFF等模型的代码、权重获取方式和技术资料,也收录了其他研究产物。
但需要区分:
研究成果公开,不等于完整Hyra 2.0科研系统已经以同样形式开放。
能够下载一个蛋白质模型,并不代表同时获得了论文介绍中的任务调度、实验平台连接、团队协作和全部Agent运行环境。
对有明确需求的开发者,比较合理的起点,是选择一个具体成果,按照对应说明验证,而不是期待下载仓库后就能自动完成任意科研项目。
例如,HyInv可以从一个符合要求的结构文件开始测试;HyPLM-Flash需要准备相应GPU环境;HyFF则应先核对输入格式和模拟配置。
如果主要关注Agent开发方法,则可以研究三层分工、独立复核和经验积累的设计,再结合自己的业务验证,不能默认这些能力已经可以一键部署。
07|真正落地,还要过稳定性、成本和权限这几关
Hyra 2.0展示了工具研发的可能性,但要判断它能在多大程度上进入长期工作,还需要看几个现实问题。
长期任务能否持续保持方向?
一个项目运行数天以后,系统是否还记得最初目标?遇到连续失败,能否区分应该换方法,还是实验配置有问题?
这需要通过完整项目检验,不能只看某次成功演示。
换一个研究领域,还能否保持效果?
能在已有评测和工具条件下取得进展,不代表可以直接迁移到所有领域。
数据质量、反馈速度和验证难度不同,都会影响Agent能否有效推进工作。
整体成本是否划算?
评估自动化科研,不应只计算模型调用价格。
实验算力、失败尝试、人工复核和维护工具的投入,都属于成本。研发出的工具是否会被后续项目反复使用,也会影响这笔投入是否值得。
权限和研究资料怎样管理?
当Agent能够执行代码、提交训练任务、修改仓库时,就需要限制它能访问什么、能花多少资源,以及哪些操作必须经过确认。
对团队而言,更稳妥的原则是从受控环境和明确任务开始,再根据实际效果扩大范围,而不是一次开放全部权限。
08|Hyra 2.0常见问题
Hyra 2.0是一款新大模型吗?
更准确地说,它是一套AI科研智能体系统,关注如何组织模型、工具、实验和验证流程。它研发出的HyInv、HyPLM-Flash等,才是不同用途的具体模型。
Hyra 2.0能直接替代研究人员吗?
现有成果不能支持这样的结论。研究目标、评价标准、关键决策和结果验收仍然重要,Agent参与更多环节,也不代表人类可以完全退出。
普通用户可以像聊天App一样使用吗?
目前公开资料主要面向研究成果与技术方法,不宜把它理解为已经提供一键完成科研的消费级应用。具体模型是否适合使用,需要查看对应项目要求。
七个方向的成果都已经完全开放了吗?
不能这样理解。各项成果的公开程度和验证阶段不同,应分别检查代码、权重、报告与后续发布安排,不能只根据发布文章中的名称判断。
总结|AI这次不只交答案,也开始留下下一次能用的能力
腾讯混元Hyra 2.0最值得关注的,不是又增加了多少个Agent。
而是它尝试改变AI参与研究后的产出形式:除了答案,还留下模型、验证工具和可以反复执行的方法。
一次研究能够推动后续多次研究,才有机会把重复投入变成持续积累。
当然,模型指标、仿真成绩和特定基准上的进展,都需要放在各自条件下理解。是否能跨项目稳定复用,仍然要接受更多实际验证。
以前评价AI科研,常问“它解出了什么”。现在还值得多问一句:这次完成以后,下一次研究是不是更容易了?
这才是Hyra 2.0从解题走向工具研发,最有价值的地方。
腾讯混元Hyra 2.0官方研究介绍
https://hy.tencent.com/research/hyra2
Hyra官方研究介绍
https://hy.tencent.com/research/hyra
Hyra研究成果GitHub仓库
https://github.com/Tencent-Hunyuan/Hyra-results
HyInv蛋白质逆折叠模型说明
https://github.com/Tencent-Hunyuan/Hyra-results/blob/main/AI4Science/hyinv/README.md
HyPLM-Flash蛋白质语言模型说明
https://github.com/Tencent-Hunyuan/Hyra-results/blob/main/AI4Science/hyplm_flash/README.md
HyFF分子模拟模型说明
https://github.com/Tencent-Hunyuan/Hyra-results/blob/main/AI4Science/hyff/README.md
标签
评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。