
DeepSeek 把联网搜索正式做成 API:搜索、抓网页每千次 5 元,Agent 联网开始按次计费
…
DeepSeek 这次开放的不是一个新聊天功能。
而是把 Agent 最常用的两种联网能力,正式拆成了可以独立调用的 API:
Search。
以及:
Fetch。
Search 负责:
从互联网寻找页面。
Fetch 负责:
进入指定页面,把正文抓回来。
以前开发者想给 Agent 加联网能力,通常还需要自己接入:
搜索引擎;
网页抓取服务;
正文清洗工具;
结果排序系统。
现在只需要使用原来的 DeepSeek API Key,就可以同时调用搜索与网页抓取能力。
对于研究 Agent、Coding Agent、企业知识库和实时信息应用来说,这相当于补上了一条完整链路:
用户提出问题
↓
Agent判断需要联网
↓
Search寻找相关页面
↓
筛选高质量来源
↓
Fetch抓取网页正文
↓
模型分析与交叉核验
↓
生成带依据的结果
DeepSeek 正在把“联网”从模型内部的一项隐藏能力,变成开发者可以直接控制、计量和组合的基础服务。DeepSeek API Docs
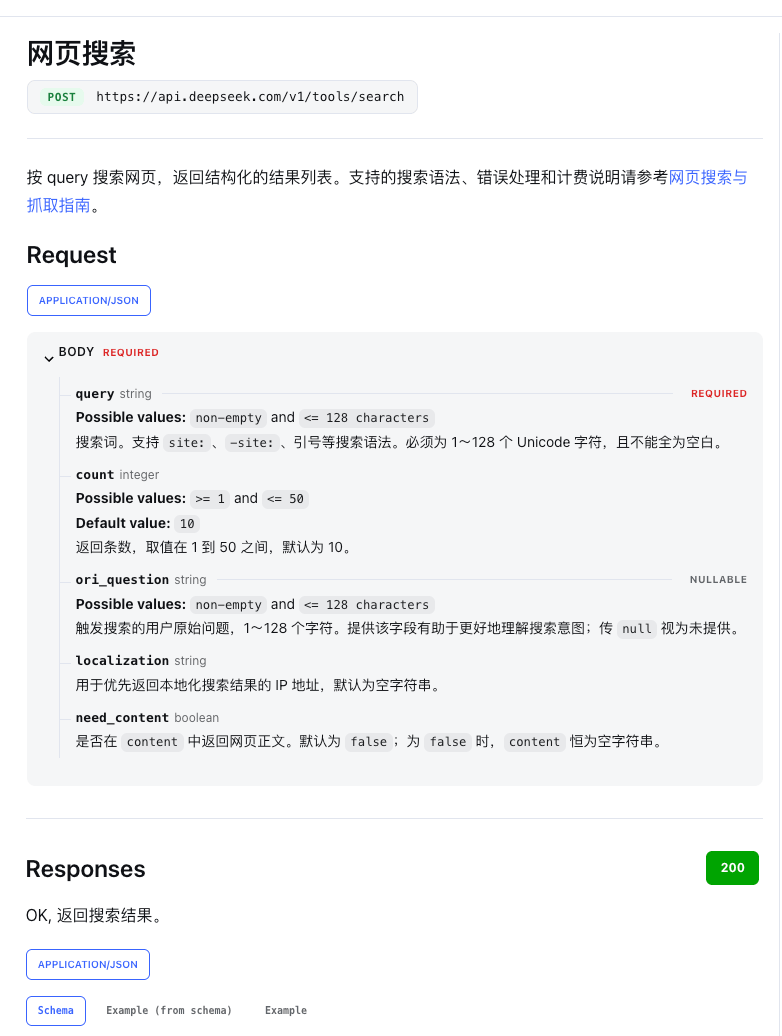
一、Search API:先帮 Agent 找到网页
Search API 负责根据查询词检索互联网内容。
官方接口地址为:
POST /v1/tools/search开发者可以提交:
查询关键词;
需要返回的结果数量;
用户原始问题;
本地化信息;
是否需要同时返回网页正文。
搜索结果不仅包含普通的标题和网址,还会返回:
摘要;
长摘要;
页面发布时间;
站点名称;
相关性评分;
网页权威度;
可选正文内容。
其中,count 可以控制一次返回 1~50 条结果。
如果开启:
"need_content": trueSearch 还会尝试直接返回搜索结果对应的页面正文,不一定每次都要再调用 Fetch。DeepSeek API Docs
例如:
curl https://api.deepseek.com/v1/tools/search \
  -H "Authorization: Bearer <DeepSeek API Key>" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "2026 AI Agent 市场报告",
    "count": 10,
    "need_content": true
  }'
Agent 可以先根据结果中的:
相关性;
权威度;
发布时间;
摘要
进行筛选,再决定哪些来源值得深入阅读。
二、Fetch API:把指定网页变成 Markdown
Search 解决的是:
哪些网页可能有答案。
Fetch 解决的是:
把其中某个页面真正读回来。
官方接口地址为:
POST /v1/tools/fetch开发者只需要提交一个网页地址:
curl https://api.deepseek.com/v1/tools/fetch \
  -H "Authorization: Bearer <DeepSeek API Key>" \
  -H "Content-Type: application/json" \
  -d '{
    "url": "https://example.com/article"
  }'
成功后,接口会返回:
页面标题;
经过提取和清洗的 Markdown 正文。
这比直接把网页原始 HTML 交给大模型更加适合 Agent。
因为普通网页中通常包含:
导航栏;
广告;
推荐内容;
脚本;
样式;
页脚;
弹窗。
这些内容会浪费 Token,也会干扰模型理解。
Fetch 的作用,就是尽量把网页转换成更适合大模型阅读的结构化文本。抓取结果仍会受到目标网站是否在线、是否允许访问以及网页是否存在可提取正文等因素影响。DeepSeek API Docs
三、Search 和 Fetch 为什么要拆成两个接口?
很多人可能会问:
既然 Search 已经能够返回网页内容,为什么还要单独提供 Fetch?
因为两者承担的任务不同。
Search 更适合广泛寻找
例如:
最近有哪些公司发布了新的 AI 编程工具?
系统需要先获得一批候选页面,再判断哪些结果相关。
Fetch 更适合精准阅读
例如:
读取这个产品的官方价格页面,整理所有套餐差异。
用户已经给出了明确网址,不需要再进行搜索。
两者组合更适合研究任务
例如:
Search搜索20条结果
↓
根据标题、摘要和权威度筛选5条
↓
Fetch抓取5个网页
↓
模型交叉核验
↓
形成研究结论
如果每一条搜索结果都无条件抓取全文,成本和 Token 消耗都会明显增加。
拆成两个接口后,开发者可以自己决定:
哪些内容只需要看摘要。
哪些网页值得继续抓取正文。
这对大规模 Agent 应用更加灵活。
四、价格到底怎么算?
国内官方价格为:
Search
每1000次成功请求:5元

Fetch
每1000次成功请求:5元
也就是说,每一次成功请求约为:
5 ÷ 1000
= 0.005元
如果一次任务执行:
1次Search
+
5次Fetch
接口调用成本约为:
6 × 0.005
= 0.03元
如果一个企业每天产生 10 万次成功 Search 请求:
100000 ÷ 1000 × 5
= 500元
需要注意,Search 和 Fetch 分别收费。
模型后续对结果进行:
摘要;
分析;
推理;
生成回答
产生的输入、输出 Token,还要按照对应 DeepSeek 模型价格另行计算。DeepSeek API Docs
五、一次 Search 返回 50 条,也只算一次
Search API 的 count 参数可以设置为:
1~50。
无论一次返回 5 条还是 50 条,只要请求成功并产生非空结果,都是按照一次 Search 请求计费。
这意味着开发者不需要因为担心接口费用,刻意把一次搜索拆成多次小请求。
例如:
{
  "query": "DeepSeek Agent after:2026-01-01",
  "count": 50
}
这仍然只是一条成功 Search 请求。
不过,返回的搜索结果越多,后续交给模型的内容也可能越长。
虽然 Search API 成本不变,但模型 Token 成本可能提高。
所以更加合理的做法是:
搜索阶段尽量拿够候选结果。
模型阶段只保留真正相关的部分。DeepSeek API Docs
六、哪些请求不会收费?
DeepSeek 官方计费规则写得比较明确。
只有同时满足下面两个条件才计费:
返回HTTP 200
+
真正产生有效结果
具体来说:
Search
必须返回非空的 results 数组。
如果正常搜索但没有找到结果,返回空数组,不计费。
Fetch
必须成功返回网页正文。
如果页面无法访问、被网站策略阻止、格式不支持或没有可提取内容,不计费。
以下情况同样不计费:
请求失败;
空搜索结果;
超时;
服务端错误。
这个规则对 Agent 很重要。
因为自动化任务中,网页失效、页面被删除、目标网站拒绝抓取都很常见。
开发者不需要为没有获得任何有效结果的请求继续支付调用费用。DeepSeek API Docs
七、免费过渡期到底覆盖什么?
目前 DeepSeek 官方明确写明:
通过以下工具使用 DeepSeek API 时,由服务端工具触发的 Search 与 Fetch 请求暂时免费:
DeepSeek Harness。
Claude Code。
Codex。
免费期结束时间为:
2026 年 11 月 1 日 00:00,北京时间。
对应 UTC 时间为:
2026 年 10 月 31 日 16:00。
从这个时间开始,相关服务端搜索和抓取请求会按照成功次数计费。DeepSeek API Docs
这里需要特别区分:
免费的是这些客户端中的服务端工具调用。
不要直接扩大成:
所有人直接调用 Search / Fetch API 都在 11 月前永久免费。
独立 API 已经拥有正式价格页和扣费规则,开发者应以账户控制台和实时计费页面为准。DeepSeek API Docs
八、联网一次,不只产生搜索接口费用
以 Claude Code 为例。
当模型判断任务需要联网时,会调用 DeepSeek Search API。
获得搜索结果后,模型还需要:
阅读搜索内容;
筛选来源;
总结信息;
生成最终回答。
这些步骤会继续产生大模型输入与输出 Token。
所以完整成本通常包括两部分:
Search / Fetch请求费
+
模型Token费
比如 Agent 先搜索一次,再抓取五个长网页。
Search 与 Fetch 的接口费用可能只有 0.03 元。
但如果五个网页正文非常长,模型需要处理几十万 Token,最终大头可能反而来自模型调用。
因此,开发者优化成本时不能只盯:
每千次5元。
还要控制:
抓取多少网页;
每个网页保留多少正文;
是否需要全文;
能不能先用摘要筛选;
相同内容是否可以缓存。DeepSeek API Docs
九、官方搜索结果还会返回权威度和相关性评分
Search API 返回的结果中,有两个比较适合 Agent 使用的字段:
rerank_score
范围为:
0~3。
它综合考虑相关性、权威性和时效性。
官方文档表示,1.5 及以上通常可视为高质量结果。
authority
范围为:
0~4。
用于表示页面的权威等级。
3 及以上通常代表较高权威来源。
这两个字段让 Agent 不必只依赖标题关键词判断页面质量。
例如面对医疗、法律或金融问题时,系统可以优先选择:
官方机构;
研究论文;
公司公告;
权威媒体。
再减少论坛、聚合站和低质量内容在最终结果中的占比。DeepSeek API Docs
十、支持搜索语法,Agent 可以主动缩小范围
DeepSeek Search 支持多种搜索操作符。
包括:
site:
-site:
"精确短语"
-排除关键词
lang:
after:
before:
例如只搜索官方 GitHub 和 Hugging Face:
DeepSeek site:github.com OR site:huggingface.co只寻找 2026 年以后发布的英文内容:
AI Agent lang:en after:2026-01-01排除广告和营销内容:
AI Coding -advertisement -"sponsored post"这些操作符可以帮助 Agent 在搜索阶段就缩小范围。
相比先拿回大量低质量网页,再让模型花 Token 过滤,直接写好搜索条件通常更加高效。DeepSeek API Docs
十一、DeepSeek 强调搜索结果会过滤低质量内容
DeepSeek 官方称,其自研搜索引擎已经索引数千亿网页,支持多语言搜索,并服务全球数亿级日请求。
官方还表示,搜索系统会通过检测机制过滤:
SEO 垃圾内容;
GEO 操纵内容;
低质量 AIGC 页面。
目标是向用户和大模型提供更加相关、权威和及时的搜索结果。需要注意,这些属于 DeepSeek 对自家搜索系统的官方描述,实际效果仍然需要开发者结合自己的任务和数据进行评估。DeepSeek API Docs
这项能力对 Agent 特别重要。
因为 AI 搜索普及以后,互联网上也出现了大量专门面向模型优化、但实际信息价值很低的内容。
Agent 如果只追求关键词相关,很容易把看起来完整、实际上缺乏依据的网页当成可靠来源。
十二、DeepSeek Harness、Claude Code 和 Codex 怎么使用?
DeepSeek Harness
Harness 可以将 Search 和 Fetch 作为服务端工具使用。
Agent 在执行研究、编程或资料查询任务时,可以根据任务需要自动触发联网。
Claude Code
DeepSeek API 原生支持 Claude Code 的 Web Search 功能。
当模型判断问题需要查询互联网时,会自动调用搜索工具。
搜索请求按照 Search API 规则计费,模型对结果进行总结时继续产生 Token 费用。DeepSeek API Docs
Codex
DeepSeek API 已兼容 OpenAI Responses API,可以作为 Codex 的模型服务商。
但 Codex 内置网页搜索目前需要使用:
deepseek-v4-pro
并将:
web_search = "live"显式打开。
官方一键配置脚本默认会关闭 Codex 网页搜索;使用 deepseek-flash 时,Codex 内置 Web Search 目前不可用。DeepSeek API Docs
所以“支持 Codex 搜索”并不等于:
安装完成后所有模型默认自动联网。
具体仍然要看:
模型;
客户端;
配置;
工具权限。
十三、Search 与 Fetch 最适合哪些产品?
深度研究 Agent
搜索大量网页,筛选资料,抓取正文,再生成带来源的行业报告。
Coding Agent
查找最新框架文档、错误解决方案、GitHub Issue 和依赖升级信息。
企业 RAG
将内部知识库与实时互联网信息结合,避免答案只依赖静态文档。
舆情与竞品监控
定时搜索品牌、产品、政策与竞争对手的新动态。
AI 新闻聚合
抓取多个来源,自动去重、分类、总结并生成日报。
电商与营销 Agent
查询商品趋势、用户讨论、竞品价格与行业内容。
金融与专业研究
优先检索官方公告、公司报告和权威来源,再进行交叉核验。
十四、它不具备网页“操作”能力
Search 与 Fetch 都是:
只读接口。
它们可以搜索网页、读取页面内容。
但不能直接:
填写表单;
点击购买;
登录账号;
提交订单;
发送消息;
修改网页数据。
如果 Agent 还需要执行网页操作,仍然需要另外接入:
浏览器自动化;
Computer Use;
RPA;
网站官方 API;
MCP 工具。
可以把能力边界理解成:
Search
→ 找到网页

Fetch
→ 读取网页

Browser / Computer Use
→ 操作网页
这三类能力不能混为一谈。DeepSeek API Docs
十五、还有哪些限制需要注意?
目标网站可能拒绝抓取
Fetch 会受到网站访问策略、页面状态和内容格式影响。
动态页面不一定能完整提取
大量依赖 JavaScript 渲染、登录态或复杂交互的页面,可能无法返回完整 Markdown。
搜索结果仍需核验
相关性和权威度评分可以辅助筛选,但不能代替事实核验。
网页内容可能包含提示词注入
Agent 读取外部网页时,需要防止页面中隐藏的恶意指令影响系统行为。
抓取不等于拥有使用权
开发者仍然需要遵守目标网站的服务条款、版权规则和数据合规要求。
十六、并发能力可以支持较大规模业务
DeepSeek 当前为每个账户分别设置:
Search
100 QPS

Fetch
25 QPS
Search 与 Fetch 的额度相互独立,也与模型本身的并发限制分开计算。
Fetch 还存在针对单个目标域名的额外 QPS 限制,防止对同一个网站进行过于集中的抓取。
按照理论上限计算,Search 可以承载较高频率的实时查询。
不过企业正式接入时,仍然应该建立:
请求队列;
缓存;
失败重试;
域名限速;
结果去重;
成本监控。
不要因为接口上限较高,就对同一个站点进行无控制的高频请求。DeepSeek API Docs
十七、如何进一步降低使用成本?
先搜索,再选择性 Fetch
不要抓取所有结果,只抓真正相关和高权威的页面。
优先使用摘要
如果搜索结果中的 summary 已经足够回答问题,就没有必要继续读取全文。
使用缓存
相同网址不要在短时间内反复抓取。
限制正文长度
进入模型前,只保留与问题相关的章节。
批量返回搜索结果
一次 Search 直接返回足够多的候选结果,避免重复查询。
区分实时与非实时问题
历史稳定知识可以使用缓存或知识库,不必每次联网。
记录每项任务成本
分别统计:
Search 次数;
Fetch 次数;
模型输入 Token;
模型输出 Token。
最后关注:
成功完成一次任务的总成本。
结语
DeepSeek Search 与 Fetch API 可以记住几组核心信息:
Search:
根据关键词搜索网页,返回结构化结果。
Fetch:
读取指定网页,返回 Markdown 正文。
国内价格:
两项接口分别为每 1000 次成功请求 5 元。
单次成功请求:
约 0.005 元。
计费条件:
返回 HTTP 200,并真正产生搜索结果或网页正文。
不计费情况:
失败、空结果、超时和无法提取正文。
免费过渡期:
DeepSeek Harness、Claude Code 和 Codex 中的服务端工具调用,目前暂免收费。
正式计费时间:
2026 年 11 月 1 日 00:00,北京时间。
并发限制:
Search 100 QPS。
Fetch 25 QPS。
这次真正值得关注的,不只是每千次 5 元。
而是 DeepSeek 正在把 Agent 所需的能力继续拆成标准服务:
模型负责理解和推理。
Search 负责寻找资料。
Fetch 负责读取网页。
Harness 负责组织任务和调用工具。
当这些能力拥有独立接口、明确价格和使用规则后,Agent 才更容易进入可以计算成本、控制权限和规模化运行的生产环境。
相关链接
DeepSeek API 文档
https://api-docs.deepseek.com/
DeepSeek Search 与 Fetch 使用指南
https://api-docs.deepseek.com/zh-cn/guides/search/
DeepSeek Search API 参考
https://api-docs.deepseek.com/zh-cn/api/search/
DeepSeek Fetch API 参考
https://api-docs.deepseek.com/zh-cn/api/fetch/
DeepSeek API 模型与价格
https://api-docs.deepseek.com/zh-cn/quick_start/pricing/
DeepSeek API 更新日志
https://api-docs.deepseek.com/zh-cn/updates/
标签
评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。