
小米 MiMo-V2.6-Pro 杀回 Code Arena:首测冲进前十,仍稳居 MIT 开放权重前三


…
小米 MiMo-V2.6-Pro 发布以后,又拿到了一项很有含金量的成绩。
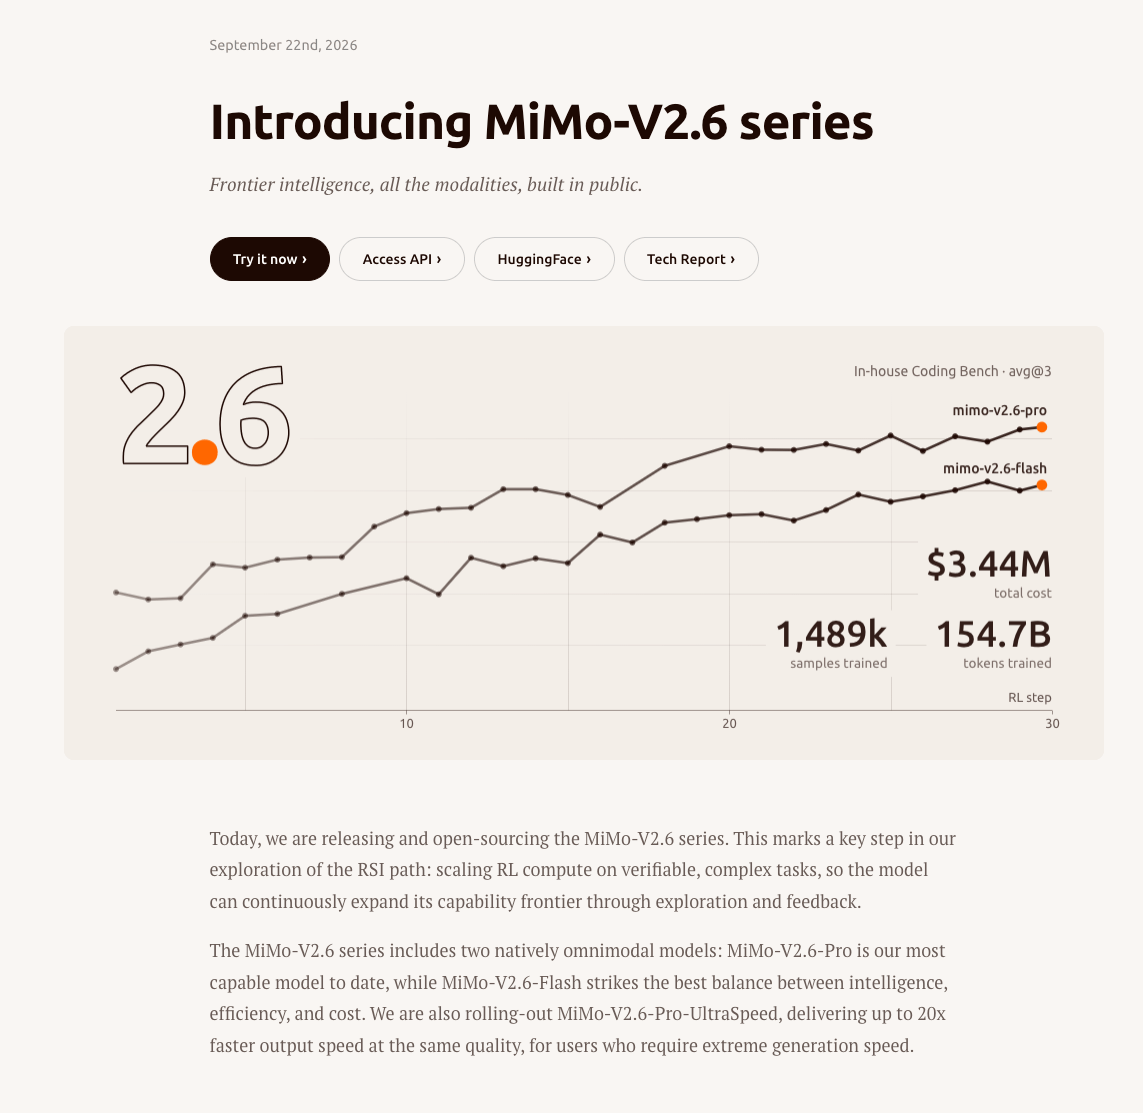
在主要测试 AI 网页开发能力的:
Code Arena: WebDev
中,MiMo-V2.6-Pro 刚上线时便拿到:
1628 分。
一度进入总榜:
前十。
这个成绩与 Claude Fable 5(High)持平,并略高于当时获得 1624 分的 Hy4-preview。
在采用 MIT 许可证的开放权重模型中,MiMo-V2.6-Pro 也进入了前三。
更明显的是,与上一代 MiMo-V2.5-Pro 的 1475 分相比,新模型首测直接提高:
153 分。
不过,Code Arena 是一张持续变化的动态榜单。
随着真实用户投票不断增加,MiMo-V2.6-Pro 的当前成绩已经更新为:
1618±13 分。
实时总榜暂列:
第 19 名。
所以更加准确的说法应该是:
MiMo-V2.6-Pro 首轮 AutoEval 冲进前十,进入人工投票阶段后暂列第19,但仍处于MIT开放权重模型第一梯队。
一、Code Arena 测的不是“会不会写一个网页”
Code Arena: WebDev 并不是传统的静态代码题库。
它不会只给模型一道题,然后检查代码:
能不能编译;
有没有语法错误;
测试用例是否通过。
模型需要在一个真实的网页开发环境中完成完整任务。
例如:
制作一个具有暗黑模式的 Markdown 编辑器。
根据参考图片还原一个产品官网。
创建一个可以交互的数据分析仪表盘。
制作一个真正能玩的浏览器小游戏。
模型需要连续完成:
理解需求
↓
规划页面结构
↓
创建项目文件
↓
编写HTML、CSS和JavaScript
↓
运行与预览页面
↓
检查实际效果
↓
继续修改
↓
交付可以使用的网页
整个过程允许模型进行多轮操作,并调用创建文件、读取文件、编辑文件和运行命令等工具。
最终用户看到的不是一段代码,而是:
真正可以打开和交互的网页。
这也是 Code Arena 更接近 Vibe Coding 真实使用体验的地方。
二、1628 分属于 AutoEval 首测成绩
MiMo-V2.6-Pro 上线 Code Arena 后,最先公布的是:
AutoEval 1628 分。
AutoEval 是 Arena 为新模型设计的一套快速评测机制。
因为新模型刚加入排行榜时,还没有足够多的真实用户投票,如果完全等待人工数据积累,可能需要几天甚至更长时间才能形成稳定排名。
Arena 因此会先使用一个基于海量人类偏好数据训练的 Reward Model,对模型结果进行自动评价。
简单理解:
模型刚上线
↓
真实用户投票还不够
↓
Reward Model模拟人类偏好投票
↓
快速计算AutoEval分数
↓
进入临时榜单
因此,1628 分代表的是:
MiMo-V2.6-Pro 上线第一阶段的快速预估成绩。
它不是永久固定的最终分数。
三、真实投票增加后,当前暂列第19
随着真实用户开始在 Arena 中使用和比较 MiMo-V2.6-Pro,榜单会逐渐用人工投票更新 AutoEval 结果。
截至 Arena 当前公开页面标注的 9 月 25 日:
MiMo-V2.6-Pro:1618±13 分,排名第19。
同一榜单中:
DeepSeek V4.1 Flash(Max):1621±11,排名第16。
GLM-5.3(Max):1619±9,排名第18。
三款 MIT 开放权重模型之间只有几分差距。
而且它们的置信区间明显重叠。
这意味着,从当前统计数据来看,不能简单下结论说:
某一款模型已经明确碾压另外两款。
更准确的描述是:
DeepSeek V4.1 Flash、GLM-5.3 与 MiMo-V2.6-Pro,目前组成了非常接近的MIT开放权重模型头部梯队。Arena AI
四、从1475到1618,提升依然非常明显
虽然实时榜单不再是首测时的前十,但 MiMo-V2.6-Pro 相比上一代的提升依然很大。
当前榜单中的 MiMo-V2.5-Pro:
1477±5 分。
排名:
第56。
MiMo-V2.6-Pro:
1618±13 分。
排名:
第19。
按照当前实时数据计算,新一代提高了:
141 分。
排名上升:
37 位。
如果按照刚上线时的 AutoEval 结果计算,则是用户资料中提到的:
1628 对 1475,提高153分。
无论看首测数据还是当前人工投票结果,都说明 MiMo-V2.6-Pro 在网页开发能力上,并不是一次普通的小版本升级。
五、为什么这一代网页开发能力涨得这么快?
MiMo-V2.6-Pro 的提升,与这一代的训练方向有明显关系。
它是一款原生全模态模型,能够同时理解:
文本;
图片;
视频;
音频。
对于网页开发来说,视觉输入非常重要。
用户的任务可能不是一句纯文字,而是直接上传:
网页截图;
Figma 设计稿;
产品参考图;
操作录屏;
视觉风格案例。
模型需要先理解视觉内容,再结合代码实现页面。
整个流程会变成:
读取设计稿
↓
理解布局和视觉层级
↓
编写网页代码
↓
运行页面
↓
观察渲染结果
↓
对照参考图继续修改
相比只理解文字和代码的模型,原生视觉能力更适合:
设计稿转代码;
网页复刻;
UI 调整;
响应式适配;
交互动效开发。
六、1M上下文,也更适合完整项目
MiMo-V2.6-Pro 采用 Sparse MoE 架构。
总参数约:
1.02T。
每个 Token 激活:
约42B参数。
上下文长度达到:
100万 Token。
这使模型可以在一次任务中容纳更多:
项目代码;
产品需求;
设计文档;
图片素材;
工具调用记录;
历史修改过程。
对于一个真正的网页项目来说,模型可能需要同时理解:
全局样式;
组件库;
路由;
数据结构;
页面组件;
交互状态;
响应式规则。
上下文越完整,模型越不容易在修改某个页面时破坏其他部分。
小米官方模型卡也明确把 MiMo-V2.6-Pro 定位为面向长代码仓库、长工具轨迹和多会话 Agent 任务的全模态模型。Hugging Face
七、真正的提升来自大规模 Agent 强化学习
MiMo-V2.6 并不是只在普通网页代码数据上继续训练。
这一代将:
Coding;
通用 Agent;
视觉任务;
网络安全;
多种 Harness
放进同一套强化学习过程。
模型需要在真实环境中反复完成:
读项目;
写代码;
调用工具;
运行测试;
检查结果;
失败后继续修复。
这种训练方式更接近 Code Arena 的任务形式。
因为 Code Arena 测试的同样不是单次代码补全,而是:
模型能不能作为 Agent 持续完成一个网页项目。
模型在训练中积累的规划、工具调用、自我检查和迭代能力,最终都会反映在网页开发任务中。
八、它已经进入国际头部,但距离当前前三仍有差距
MiMo-V2.6-Pro 当前的 1618 分,已经超过大量知名闭源和开放权重模型。
但“性能直逼国际第一梯队”需要写得更准确一些。
当前 Code Arena: WebDev 前三名分别为:
Claude Opus 5.5(Max):1827分。
GPT-6 Astra(Max):1792分。
Claude Fable 5.1(Max):1751分。
MiMo-V2.6-Pro 与当前第三名之间仍相差:
133分。
与第一名之间相差:
209分。
所以不适合直接写成:
MiMo-V2.6-Pro已经和全球最强闭源模型完全持平。
更加合理的表述是:
MiMo-V2.6-Pro已经进入国际网页开发模型的头部竞争区间,并在MIT开放权重模型中处于第一梯队,但与当前最强闭源旗舰仍存在明显差距。Arena AI
九、MIT许可证,是这次成绩更有价值的一层原因
MiMo-V2.6-Pro 的模型权重已经通过 Hugging Face 和 ModelScope 开放。
许可证采用:
MIT License。
这意味着开发者可以在遵守许可证要求的前提下:
下载权重;
本地部署;
私有化部署;
继续研究;
进行量化;
用于商业项目。
当前 Code Arena 排在它前面的许多模型,属于无法下载权重的闭源商业模型。
因此,对需要:
本地运行;
数据私有化;
企业定制;
模型研究;
自建 Agent
的开发者来说,MiMo-V2.6-Pro 的意义不只是排行榜分数。
它提供的是一款可以真正拿回自己环境中的头部模型。
十、AutoEval 和实时榜单为什么会变化?
AutoEval 与真实投票出现差异,并不意味着早期成绩是假的。
Arena 官方将 AutoEval 定位为:
Day-1 Signal。
也就是新模型发布第一天的快速能力信号。
Arena 使用基于人类偏好数据训练的 Reward Model 自动投票,再采用与正式榜单相同的方法计算分数。
官方测试显示,AutoEval 与后续真人评测的排名相关性超过:
0.98。
当两个模型真实差距超过10分时,AutoEval判断更优模型的准确率超过:
90%。
但当差距只有5分以内时,模型通常很难在统计上明确区分。
所以:
MiMo-V2.6-Pro 1628;
Claude Fable 5(High)1628;
Hy4-preview 1624,
更适合说明三者在首轮自动评估中处于同一密集区间。
不适合把4分差距写成明显领先。
随着更多人工投票进入,模型分数和名次继续变化,属于 Arena 排行榜的正常机制。Arena AI
十一、对于前端开发者,这个成绩意味着什么?
排行榜不能直接代替个人实测。
但 MiMo-V2.6-Pro 在 Code Arena 的提升,至少说明它值得在以下场景中测试:
设计稿转网页
上传 UI 截图或产品参考图,让模型生成 React、Vue 或普通 HTML 页面。
完整 Landing Page
从产品介绍开始,完成 Hero、功能介绍、定价、FAQ 和响应式布局。
Web 3D 与互动页面
结合图片、视频和文字要求,生成 Three.js 场景、小游戏或互动展示。
大型前端项目修改
读取现有代码库,在保持设计系统和业务逻辑的前提下修改多个页面。
自动视觉检查
运行页面后,结合截图检查间距、字体、溢出、响应式和组件一致性。
真正判断它是否适合自己的方式,仍然是:
拿同一个真实需求,同时交给 MiMo、Claude、GPT、GLM 和 DeepSeek完成。
再比较:
最终页面;
代码质量;
修改次数;
任务耗时;
Token成本。
结语
MiMo-V2.6-Pro 在 Code Arena: WebDev 的表现,可以分成两个阶段理解。
首轮 AutoEval
1628分。
约排名:
总榜前十。
与 Claude Fable 5(High)持平。
略高于当时 1624 分的 Hy4-preview。
相比 MiMo-V2.5-Pro:
提高153分。
当前实时榜单
1618±13分。
排名:
第19。
相比当前 MiMo-V2.5-Pro:
提高141分、上升37位。
在 MIT 许可证开放权重模型中,依然处于前三,并且与 DeepSeek V4.1 Flash、GLM-5.3 的成绩非常接近。
所以这条新闻真正值得看的,不是:
“小米已经打败了所有国际模型。”
而是:
小米只用一代更新,就把MiMo从WebDev榜单中游推到了开放权重头部。
而且这款模型可以下载、部署、研究和继续修改。
对于开源与开放权重生态来说,这比一次短暂的榜单名次更值得关注。
相关链接
小米 MiMo-V2.6 官方介绍
https://mimo.xiaomi.com/mimo-v2-6
标签




评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。