
小米这次不只开源模型:MiMo-V2.6 登顶 AA 开放权重榜,连 7000+ RL 环境都放出来了


…
小米 MiMo 新模型,终于正式发布了。
这次一口气带来:
MiMo-V2.6-Pro
MiMo-V2.6-Flash
以及更轻量的:
MiMo-V2.6-Distill-Qwen-9B。
其中,MiMo-V2.6-Pro 在最新 Artificial Analysis Intelligence Index 中取得:
46 分。
截至目前,排在大型开放权重模型榜单:
第 1 名。
不过这次真正值得关注的,并不只是一个“开源模型第一”。
小米同步放出来的还有:
模型权重。
完整技术报告。
7000+ 高质量 RL 任务环境。
端到端强化学习框架。
可组合 mini-harnesses。
也就是说,小米这次不只是把训练好的模型交出来。
而是连:
模型到底怎么继续训练、在哪些环境里训练、如何评估和调用工具
都开始一起开放。
一、Pro 和 Flash,都已经是原生全模态模型
MiMo-V2.6 系列包含两个核心版本。
MiMo-V2.6-Pro
定位是当前 MiMo 系列中能力最强的旗舰模型。
采用 Sparse MoE 架构:
总参数 1.02T。
每个 Token 激活约 42B 参数。
上下文长度:
100 万 Token。
MiMo-V2.6-Flash
定位是能力、速度和成本更加平衡的高频版本。
同样采用 Sparse MoE:
总参数 309B。
每个 Token 激活约 15B 参数。
上下文也达到:
100 万 Token。
两款模型都原生支持:
文本。
图片。
视频。
音频。
输出形式目前以文本为主。
所以它们不只是传统语言模型增加一个视觉接口,而是从架构和训练阶段就围绕多模态、长上下文和 Agent 任务进行统一设计。
二、46 分到底是什么水平?
MiMo-V2.6-Pro 当前在 Artificial Analysis Intelligence Index 中取得:
46 分。
在 Artificial Analysis 当前划分的“大型开放权重模型”类别中,排名:
第 1 / 114。
需要注意,这里的准确说法应该是:
当前 AA 大型开放权重模型第一。
而不是不加任何限定地写成:
“全球所有模型第一。”
因为在最强闭源旗舰模型面前,MiMo-V2.6-Pro 仍然存在差距。
而且 Artificial Analysis 会持续调整评测集和计算方式,同一模型在不同版本指数中的分数也可能变化。
但即便如此,46 分依然说明:
小米 MiMo 已经正式进入全球开放权重模型的头部区域。
三、真正有意思的,是“递归自我改进”
小米将 MiMo-V2.6 的核心技术路线概括为:
Scaling Reinforcement Learning Toward Self-Improvement。
也就是:
通过扩大强化学习,让模型在反馈中持续自我改进。
这里的“自我改进”,并不是指模型脱离人类控制,自己修改源码、自己发布下一代版本。
更准确的理解是:
模型在强化学习环境中反复执行任务。
同一道任务会生成多条不同的解决路径。
系统再比较这些路径:
谁真正完成了任务?
谁走得更短?
谁消耗的 Token 更少?
谁虽然成功了,但过程存在风险?
最后把更高质量的执行方式转化成更精细的奖励信号,再继续推动模型更新。
整个过程大概是:
模型执行任务
↓
生成多条不同轨迹
↓
测试与验证结果
↓
比较成功轨迹的质量
↓
把奖励分配给更好的路径
↓
继续训练模型
过去很多 RL 任务只看:
成功还是失败。
但如果两条轨迹都成功了,一条用了 20 步,另一条只用了 8 步,显然后者更值得学习。
MiMo-V2.6 的 Groupwise Agentic Grading,就是想继续解决:
成功答案之间,谁做得更好。
四、这条 RL 路线,确实很烧算力
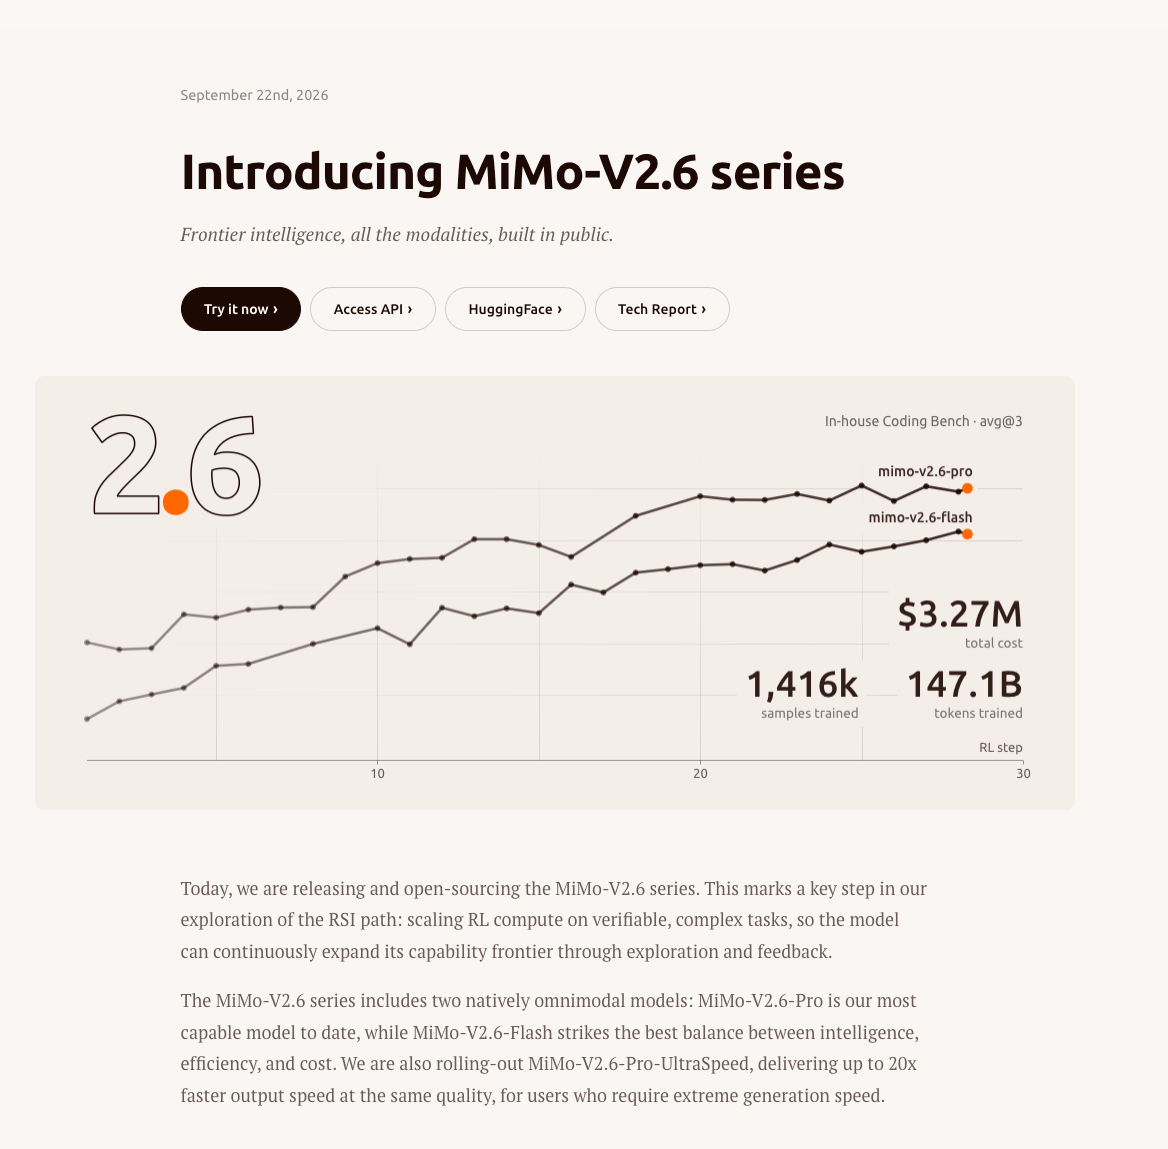
为了完成这轮训练,小米还公开直播了 MiMo-V2.6 的强化学习过程。
按照官方披露:
Pro 和 Flash 的公开 RL 训练持续不到 6 天。
两款模型分别完成 30 个训练 Step。
累计生成约:
75 万条 Agent 轨迹。
Flash 的公开训练成本约:
85 万美元。
Pro 则约为:
262 万美元。
每次更新会使用:
1568 个 Prompt × 16 次 Rollout。
单个训练 Step 处理的 Token 规模达到数十亿级。
这也解释了为什么大模型的 Agent 能力不能只靠:
多收集一点问答数据。
真正训练长程 Agent,需要模型不断进入:
代码仓库;
电脑环境;
浏览器;
网络安全靶场;
复杂工具链
中反复尝试。
而这些任务的成本,远高于普通文本问答训练。
五、“You Only RL Once”:不再为每个领域单独练一遍
MiMo-V2.6 还有一个挺有意思的设计:
You Only RL Once。
过去训练 Agent 模型,往往会把不同领域拆开。
代码任务单独训练。
视觉任务单独训练。
网络安全再单独训练。
不同 Harness 甚至还要重新适配一遍。
MiMo-V2.6 则把:
Coding。
通用 Agent。
视觉任务。
网络安全。
以及不同 Harness 的任务,放进同一套混合 RL 训练中。
希望不同能力之间互相迁移。
比如模型在软件工程中学会:
先查看环境;
再制定计划;
执行以后检查结果;
发现失败再修复。
这套策略不只可以用于代码,也可能迁移到:
Computer Use;
网页操作;
3D 建模;
办公自动化。
甚至在训练时没有见过的 Agent Harness 中,模型也能更快适应。
六、7000+ RL 环境,可能比模型权重更有价值
很多开源模型发布,通常到这一步就结束了:
放一个权重。
再提供一份模型卡。
但开发者真正想继续训练模型时,很快会碰到新的问题:
任务从哪里来?
执行环境怎么搭?
结果怎么验证?
奖励怎么计算?
Harness 怎么连接?
这次小米同步开放了超过:
7000 个高质量 RL 任务环境。
主要覆盖四个方向:
软件工程。
漏洞复现。
知识密集型工作。
网页设计与开发。
这些环境不是普通问答数据。
而是可以让 Agent 真正进入环境中:
读文件;
写代码;
调用工具;
运行测试;
操作网页;
提交结果。
再由 Verifier 判断任务到底有没有完成。
对于 Agentic RL 来说,真正稀缺的往往已经不只是模型,而是:
可执行、可验证、可以反复训练的真实任务环境。
七、连完整 RL 训练框架也一起放出来了
除了任务环境,小米还开放了一套端到端强化学习框架。
整个链路覆盖:
环境交互
↓
Agent执行任务
↓
轨迹收集
↓
结果验证
↓
奖励计算
↓
策略更新
框架建立在 verl、uni-agent 和 mini-swe-agent 等项目之上。
开发者可以把:
开放模型;
任务环境;
奖励机制;
Agent Harness
重新组合起来,继续研究自己的强化学习方法。
小米还提供了更加轻量的:
Composable Mini-Harnesses。
它会把 Agent 中的:
系统提示词;
工具;
上下文管理;
执行流程
拆成相对独立的模块。
研究者可以自由组合不同配置,观察:
同一个模型放进不同 Harness 后,能力会发生什么变化。
这其实和现在越来越热的 Harness Engineering 是同一个方向。
八、Pro 和 Flash,真实 Agent 表现怎么样?
按照小米官方公布的测试结果:
DeepSWE v1.1
MiMo-V2.6-Pro:
71.9
MiMo-V2.6-Flash:
67.9
AutomationBench
Pro:
53.1
Flash:
52.3
Toolathlon-Verified
Pro:
76.9
Flash:
73.6
Terminal Bench 2.1
Pro:
89.9
Flash:
87.6
OSWorld-Verified
Pro:
82.0
Flash:
80.8
MiMo VisualCoding
Pro:
72.3
Flash:
71.5
可以看到,Pro 和 Flash 的差距并没有参数规模看起来那么大。
Flash 虽然激活参数只有 15B,但在大量 Agent 任务中仍然接近 Pro。
所以两者的分工会比较明确:
Pro 负责能力上限。
Flash 负责高频和规模化任务。
不过这些单项成绩主要来自小米官方测试,实际效果仍然需要结合第三方评测和真实项目继续验证。
九、还有一款 9B 蒸馏模型,专门降低研究门槛
这次开源包里还有:
MiMo-V2.6-Distill-Qwen-9B。
它的意义不是取代 Pro 或 Flash。
而是给普通研究者提供一个更加容易部署、继续做 Agentic RL 实验的起点。
毕竟:
1T 级 Pro 模型即使开放权重,也不是普通开发者几张显卡就能轻松跑起来的。
9B 模型则更适合:
本地实验;
环境验证;
Agent Harness 研究;
小规模强化学习;
垂直任务微调。
小米还公开了从这款 9B 蒸馏模型出发进行 RL 的结果,在软件工程、网络安全、终端任务和视觉编程等多项评测中,都比原始 SFT 版本进一步提高。
十、这次“开源”不只是放个权重文件
严格来说,Artificial Analysis 使用的是:
Open Weights,开放权重模型。
但 MiMo-V2.6 这次开放的内容已经明显超过单纯权重:
Pro 与 Flash 模型权重;
MIT 许可证;
9B 蒸馏模型;
完整技术报告;
7000+ RL 任务环境;
端到端 RL 训练框架;
可组合 Mini-Harnesses;
公开训练过程和指标。
所以这次称为“开源发布”,并不只是营销上的说法。
它真正把 Agent 强化学习中的很多关键组件一起交给了社区。
十一、现在可以在哪里使用?
除了自行下载权重,MiMo-V2.6 也已经进入小米自己的产品体系。
目前可以通过:
MiMo Desktop。
MiMo Studio。
MiMo Code。
小米 MiMo 开放平台 API。
以及部分第三方模型平台使用。
API 价格继续沿用 V2.5 的标准,没有因为智能水平提高同步涨价。
Pro 还提供:
UltraSpeed 高速模式。
官方表示,特定场景下生成速度最高可提升至普通版本的 20 倍,主要面向实时交互和对延迟敏感的工作流。
结语
MiMo-V2.6 这次可以记住几组数字:
Pro:1.02T 总参数,42B 激活。
Flash:309B 总参数,15B 激活。
两款模型均支持:
100 万 Token 上下文。
文本、图片、视频和音频输入。
MiMo-V2.6-Pro 在 AA Intelligence Index 取得:
46 分。
暂居当前大型开放权重模型:
第 1 名。
但我觉得,这次真正值得关注的并不是“第一”这两个字。
排行榜随时会变化。
真正更长期的价值,是小米开始把:
模型权重 + RL 环境 + 训练框架 + Harness + 蒸馏模型
完整放到一起。
过去开源大模型的竞争,主要看:
谁愿意开放权重。
接下来可能还要继续看:
谁愿意开放模型变强的方法。
7000 多个任务环境、端到端 RL 框架和 Mini-Harnesses,才可能是 MiMo-V2.6 这次真正的大招。
小米不只是交出了一条鱼。
连池塘、钓竿,以及怎么继续养鱼的方法,都开始一起放出来了。
相关链接
小米 MiMo-V2.6 官方介绍
https://mimo.xiaomi.com/mimo-v2-6
MiMo-V2.6 官方更新说明
https://mimo.mi.com/docs/en-US/news/latest/v2-6
MiMo-V2.6 Hugging Face 合集
https://huggingface.co/collections/XiaomiMiMo/mimo-v26
MiMo-V2.6-Pro-RL
https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL
MiMo-V2.6-Flash-RL
https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Flash-RL
MiMo-V2.6-Distill-Qwen-9B
https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Distill-Qwen-9B
MiMo-V2.6 技术报告
https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL/blob/main/MiMo_V2_6_technical_report.pdf
MiMo-V2.6 RL 训练看板
小米 MiMo 开放平台
https://platform.xiaomimimo.com/
MiMo Desktop
https://mimo.xiaomimimo.com/desktop/
Artificial Analysis:MiMo-V2.6-Pro
https://artificialanalysis.ai/models/mimo-v2-6-pro




评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。