
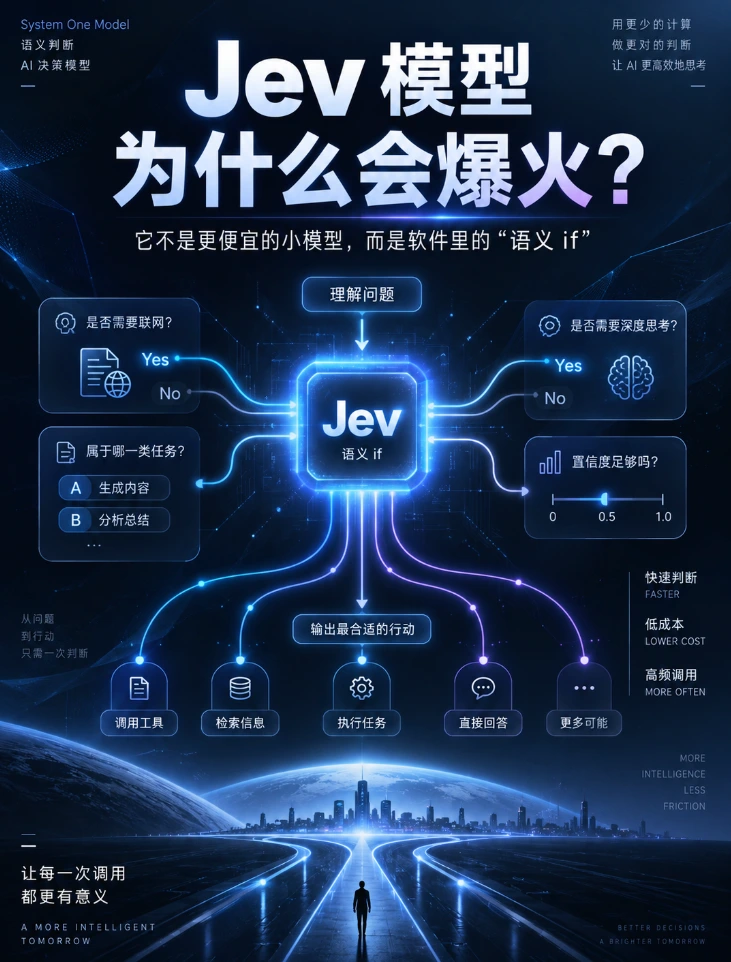
Jev 为什么突然爆火?它不是更便宜的小模型,而是软件里的“语义 if”


…
Jev 这几天火得一塌糊涂。
有人看完第一反应是:
不就是一个速度更快、价格更低的小模型吗?
如果只是这么理解,其实低估了它。
Jev 真正有意思的地方,不在于它比 GPT 或 Claude 便宜多少,而在于它从一开始就没有打算成为另一个聊天模型。
它不负责陪你聊天。
不负责写长文。
也不负责生成代码。
它只专注做一件事:
判断。
如果一定要用一句最容易理解的话概括:
Jev 想给软件加上一种会理解自然语言和现实语义的 if 语句。
一、先别急着看 Jev,先看它试图解决什么问题
理解一种新技术,最好的办法往往不是先看参数,而是先问:
它到底想解决什么问题?
过去几年,大语言模型的进步非常明显。
模型已经可以:
推理;
写代码;
调用工具;
操作电脑;
连续完成复杂的长程任务。
但今天主流大语言模型的底层工作方式,依然主要建立在自回归生成之上。
简单理解就是:
读取已有上下文
↓
预测下一个 Token
↓
再根据新 Token 预测下一个
↓
一个接一个往后生成
无论最后生成的是:
文章;
代码;
JSON;
工具调用;
推理过程,
本质上通常还是在逐 Token 生成一串内容。
这种机制非常灵活。
但软件系统中存在大量根本不需要自由文本生成的任务。
系统只需要模型做一个判断。
二、软件里有大量普通 if 写不了的判断
程序员每天都会写大量 if else。
例如:
如果订单金额大于 100 元
→ 执行流程 A

如果库存低于 10
→ 执行流程 B
这些条件非常明确。
代码可以精确计算。
但如果条件变成:
用户是否已经失去耐心?
这封邮件是不是在要求退款?
这条内容是否包含潜在安全风险?
这位客户应该转给售后、财务还是销售?
当前 Agent 是否应该调用搜索工具?
普通 if 就不会写了。
因为这些问题需要的不是数学计算,而是:
语义理解。
以前最常见的解决办法,是调用一个 GPT、Claude 或其他 LLM。
让模型阅读内容,再生成一个答案。
当然可以用。
但如果程序最终只需要一个:
true / false
或者:
billing / technical / sales
让一个通用大模型先进行推理、再生成一串 Token,多少有点大材小用。
Jev 要补的,就是:
确定性代码和自然语言语义之间的空白地带。
三、最简单的理解:给代码加一个“语义 if”
假设客服系统收到这样一条消息:
这个产品买回来才用了三天就出问题,你们这个品控也太差了。我已经折腾两天了,到底能不能退款?
人看到以后,几乎可以立刻判断:
用户很生气。
很紧急。
遇到了产品质量问题。
并且大概率正在要求退款。
但传统程序只能看到:
一串字符。
程序可能通过关键词匹配找到“退款”。
但用户也可能说:
我不是想退款,只想换一个新的。
仅靠关键词就容易判断错误。
Jev 的工作方式则是:
把当前信息作为 state 传给模型,再把需要判断的问题提前定义好。
例如:
当前状态:
用户的完整客服消息

需要判断:
1. 用户是否正在申请退款?
2. 应该分配给哪个部门?
3. 用户当前有多愤怒?
4. 是否需要优先处理?
Jev 最终返回的不是一段客服分析,而是类似下面这样的结构化结果:
是否申请退款:0.82

负责部门:
售后 0.71
技术 0.24
财务 0.05

愤怒程度:1.8 / 2

是否紧急:0.93
后面的流程继续由普通代码控制:
if refund_probability > 0.9:
    start_refund_review()

if urgency > 0.8:
    raise_priority()

if department_confidence < 0.5:
    send_to_human_review()
所以 Jev 并不是要替代整个软件系统。
它更像是在代码中增加一种新的判断组件:
语义进,概率出,最终动作仍然由代码决定。
四、Jev 提供三种最基础的判断能力
TypeSafe 目前把 Jev 的结构化判断拆成了三种 Primitive。
1. Noul:这件事是真的吗?
Noul 用来回答 Yes / No 类型的问题。
例如:
用户是否正在要求退款?
这段话是否包含个人敏感信息?
这个 Agent 是否需要人工介入?
它不会只返回生硬的 true 或 false。
而是返回一个 0~1 的概率。
例如:
0.98表示非常倾向于“是”。
0.47则说明模型自己也拿不准。
程序可以根据任务风险设置不同阈值。
2. Choice:应该选择哪一个?
Choice 用来从提前定义的选项中选择一个答案。
例如:
退款
物流
技术
账户
其他
模型不仅返回最终选择,还会返回每一个选项的概率分布和整体置信度。
这比只返回:
技术部门。
多了一层非常重要的信息:
模型到底有多确定?
如果“技术”和“售后”的概率非常接近,系统就可以把工单交给人工复核,而不是强行自动分配。
3. Score:它处于哪个程度?
Score 用来判断一个有明确顺序的尺度。
例如:
0:平静
1:有些不满
2:非常愤怒
或者:
0:低风险
1:中等风险
2:高风险
3:极高风险
模型会在这些等级上给出分数和概率。
多个维度的 Score 还可以由代码继续加权组合。
比如判断一个销售线索,可以分别评估:
市场需求;
购买意愿;
预算匹配;
决策紧迫度。
最后由企业自己的公式计算总优先级。
模型负责语义判断。
规则和权重依然掌握在业务代码手中。
五、多个问题可以一次并行完成
这也是 Jev 和传统 LLM 很不一样的一点。
如果一个客服系统需要判断:
用户意图;
情绪;
紧急程度;
负责部门;
是否需要人工;
是否包含敏感信息,
传统方式可能需要生成一大段 JSON,或者分别调用模型多次。
Jev 则可以在同一次请求里放入多个独立问题。
所有问题基于同一份 state 并行完成判断。
例如一条客服消息进来,可以同时判断:
是否退款
是否紧急
是否重复投诉
用户情绪
负责部门
潜在流失风险
是否需要人工
程序最后只读取当前流程真正需要的结果。
这也是 TypeSafe 所说的:
Speculative Fan-Out。
提前把可能需要的判断一次全部问完,后面由代码决定哪些答案有用。
额外问题仍然会增加输入 Token,但不会像逐个调用那样线性增加大量等待时间。
六、为什么它叫 System One Model?
TypeSafe 把 Jev 称为:
第一个 System One Model。
这个名字来自丹尼尔·卡尼曼在《思考,快与慢》中普及的双系统框架。
System 1 代表:
快速;
直觉;
自动完成的判断。
例如看到一个人满脸怒气地走过来,你不需要列出十条证据,就知道他现在心情不好。
System 2 则更慢。
它负责:
复杂数学;
多步骤推理;
方案权衡;
长期规划。
过去几年,大模型行业重点发展的基本都是 System 2。
尤其 Reasoning Model 出现以后,模型会使用更多时间、更多计算和更多 Token,完成越来越复杂的推理任务。
TypeSafe 反过来问了一个问题:
软件里的所有 AI 调用,真的都值得进入深度推理吗?
显然不是。
判断一条客服消息属于哪个部门,不需要模型思考几十秒。
判断一个 Agent 步骤是否存在风险,也不需要生成几千 Token 的分析。
这些任务更接近:
快速、局部、高频的语义判断。
需要真正复杂推理时,再升级到 GPT、Claude 或其他 Reasoning Model。
所以 System One 不是要消灭 System Two。
两者更像分工:
Jev / System One
→ 快速判断、路由、评分、过滤

Reasoning Model / System Two
→ 复杂分析、规划、生成和执行
需要说明的是,这只是 TypeSafe 借用的产品设计比喻,并不意味着 Jev 完整复刻了人类认知中的 System 1。
七、Jev 为什么不是一个更小的 LLM?
这是理解 Jev 最关键的一点。
今天常见的小模型虽然参数更少、速度更快、价格更低,但大体仍然沿用 LLM 的生成接口。
你问:
这封邮件属于退款还是投诉?
模型仍然需要生成:
refund或者生成一段 JSON。
它依然是先产生字符串,再由程序解析字符串。
即使开启 JSON Mode 或 Structured Outputs,模型本质上仍然在逐 Token 生成内容,只是输出格式受到了约束。
Jev 则从任务定义上放弃了:
自由文本生成。
开发者提前定义:
有哪些问题。
每个问题有哪些合法答案。
Jev 直接返回:
类型确定的值;
概率分布;
置信度。
按照 TypeSafe 的说法,它为此重新设计了:
模型架构;
并行采样方式;
以及名为 RLCD 的训练方法。
RLCD 全称:
Reinforcement Learning for Calibrated Decisions。
它优化的目标不是:
让回答看起来更像人。
而是:
让模型做出结构化判断,并尽量让概率能够真实反映不确定性。
所以 Jev 的速度和价格优势,不只是:
把模型参数做小。
而是:
把任务从“生成所有可能的文字”,收窄为“在预定义空间里完成判断”。
八、Jev 的概率,比答案本身还重要
自动化系统最怕的事情不是模型偶尔不知道。
而是:
模型不知道,却表现得非常确定。
Jev 的设计重点之一,就是输出概率和置信度。
程序可以根据风险自动决定下一步。
例如:
高置信度
直接自动执行。
中等置信度
请求用户确认,或者调用更强的 Reasoning Model 再判断一次。
低置信度
交给人工。
同一个系统里,不同动作还可以使用不同阈值。
例如打开一个普通页面,判断错了问题不大。
但如果涉及:
退款;
转账;
删除数据;
安全封禁,
就必须设置更高的置信度要求。
这让不确定性不再是一件需要隐藏的事情。
而是成为:
软件流程里可以直接使用的信号。
九、为什么它可以这么快、这么便宜?
TypeSafe 当前公布的 Jev 服务延迟大约为:
70~500 毫秒。
输入价格为:
每百万 Token 0.042 美元。
输出目前免费计费。
这里的“输出免费”并不是完全没有输出数据,而是返回的结构化判断非常短,TypeSafe 暂时不收取输出 Token 费用。
假设一条客服工单的输入约为 300 Token。
处理 10 万条工单:
100000 × 300
= 3000万 Token
按照每百万 Token 0.042 美元计算:
30 × 0.042
= 1.26美元
当然,这只是一个非常粗略的估算。
真实请求还会包含:
问题定义;
选项说明;
业务规则
等额外输入。
但重要的不是精确到几美分。
而是它把一次语义判断的成本,压到了可以高频调用的区间。
TypeSafe 官网甚至给出了:
193.6 倍更快、444.6 倍更便宜
的工作流对比。
不过这组数据来自 TypeSafe 自己设计的四类自动化工作流,官方也明确表示,这些结果很可能属于现实收益的较高一端。
所以更稳妥的理解是:
在非常适合 System One 的结构化判断任务上,Jev 可能比通用 LLM 快和便宜几个数量级;具体收益仍然要看业务。
十、Jev 真正适合什么场景?
Jev 最适合的不是聊天,而是藏在软件后台,大量执行用户根本看不到的判断。
客服工单路由
判断问题类型、用户情绪、紧急程度和负责部门。
Agent 模型路由
判断当前任务应该使用便宜模型、旗舰模型,还是交给人工。
工具选择
在几百个 Skills 或 Tools 中,判断当前步骤最适合调用哪一个。
安全与 Guardrail
判断输入是否包含提示词注入、越权请求、敏感数据或者潜在危险操作。
RAG 结果筛选
判断检索出来的文档是否相关、是否矛盾、是否包含隐藏指令。
引用核验
判断一段引用是否真的支持模型给出的结论。
销售与风控评分
对客户意向、流失风险、欺诈可能性和审核优先级分别打分。
海量数据标注
将大规模文本、日志、工单和记录转化成可以继续用于统计和模型训练的数值特征。
它甚至可以成为大型 Agent 内部的一个:
实时裁判。
每执行一步之前都先判断:
这一步风险高不高?
是否偏离用户目标?
是否需要更强模型?
是否应该暂停并请求确认?
用户只看到 Agent 完成了一个任务。
但后台可能已经调用了几十次 Jev。
十一、“零幻觉”这件事,需要说准确
TypeSafe 在宣传中使用了:
Zero Hallucinations。
这个说法很吸睛,但必须拆开理解。
Jev 不生成自由文本。
如果开发者只定义了:
售后
物流
技术
财务
它就不会突然生成一个不存在的:
宇宙事务部它也不会输出损坏的 JSON 或不符合 Schema 的数据类型。
从这个角度看:
输出类型错误可以被彻底消除。
但这不代表:
判断永远正确。
它依然可能:
把售后问题判成技术问题;
低估一条消息的风险;
给错误选项更高概率。
所以更准确的说法是:
Jev 消除了自由文本生成中的类型和格式幻觉,但没有消除判断错误。
概率与置信度存在的意义,正是为了让代码知道:
什么时候可以自动执行。
什么时候必须升级处理。
十二、Jev 也有非常明确的能力边界
当前 Jev 1.13 并不适合所有任务。
它不会:
写文章;
回复邮件;
生成代码;
解释推理过程。
目前也只支持文本输入,不支持图片、音频和视频。
官方还明确提醒,它不擅长:
精确数学计算;
稳定计数;
日期先后比较;
多层间接推理;
充满大量无关信息的超长输入。
例如:
这张订单是否属于退款问题?
可以交给 Jev。
但:
计算订单金额加税后是否超过预算。
应该交给代码。
再例如:
让 Jev 从文档中判断某个日期是否被提及,可以。
但比较两个日期相差多少天,应该继续由确定性程序完成。
这也是 Jev 最核心的设计思想:
模型只做必须依赖语义理解的部分。
能由普通代码精确计算的事情,继续交给代码。
十三、为什么它叫 Jev?
Jev 这个名字来自英国经济学家:
William Stanley Jevons。
他提出过著名的:
Jevons Paradox,杰文斯悖论。
大意是:
当一种资源的使用效率提高、成本下降以后,人们对它的总消耗未必下降,反而可能增加。
电力越来越便宜后,人类不是少用电。
而是把电接入了更多设备和场景。
TypeSafe 对 Jev 的判断也是类似的。
当一次 AI 语义判断:
足够快;
足够便宜;
足够容易接入代码,
软件就不会只是偶尔调用一次 AI。
而是会把 AI 判断塞进越来越多流程。
过去一个普通 if 的位置。
未来可能变成一次语义判断。
一条客服消息进入系统,背后可以同时完成五六个判断。
一个 Agent 每执行一步,都可以调用 Jev 检查:
意图;
风险;
工具;
质量;
置信度。
单次成本不断下降,最终带来的不一定是 AI 消耗减少。
而可能是:
AI 判断无处不在。
十四、Jev 为什么会突然爆火?
我觉得核心不是它跑分多高。
也不是价格表上的数字有多夸张。
而是它给模型竞争提供了一个完全不同的观察角度。
过去行业一直在问:
模型能不能更大?
能不能想得更久?
能不能处理更复杂的任务?
Jev 提出的另一个问题是:
如果任务根本不需要生成和复杂推理,为什么还要调用一个通用大模型?
它把“智能”拆成了不同层级。
复杂规划和生成交给 System Two。
高频、局部、实时的判断交给 System One。
这并不是要证明 Jev 比 GPT 或 Claude 更强。
而是说明:
软件未来可能不只需要一个全能大脑,还需要大量廉价、快速、可组合的判断神经。
结语
Jev 最值得关注的地方,并不是:
它又便宜了多少。
而是它重新定义了一类过去经常被通用 LLM 勉强承担的任务:
软件内部的语义判断。
它不写文章。
不陪你聊天。
也不输出长篇推理。
它只接收:
当前状态;
预定义问题;
合法答案空间。
然后返回:
判断;
概率;
置信度。
复杂的业务逻辑,仍然由代码掌控。
需要深入分析时,再升级到 Reasoning Model。
这可能会成为未来 Agent 和软件系统里非常常见的一种组合:
System One
→ 快速判断、过滤、路由和检查

System Two
→ 深度推理、规划、生成和执行

普通代码
→ 计算、约束和最终控制
也许下一阶段的软件,并不会每件事都停下来调用一个巨型模型认真思考十秒。
而是会在每一次用户操作背后,快速完成几十个几乎感觉不到的 AI 判断。
把智能做得足够轻。
足够快。
足够便宜。
然后塞进软件里的每一个 if else。
真妙。
妙不可言。
相关链接
TypeSafe AI 官网
Jev 与 System One Model 官方介绍
https://typesafe.ai/blog/introducing-system-one-models-and-jev
TypeSafe 官方文档
Jev 快速开始
https://docs.typesafe.ai/introduction/quickstart
Jev 模型、价格与上下文说明
https://docs.typesafe.ai/models
TypeSafe Workflow Evals
OpenRouter Jev 1.13
https://openrouter.ai/typesafe/jev-1.13
TypeSafe Agent Skill
https://github.com/typesafe-ai/skills
标签




评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。