
B站把 AI 测评做成“电竞榜”了:100+ 模型同场,GPT-6 Astra 暂居第一


…
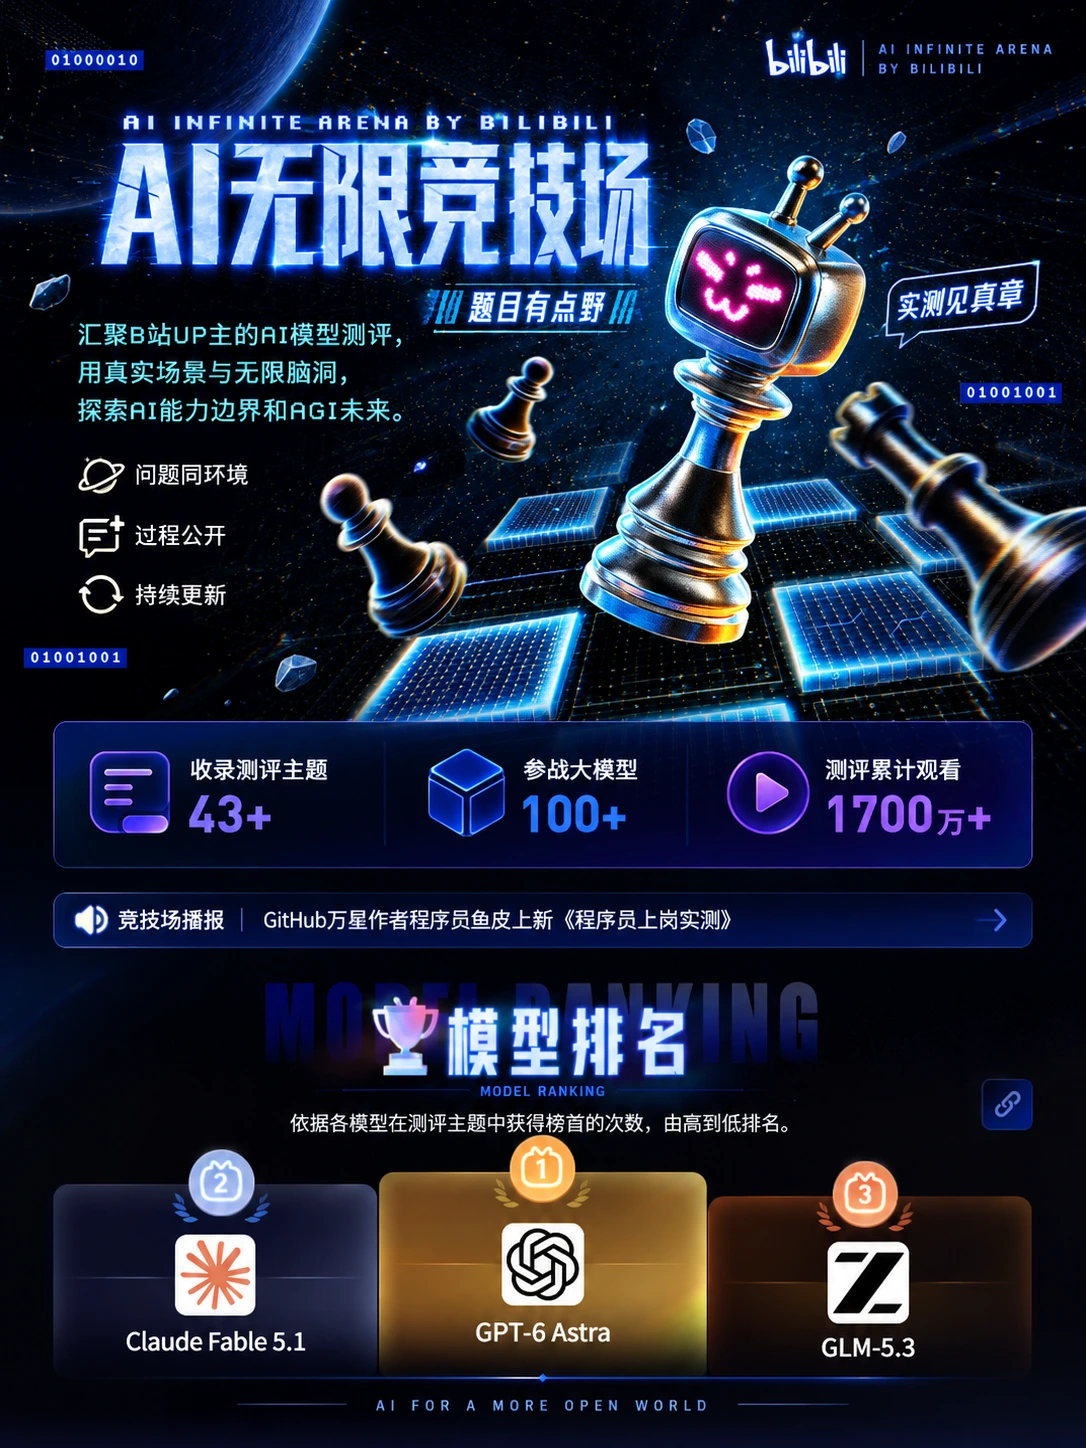
B站终于把:
AI 模型测评
做成排行榜了。
这个新东西叫:
AI 无限竞技场。
玩法非常 B 站。
不是给所有模型发一套固定卷子。
也不是只看:
MMLU;
SWE-bench;
数学;
推理
这些标准 Benchmark。
而是直接把不同领域 UP 主平时那些:
奇奇怪怪但又特别真实的 AI 实测
全部汇总起来。
让:
GPT;
Claude;
DeepSeek;
GLM;
Kimi;
千问;
豆包;
混元;
MiniMax;
Gemini
等模型一起:
上擂台。
然后看谁拿第一最多。
目前暂时坐在头把交椅的是:
GPT-6 Astra。
一、现在已经不只是“十几个模型比一下”
B站刚公布首期榜单时:
主要来自 10 项 UP 主测评。
但整个竞技场本身是:
持续更新的。
截至目前,官方页面已经收录:
43+ 测评主题。
参战:
100+ 大模型版本。
相关测评累计观看:
1687 万+。
所以这里并不是一张:
发布以后就不变的排行榜。
UP 主继续投稿。
新模型继续上线。
榜单也会:
实时变化。
有点像 AI 模型自己的:
联赛积分榜。
二、GPT-6 Astra目前拿了12次第一
按照当前实时榜单:
第1名
GPT-6 Astra
参测:
22 次
拿下榜首:
12 次
榜首率:
54.55%。
第2名
Claude Fable 5.1
参测:
12 次
榜首:
6 次
榜首率:
50%。
第3名
目前包括:
GLM-5.3
以及:
GPT-5.6 Sol
两款模型都拿到:
3 次榜首。
所以现阶段:
GPT-6 Astra 的领先优势还是比较明显。
不过需要注意:
这是动态榜单。
过几天新测评继续加入:
排名完全可能继续变化。
三、这个榜单不是看“总分”,而是看你拿过多少次第一
AI 无限竞技场有一个特别重要的规则:
按照模型在各测评主题中获得榜首的次数排名。
比如:
一个模型参加 20 个测评。
其中 8 个第一。
那它的:
榜首次数就是 8。
另一款模型只参加 5 个测评。
即使赢了 4 次:
最终排名依然可能在前者后面。
所以这个榜单并不是传统意义上的:
统一综合能力分数。
而更像:
冠军数量排行榜。
官方同时还会展示:
参测次数;
榜首次数;
榜首率。
这三个数据放在一起看:
才更有参考价值。
四、最有意思的是:UP主自己出题
传统 Benchmark 最大的问题之一就是:
题越来越固定。
模型厂商知道大家都在测:
代码;
数学;
推理;
知识。
甚至某些 Benchmark 本身可能已经进入训练数据。
B站这套玩法则完全不一样。
它没有规定:
必须测什么。
UP 主根据自己的专业方向:
自己出题。
所以现在竞技场里面已经出现很多:
非常“不标准”的 Benchmark。
五、有人直接拿祖传屎山代码拷打模型
比如编程区。
现在已经有:
屎山论剑·模型擂台战
祖传BUG挑战赛
程序员上岗实测
GTA5 19.8亿次 if 循环修复
AI复刻游戏
各种测试。
有 UP 主甚至直接拿:
真实项目;
历史 BUG;
复杂代码仓库
让多个模型一起修。
最终不是看:
模型说得多专业。
而是:
代码到底能不能跑。
这类测试其实很符合现在 Coding Agent 的真实用法。
毕竟用户真正关心的是:
我把仓库交给你,你到底能不能把 Bug 修掉?
标签




评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。