
8B 也能直接出 4K:商汤 SenseNova U1.5 Lite 开源,AI 生图开始卷“可控编辑”
…
AI 生图现在已经很强了。
但真正拿它干活以后,大家最容易碰到的问题其实已经不是:
“这张图好不好看?”
而是:
“它到底听不听话?”
你花二十分钟写了一大段 Prompt:
主体是什么;
标题放哪里;
有几个元素;
人物站什么位置;
文字必须写什么;
哪些东西不能改;
哪些区域只替换颜色。
结果模型看到后面已经忘了前面。
或者你只是想:
把杯子换成蓝色。
最后 AI 连:
人物的脸;
背景;
光线;
构图
一起重新画了一遍。
这也是现在真正进入设计生产流程以后,一个越来越明显的问题:
AI 会生成,不代表 AI 会稳定修改。
商汤这次开源的 SenseNova U1.5 Lite 正式版,重点盯上的就是这件事。
2026 年 8 月 21 日,商汤正式宣布开源 SenseNova U1.5 Lite。它是一款 8B 级轻量化、原生统一多模态模型,在此前 U1.5 Lite Preview 的基础上继续强化复杂指令遵循、文字与布局、原生 4K、图像编辑和精细视觉控制。
简单一点说:
以前开源生图模型主要卷“能不能画好看”,现在开始继续卷“能不能按照要求把设计真正改对”。
一、SenseNova U1.5 Lite 是什么?
SenseNova U1.5 Lite 是商汤 SenseNova U 系列中的轻量级原生统一多模态模型。
目前正式模型名称为:
SenseNova-U1.5-8B-MoT
这里最重要的几个关键词是:
8B
Native Unified Multimodal
Image Generation
Image Editing
它并不是单纯的一款传统 Text-to-Image 模型。
而是希望在同一个模型体系里同时处理:
语言理解
+
视觉理解
+
空间关系
+
图像生成
+
图像编辑
背后采用的是商汤自己的:
NEO-unify 原生统一多模态架构。
这条路线从 SenseNova U1 就已经开始。
传统多模态系统往往是:
一个模型负责理解图片;
另一个模型负责生成图片;
编辑时再接一套 Pipeline。
SenseNova U 系列则希望把:
理解与生成放进同一个统一表示空间。
所以模型在“看懂图片”之后获得的空间关系和视觉语义,可以继续直接帮助后面的生成与编辑。
这也是它为什么特别强调:
原生统一多模态。
二、这次正式版和 Preview 有什么区别?
SenseNova U1.5 Lite Preview 此前已经展示过:
原生 4K;
更好的材质;
更复杂布局;
图像编辑;
主体保持。
而这次正式版并不是单纯把 Preview 换个名字发布。
商汤重新强化了:
训练数据;
任务设计;
Prompt Enhancement;
后训练流程;
视觉质量;
编辑保持;
复杂指令遵循。
最终重点归纳为六个方向:
1. 更高质量的图片生成
构图、颜色、材质、自然光、真实感和局部细节进一步提高。
2. 更好的文字与信息图
加强中英文文字、海报、信息图和复杂排版。
3. 原生 4K
直接生成高分辨率图片,而不是先低分辨率生成,再简单 Upscale。
4. 更稳定的图片编辑
修改目标内容时,尽量保持人物、结构和其他不需要修改的区域。
5. 更强的复杂指令理解
一次 Prompt 里放入多个对象、数量、布局、文字和风格要求,也能尽量完整执行。
6. 更细的视觉控制
可以结合 Bounding Box、Visual Marker 和参考图控制具体修改区域。
这基本覆盖了现在 AI 视觉真正进入生产阶段以后最常见的几个痛点。
三、先说最容易被误解的:不是“4K 上下文”
SenseNova U1.5 Lite 这次有两个不同的“4K”。
千万不要混在一起。
第一个是:
3–4K 字符级复杂指令。
第二个才是:
原生 4K 图像输出。
官方给出的能力描述是:
SenseNova U1.5 Lite 可以处理约 3–4K 字符长度的复杂视觉指令。
这里说的不是:
4K Token Context Window。
而更接近:
一条 Prompt 可以写得非常长。
对于普通生图可能没感觉。
但设计场景非常有用。
因为真实设计 Prompt 往往不是:
一只猫,电影感。
而可能是一整页:
主标题;
副标题;
产品位置;
价格;
卖点;
人物;
背景;
颜色;
留白;
字体;
哪些区域不能修改;
哪个参考图只参考人物;
哪个参考图只参考版式。
Prompt 很容易几千字。
SenseNova U1.5 Lite 重点提升的就是:
Prompt 变长以后,不要越往后忘得越多。
四、原生 4K 才是这次最直观的亮点
另一个真正的 4K:
就是分辨率。
SenseNova U1.5 Lite 支持:
Native 4K Generation。
传统图片模型很容易采用:
先生成 1024
↓
再放大
↓
再补细节
但 Upscale 并不能完全解决:
细小文字;
纹理;
材质;
复杂建筑结构;
信息图;
高密度排版
这些问题。
因为:
原始图片里不存在的细节,后面再放大也很难凭空补正确。
SenseNova U1.5 Lite 则把训练进一步扩展到了 4K 分辨率,在高分辨率阶段直接处理:
整体构图;
细节;
纹理;
文字;
光影。
官方重点强调的不是单纯:
“图片像素更多。”
而是:
高分辨率下整体结构依然保持稳定。
对于:
海报;
广告;
电商;
品牌视觉;
摄影;
壁纸;
信息图
这类场景,比单纯生成一张 1024 图片实用很多。
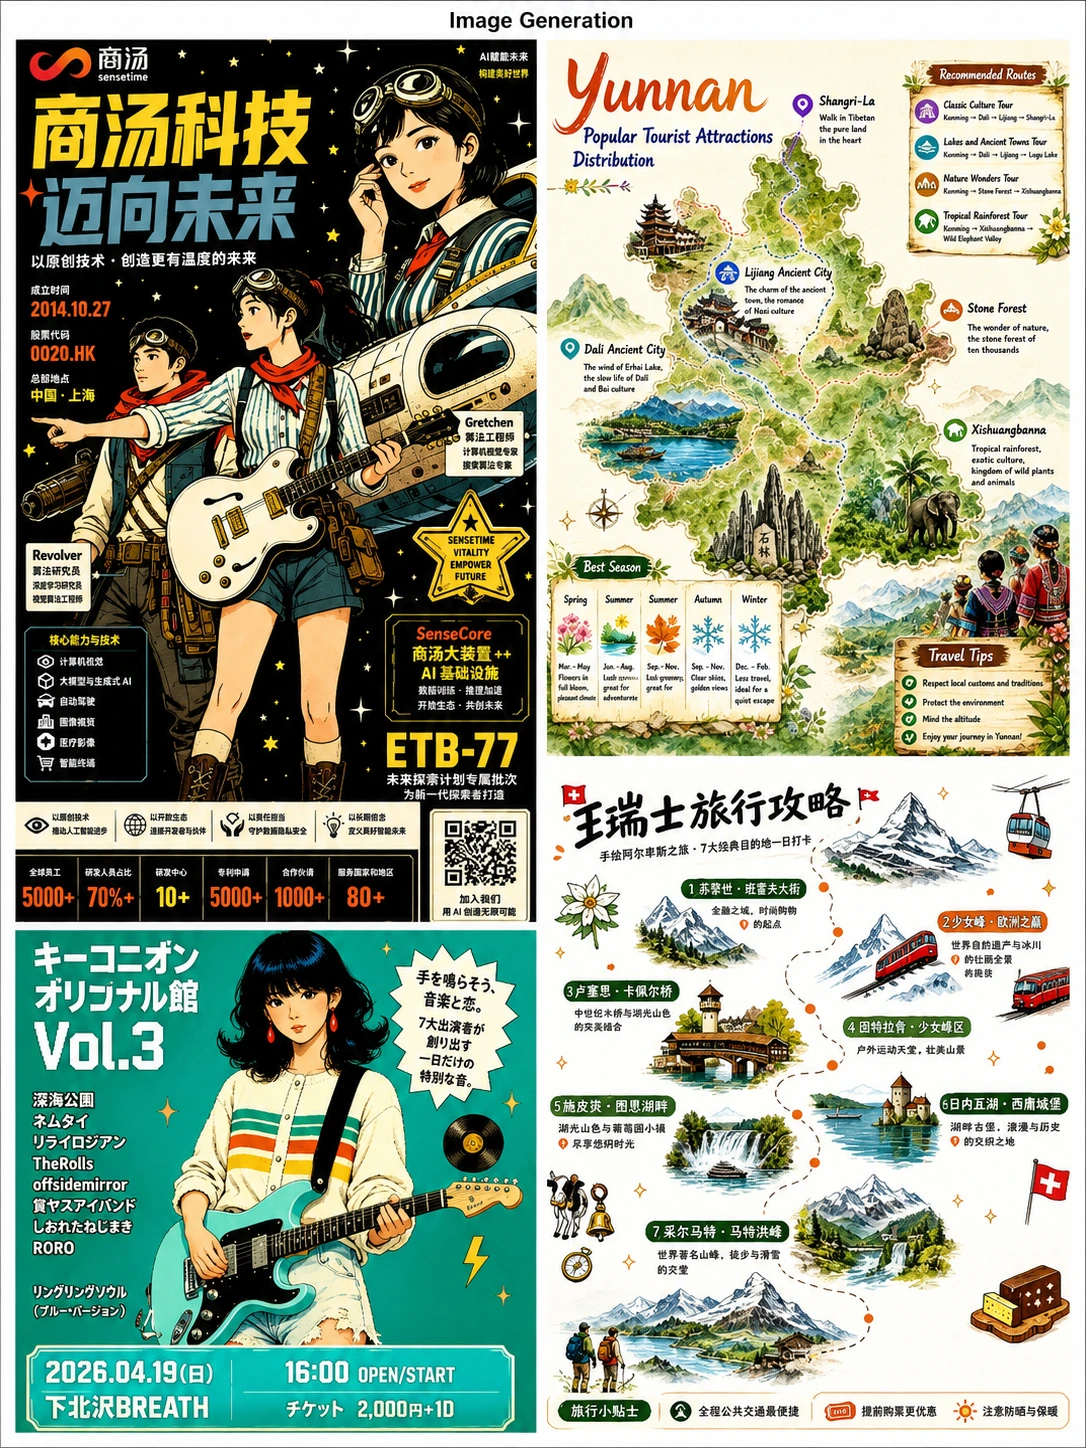
五、文字和复杂排版,是 U1.5 Lite 很值得看的能力
现在图片模型已经很会画:
人物;
风景;
产品;
电影画面。
但真正让设计师头疼的,还是:
文字。
尤其中文。
一张海报里面只有:
“夏日新品”
四个字。
现在很多模型已经能处理。
但如果是:
主标题;
副标题;
说明;
数字;
多个标签;
多个信息区块;
中英文混排。
错误率马上上升。
SenseNova U1 系列此前就专门发展过 Infographic 模型。
这次 U1.5 Lite 正式版继续把这套能力融合进统一模型里,加强:
中英文文字;
复杂海报;
信息图;
品牌视觉;
密集排版。
所以它真正想做的已经不只是:
AI 插画模型。
而是在往:
AI 视觉设计模型
靠。
六、信息图可能是它最适合的场景之一
为什么现在很多图片模型做信息图特别容易翻车?
因为一张信息图需要同时理解:
内容
+
文字
+
层级
+
数据
+
图标
+
布局
+
空间关系
+
视觉风格
这里任何一项错掉:
整张图都没法交付。
例如:
文字写对了,但对应错栏目。
数据没错,但是标签指向错误。
版式很好看,却少了一块内容。
SenseNova U1.5 Lite 强调多层级空间映射和复杂布局,就是想提高这一类任务的一次性交付率。
所以如果你平时会做:
数据报告;
科普信息图;
流程图;
产品介绍图;
教育知识图;
社交媒体长图。
这类能力值得重点测试。
七、图片编辑可能比“文生图”更值得关注
其实现在 AI 图片模型越来越多以后,我反而觉得:
编辑能力比纯生成更重要。
因为真实工作里很少是:
一次生成,直接交稿。
更多时候是:
第一版不错。
然后:
标题换一下。
产品位置不动,把背景换成海边。
人物脸别改。
把左边的杯子去掉。
其他东西全部保持。
颜色从绿色换成红色。
这才是正常的设计工作流。
问题是很多 AI:
重新生成比精准修改更擅长。
你让它改 10%。
它可能顺便把剩下 90% 也重新画了。
SenseNova U1.5 Lite 正式版则特别强化:
Editing Preservation。
也就是:
修改该改的,保留不该改的。
八、人脸、主体和空间结构尽量保持
例如上传一张人物照片。
你只说:
把黑色外套改成蓝色。
理想结果应该是:
人物还是这个人;
脸不变;
姿势不变;
背景不变;
光线不变;
构图不变。
只改:
衣服。
SenseNova U1.5 Lite 在训练阶段专门强化:
主体身份保持;
空间结构;
未编辑区域保持。
所以它想减少现在 AI Editing 很常见的问题:
越改越不像原图。
这对于:
商品图;
人物;
品牌视觉;
广告;
电商
特别重要。
九、多参考图也能一起用
SenseNova U1.5 Lite 不只是:
单图编辑。
还支持:
Multi-reference Editing。
例如你可以同时给:
图片 1:人物;
图片 2:衣服;
图片 3:场景;
然后告诉模型:
使用图 1 的人物,换上图 2 的衣服,放进图 3 的环境中。
真正困难的地方不是:
简单把三张图片复制粘贴。
而是:
让它们在新的画面中拥有统一:
透视;
比例;
颜色;
光线;
空间关系。
官方案例中已经展示了多参考图主体融合、美食海报重组等场景。
对于:
电商;
广告;
品牌;
商品合成
会非常实用。
十、还支持 Bounding Box:告诉 AI“就改这里”
这也是很实用的一点。
SenseNova U1.5 Lite 支持通过:
Bounding Box
进行局部区域控制。
也就是可以指定:
x1,y1
↓
x2,y2
告诉 AI:
操作范围就在这个框里面。
比如:
把右上角这个模块改掉。
而不是让模型自己猜:
“右上角”到底指哪里。
视觉生成模型越往专业工具发展,这类:
明确的空间坐标控制
就会越来越重要。
十一、Visual Marker 更适合普通用户
普通用户可能不会去填 Bounding Box 坐标。
所以它还有更直观的:
Visual Marker。
例如直接在原图:
画一个红框;
画箭头;
做标记。
然后告诉模型:
把红框里的英文翻译成中文,其他区域保持不动,生成结果中不要保留红框。
AI 会把:
视觉标记
当成编辑指令的一部分。
以后图像编辑很可能越来越接近:
在图上圈出来
+
说一句话
=
完成编辑
这种交互其实比复杂 Prompt 更符合普通人的使用习惯。
十二、文字也可以直接精修
它还有一个很有意思的场景:
只改图片里的文字。
例如海报里原本写:
PEARL
你可以要求:
改成:
HORIZON
同时:
版式不变;
字体风格不变;
背景不变;
其他文字不变。
或者:
只把某一个中文菜单名称替换掉。
这已经很接近:
AI 版局部文字编辑工具。
现在 AI 海报最大的问题之一就是:
整体设计很好看。
结果一个字错了。
最后整张重新抽卡。
如果文字能够独立修:
工作流会舒服很多。
十三、草图也可以直接变成完成稿
SenseNova U1.5 Lite 还适合:
Sketch-to-Image。
例如自己先画:
一张很粗的线稿。
只定义:
构图;
人物;
几个区块;
标题位置。
再告诉模型:
保留当前版式和人物关系,把整张图渲染成复古暖色漫画。
模型继续补:
色彩;
材质;
光影;
背景;
文字风格。
对于设计师来说:
AI 就不一定负责:
替你设计。
而是:
把你的设计意图做出来。
这两种使用方式差别很大。
十四、为什么只有 8B 也能塞这么多能力?
这一点其实是 SenseNova U1.5 Lite 技术上比较有意思的部分。
现在视觉模型想同时处理:
文字;
美学;
编辑;
理解;
生成。
常见方法可能是:
一个 Router。
不同任务分别调用不同 Expert。
例如:
文字交给 A;
图片美学交给 B;
编辑交给 C。
问题就是:
系统复杂;
显存高;
延迟增加。
SenseNova U1.5 Lite 采用了一种叫:
MOPD
的方式。
训练阶段:
可以分别训练:
文字 Expert;
美学 Expert;
编辑 Expert。
然后在交付阶段,通过多专家在线策略蒸馏,把这些能力继续融合进:
一个单体 8B 模型。
所以使用时不需要不停调用多个专家。
官方称 8B 规模可以支持单卡运行,并通过单次 Pass 同时处理语义理解和像素生成。
这也是 Lite 最值得关注的一点:
不是只追求模型大,而是尽量把复杂视觉能力塞进更小的部署规模里。
十五、对开发者来说,“单卡”比 Benchmark 更现实
一款开源模型 Benchmark 再高。
如果部署需要:
8 张 H100。
普通开发者基本等于:
没开源。
SenseNova U1.5 Lite 的路线明显更偏:
可部署。
8B 级规模意味着:
开发者可以进一步尝试:
私有部署;
企业视觉系统;
本地创作;
定制工作流;
ComfyUI;
垂直 Fine-tuning。
GitHub 当前甚至已经同时开放:
正式模型;
SFT 权重;
以及用于加速推理的 8-step LoRA。
对于真正想把视觉模型塞进自己产品的人,这类东西往往比单纯在线 Demo 更重要。
十六、正式模型使用 Apache 2.0 License
目前 SenseNova U1.5 正式模型页面标注为:
Apache License 2.0。
对于开发者来说,这比仅:
“开放一个在线体验地址”
更重要。
因为你真的可以:
下载模型;
研究;
部署;
进一步开发自己的应用。
当然真正用于商业项目时,仍然应该结合:
模型 License;
依赖 License;
使用场景;
生成内容版权
进行完整检查。
十七、它适合哪些人?
UI / 平面设计师
特别适合测试:
海报;
信息图;
品牌视觉;
文字排版;
局部修改。
电商设计
可以处理:
商品主图;
场景图;
广告图;
参考图融合;
文字修改;
商品元素替换。
内容创作者
可以生成:
小红书封面;
公众号配图;
科普长图;
社交媒体海报。
广告和品牌团队
适合:
KV;
Campaign;
产品海报;
品牌素材扩展。
AI 开发者
可以用于:
自建图片工具;
AI Design Agent;
内部设计平台;
图片编辑 API;
本地视觉工作流。
独立开发者
相比必须调用大型闭源 API:
8B 开源模型的本地部署可能更加有吸引力。
十八、如果你做电商,可以怎么用?
例如你有:
一张手机产品图。
可以尝试:
保留产品本身尺寸、颜色、Logo、按钮结构和摄像头位置不变,将背景替换成深灰色高端科技发布会场景。产品位于画面中央偏左,右侧加入标题“轻薄,但不轻性能”,下方增加三个参数卖点,使用白色极简无衬线字体,保持足够留白,输出 4K 横版广告图。
这里同时包含:
商品保持;
背景替换;
空间;
中文;
排版;
视觉风格;
4K。
这种复杂 Prompt 正好是 U1.5 Lite 想重点解决的场景。
十九、做海报,可以把 Prompt 写得更完整
比如:
生成一张 3:4 科技媒体封面。主标题“AI 视觉模型开始卷 4K 了”,放在画面上方,占画面约 30%,使用粗体无衬线字体。中央是一台悬浮的透明计算设备,内部出现图像生成、文字、编辑和 Bounding Box 四个视觉模块。背景以银灰和浅蓝为主,不要赛博霓虹,不使用紫色渐变。底部左侧加入“SenseNova U1.5 Lite”,右侧加入“8B / Native 4K”。画面整体简洁、有留白、具有科技编辑杂志感。
以前长 Prompt 最容易的问题就是:
后面那些限制 AI 直接没看见。
而复杂 Prompt 遵循本身就是这一代重点增强项。
二十、多轮修改才是真正考验
真正设计工作不会只改一次。
可能是:
第一轮:
把海报改成红色。
第二轮:
产品别动,主标题换成中文。
第三轮:
左边加一个参数模块。
第四轮:
人物不要变化,只把背景换掉。
每修改一轮:
模型都有可能慢慢偏离原图。
这叫:
Editing Drift。
SenseNova U1.5 Lite 通过增强 Editing Preservation,希望支持更长的持续修改流程。
这其实比:
第一张图生成得多漂亮
更能决定 AI 能不能真正进入生产工具。
二十一、不过它现在也不是完全没有问题
这点官方模型卡自己也写得比较明确。
目前仍然存在几个限制。
1. 高密度文字仍可能出错
特别是:
大量小字;
中英文混排;
很密的信息图。
不能保证 100% 正确。
2. 极端严格的布局仍可能偏差
例如:
必须正好 17 个元素;
每一个都严格对齐;
每个层级完全一致。
仍可能出现问题。
3. 小人脸和手部细节仍可能不稳定
尤其人物在画面中比较小时。
4. 复杂多轮编辑依然可能漂移
如果你同时要求:
改很多区域;
使用多张参考图;
又必须保持大量原内容。
编辑稳定性仍有提升空间。
所以不要把:
“编辑更强”
理解成:
“Photoshop 可以删了。”
目前还没到这一步。
二十二、SenseNova U1.5 Lite 真正有意思的地方是什么?
如果只看参数:
8B。
4K。
很容易把它理解成:
又一个开源生图模型。
但它真正值得关注的方向其实是:
长 Prompt
+
文字
+
复杂布局
+
生成
+
编辑
+
多参考图
+
区域控制
+
多轮修改
正在逐渐被放进:
同一个模型。
这才是“原生统一多模态”真正想解决的问题。
以前不同任务需要:
一个生图模型;
一个编辑模型;
一个 OCR;
一个多模态理解模型;
再接一堆工具。
现在大家都在尝试:
一个模型自己理解,再自己生成和修改。
二十三、AI 图片下一阶段,可能不再只是比“谁画得最好看”
过去 AI 图片模型最容易比较的是:
写实度。
美学。
人脸。
光影。
但继续进入真实工作流后,新的指标会越来越重要:
Prompt 到底听不听。
中文字到底准不准。
版式能不能控制。
局部修改会不会毁整张图。
同一个人物能不能保持。
能不能连续改十轮。
本地能不能跑。
所以视觉模型竞争开始从:
Image Generation
逐渐扩展成:
Visual Creation Workflow。
这可能才是 SenseNova U1.5 Lite 最值得关注的地方。
结语
商汤这次开源 SenseNova U1.5 Lite,我觉得可以记住几个关键词:
8B。
3–4K 字符复杂指令。
Native 4K。
文字与复杂布局。
多参考图。
Bounding Box / Visual Marker。
原生图像编辑。
以及:
单卡部署。
相比单纯再做一个更大的图片模型,它明显更关注:
真实设计工作到底需要什么。
特别是:
“只修改这里,其他东西千万别动。”
这种看起来简单、实际上 AI 最容易翻车的需求。
对于设计师、内容创作者和电商来说:
原生 4K 和文字排版会比较直观。
对于开发者来说:
8B、Apache 2.0、本地部署和完整开源生态可能更加重要。
而且这次正式版已经不只是 Preview。
目前模型权重、GitHub、Hugging Face、ModelScope 和在线体验入口都已经开放。
如果你最近正好在找:
可以本地部署、同时兼顾生图和图片编辑的国产开源视觉模型。
SenseNova U1.5 Lite 确实值得试试。
相关链接
SenseNova U1.5 Lite 官方发布介绍
https://www.sensetime.com/cn/news/sense-nova-u1-5-lite-4-k
SenseNova U1 GitHub 开源仓库
https://github.com/OpenSenseNova/SenseNova-U1
SenseNova U1.5 Hugging Face 正式模型
https://huggingface.co/sensenova/SenseNova-U1.5-8B-MoT
SenseNova U1.5 Hugging Face 模型合集
https://huggingface.co/collections/sensenova/sensenova-u15
SenseNova U1.5 ModelScope / 魔搭社区
https://modelscope.cn/models/SenseNova/SenseNova-U1.5-8B-MoT
SenseNova Studio 在线体验
SenseNova U1 论文
https://arxiv.org/abs/2605.12500
OpenSenseNova GitHub 官方主页
https://github.com/OpenSenseNova
标签
评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。