
我发现了 AI 视频创作者的 Blender · 5000字实测教程分享

…
大家好,因为我个人非常喜欢《凡人修仙传》,上周的187集播出后 “黄龙山PV“ 想必道友都看了,我是鸡皮嘎达起了一身,可以想象后面有多么精彩。
自从看了凡人以后日漫看的较少了,只要是写文章或者测试就会做一些凡人的二创视频给自己解解渴,要不等一周更新太难熬了,同时在创作过程中我发现多角色很难控制,比如我要韩立、宋玉、慕佩灵、梅凝等角色依次站位,文本输出始终达不到我的要求。
比如:文字生成视频是下面的效果,镜头语言是韩立慕佩灵一起走进来,并且紫灵、梅凝还有宋玉从左到右坐着,现在视频既多了梅凝,又少了宋玉,站位也都不准确,慕佩灵居还坐下了,有些离谱了。
再看看我用这个功能之后,白模和生成视频后的效果!
怎么样?惊不惊喜?我知道人一惊讶就有心里话要说,你至少有三句心里话,哈哈哈哈哈...根据生成效果,多人角色站位问题和角色缺失或多出的问题彻底解决了,这波真得给到夯~ 那么是什么平台功能呐?请大家往后看什么叫惊喜~

updream 预演台
先说结论:该功能主要是控制角色在场景里的连续一致性,纯文本提示词在表达画面中的空间布局、角色姿态和构图都是不精准的,甚至是难以控制的。
说人话就是文生图、文生视频构图随机性很高,强控制就需要解决方案。2023年斯坦福大学有一篇论文详细的描述了该问题,并给出 3 种控制方法:
· 边缘控制「也就是线稿」适合角色设计、产品设计、IP类设计。
· 姿态控制「人体骨架」适合特定角色姿势。
· 深度控制「控制空间关系」摄影角度、场景层次,也就是电影分镜。
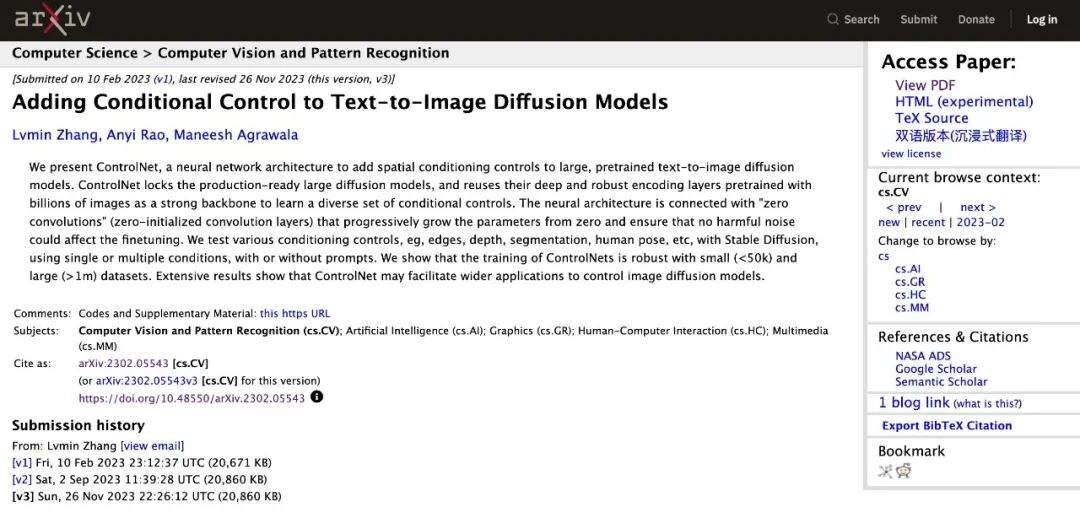
地址:https://arxiv.org/abs/2302.05543
-
以上问题在 Stable Diffusion 期间有得到解决,但是在当时的情况下并没有好的模型出现「这里指的是视频模型,图像模型当时已有解决但风格油腻」,再结合现在的 Seedance 2.5 视频模型,官方有详细的阐述:用户可以用无纹理 3D 模型搭出画面的空间结构、主体姿态、运动轨迹和镜头机位,再让模型参考这套结构生成视频。
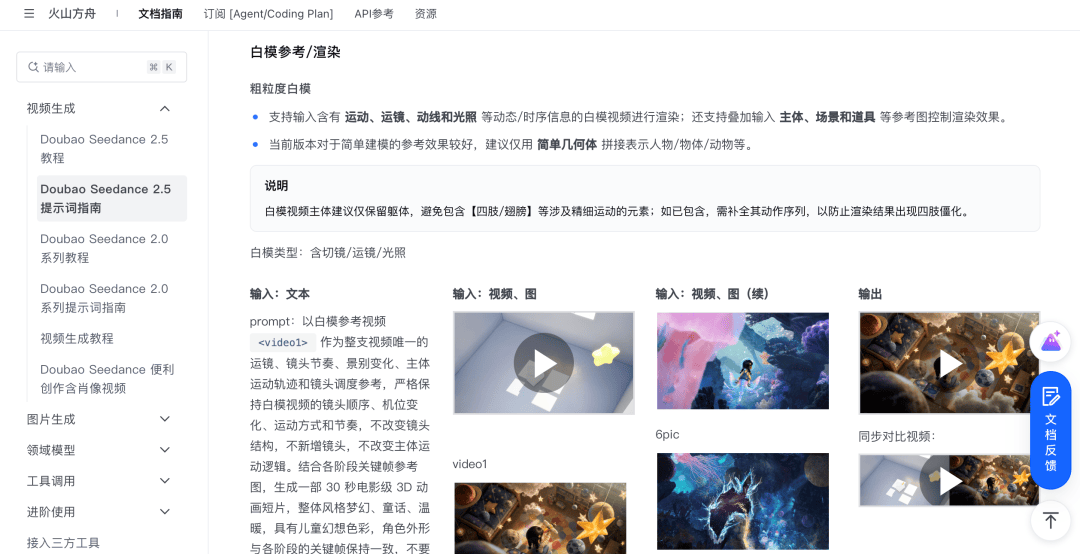
地址:https://docs.volcengine.com/docs/82379/2607689?lang=zh
-
接下来要说重点了,通过以上论文证明白膜参考比纯文字更可靠,Seedance 2.5 官方也强化了白模理解能力并给出了提示词规范,那么对于没有学过 3D 建模的人又想强控制画面,updream 预演台功 能诞发布了。
1.单一角色与场景
前期准备:利用上期 Midjourney niji 7 模型进行生成图像,建议生成广角图、鸟瞰图、全景图、纵深图等等。主要是对场景的搭建并且画面中最好不要出现角色,因为角色需要搭建完场景后自行添加「我属于邪修比较懒,生成想要的丢到 updream 画布里进行去掉角色即可」。
提示在上期文章里~
-
· 点击新建项目画布,上传一张静态场景图像,再拖出图像节点选择香蕉pro模型,附上提示:去掉画面中的人物角色,并保留背景!
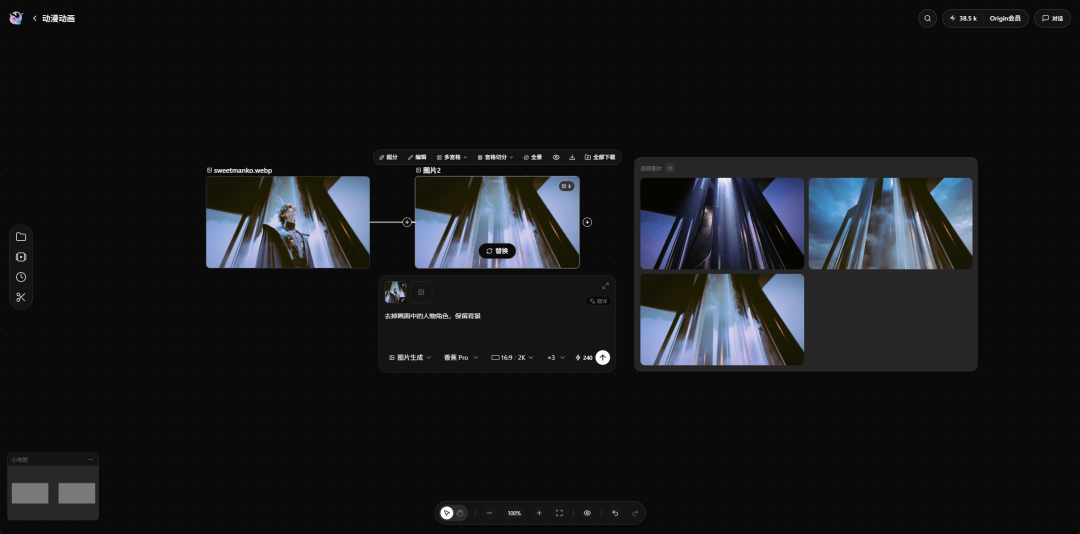
香蕉pro 是非常好用且稳定的图像生成模型,点击图像上方栏里的 “全景图像” 生成后双击图像,选择 “专业” 并调整画面,再点击“捕获镜头”,画布里自动生成对应图像。
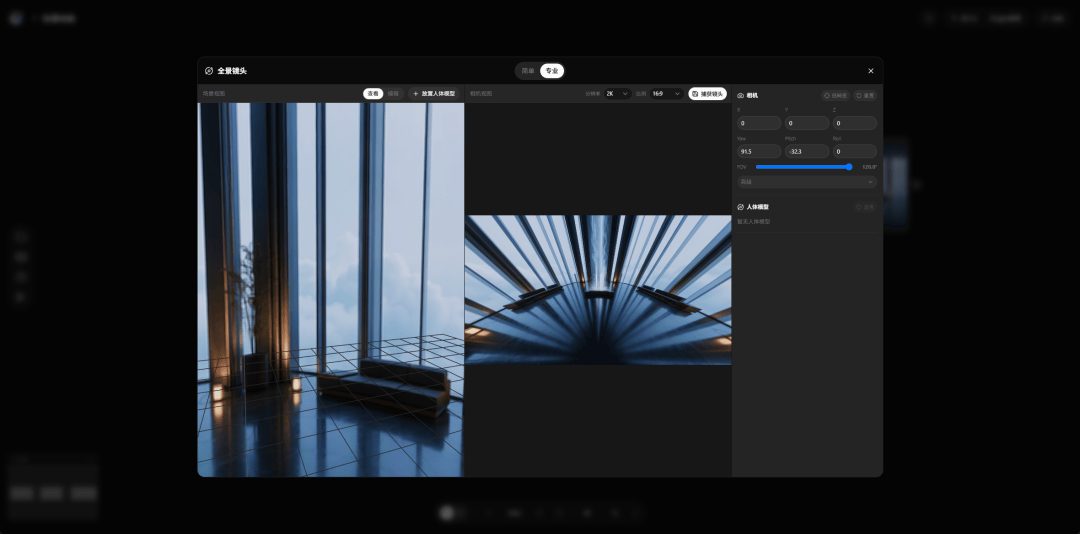
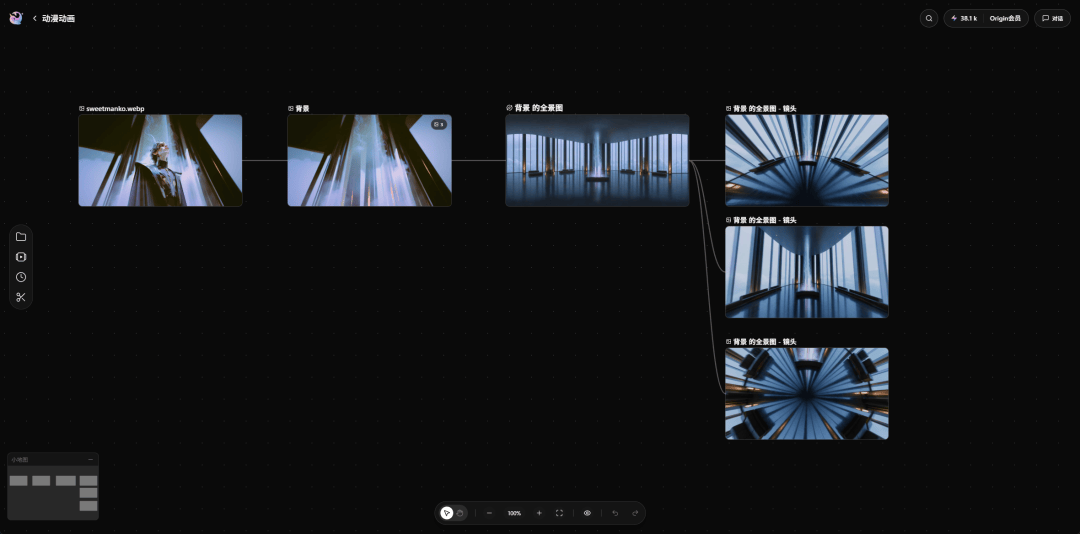
· 继续在画布空白处右键找到 “新建预演台”,选择刚生成的三张图像进行连接节点,打开预演台进入主页面。
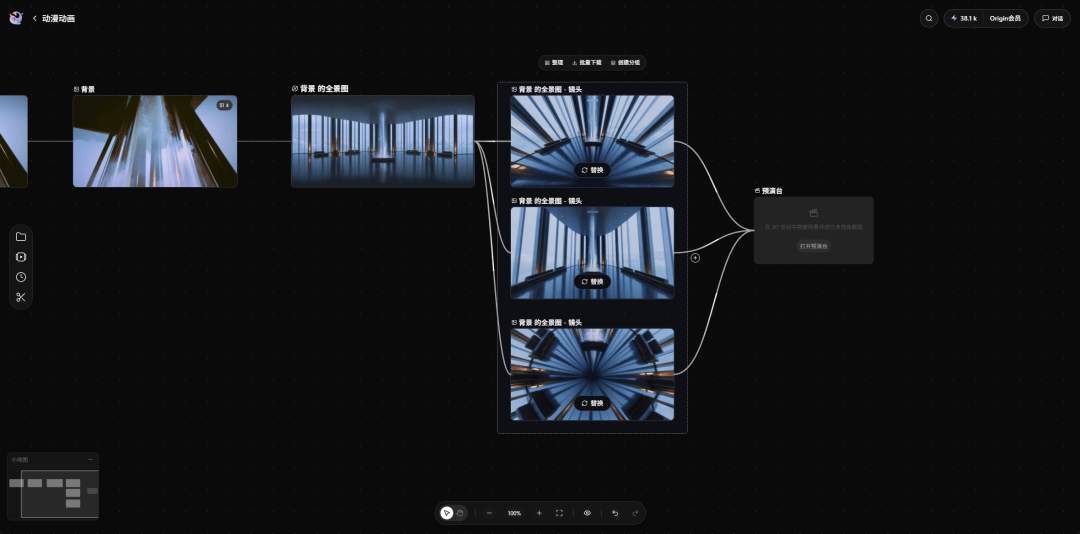
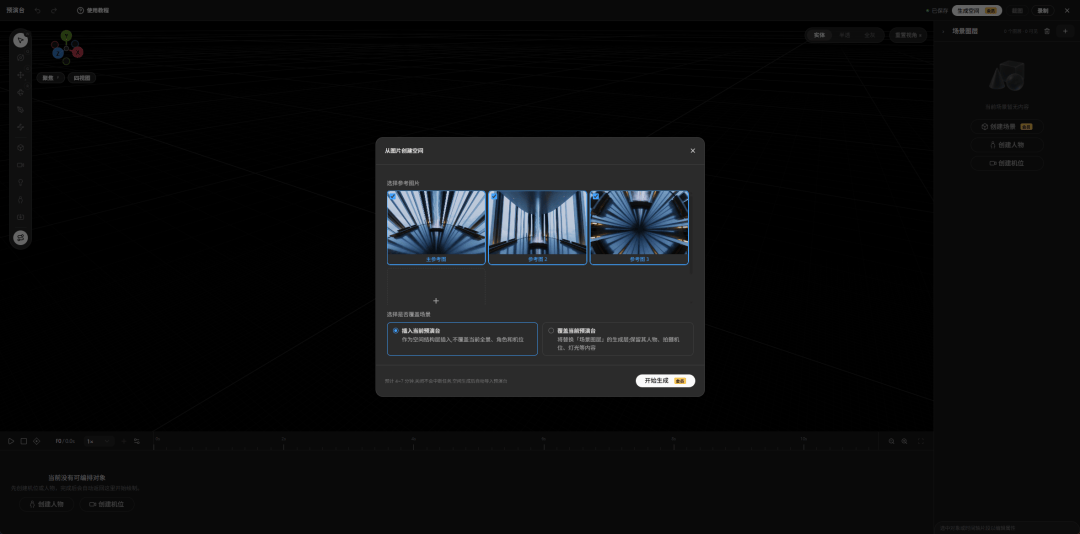
注意:最多三张参考图「包括上传也是三张」,之后等待4-7分钟。在过程中不能创建人物和机位;上传参考图的目的是生成场景白模,人物需要搭建完场景之后添加~
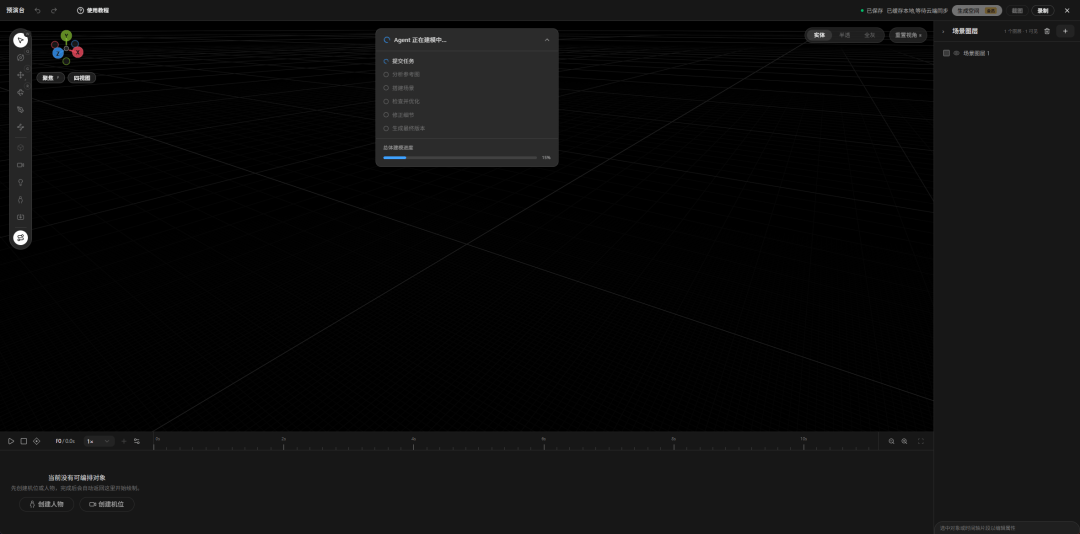
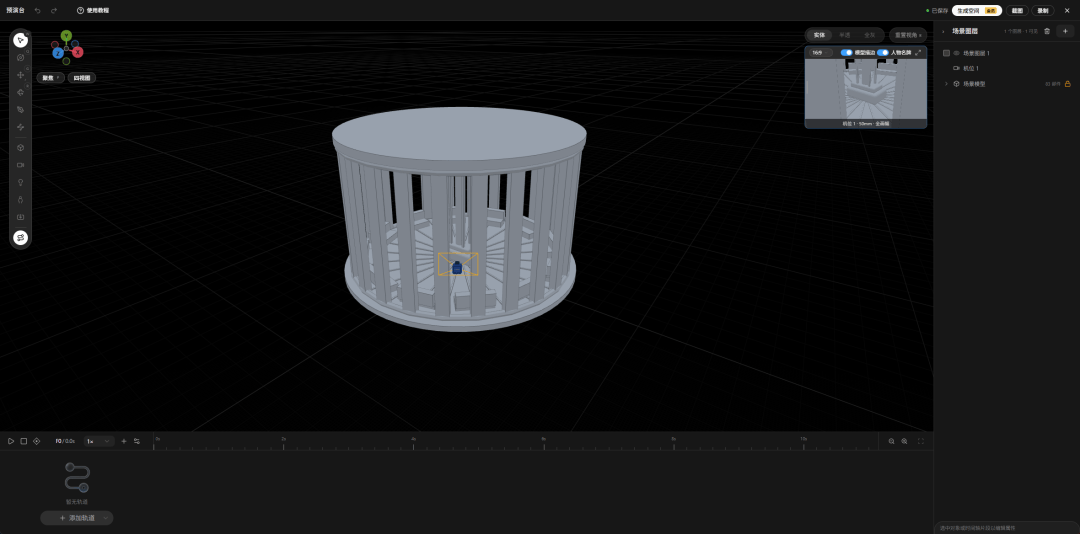
我发现利用 全景图像 生成的场景偏向圆柱体积,我又重新在画布单独托出图像节点,分别生成广角、鸟瞰图、全景图像并继续上面的步骤,看看建模场景有何区别~
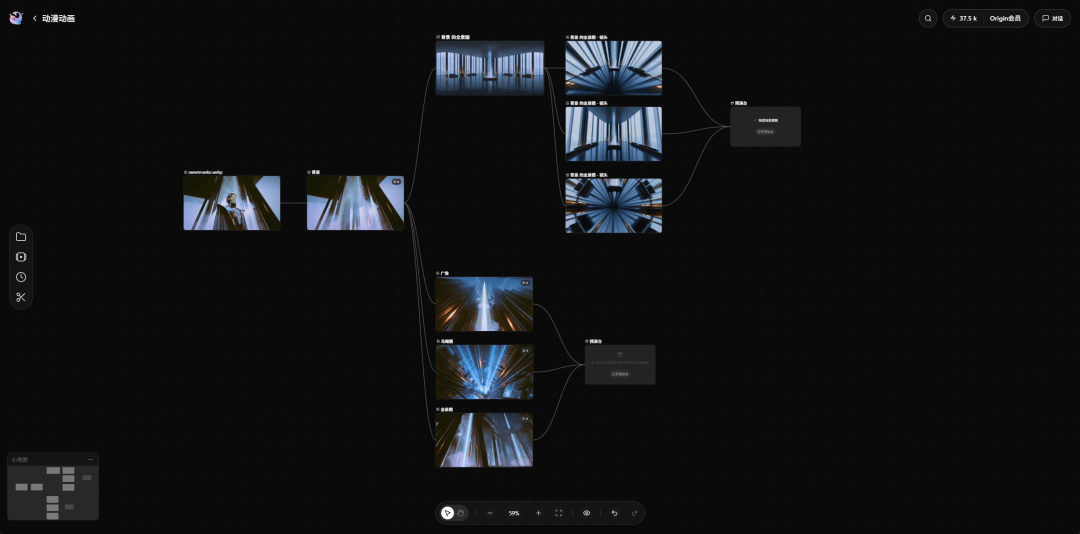
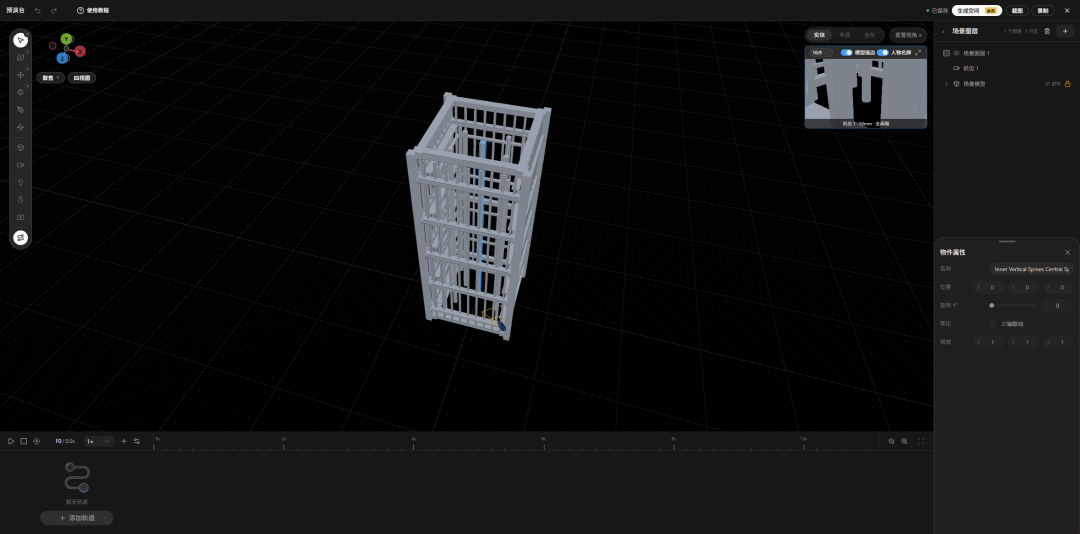
注意:其实从一开始在场景不明确且图像场景抽象的情况下,会出现场景很封闭这个问题,但不是说不能应用,继续下个步骤。
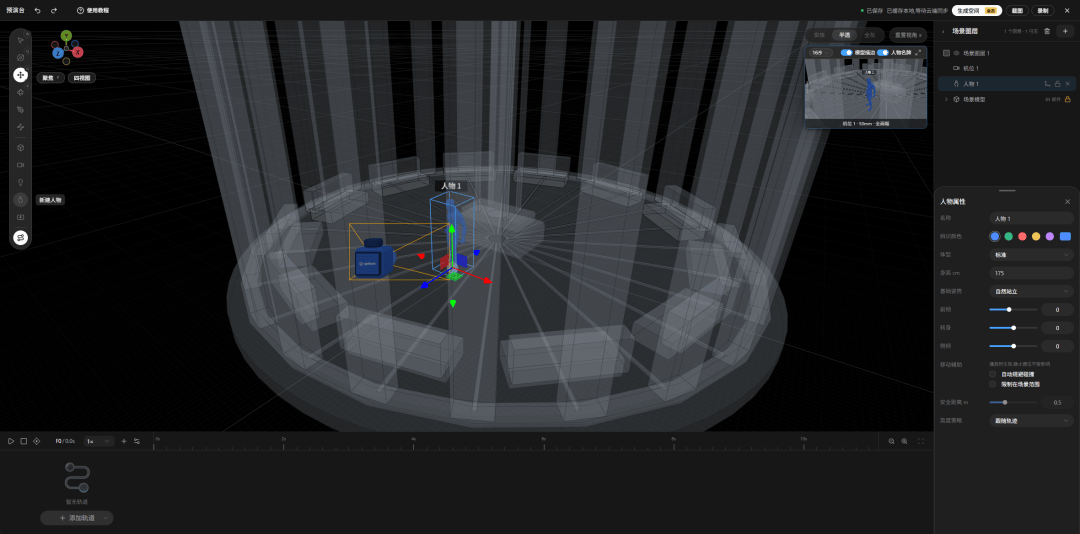
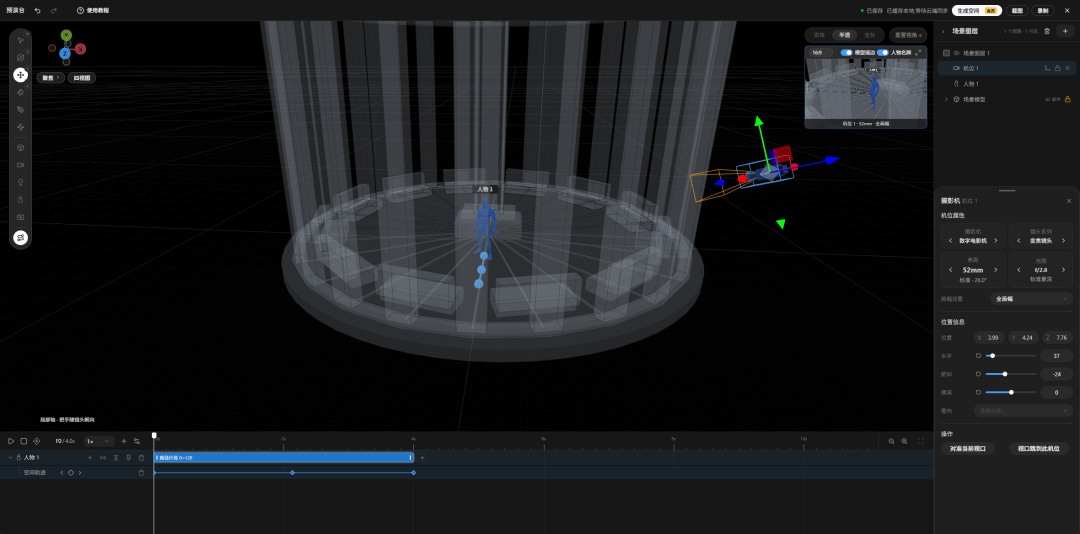
左侧栏倒数第 3 个图标 “新建人物”,点击出现角色模型,用鼠标操控场景和角色的缩放、移动等。比如鼠标滚轮是放大或缩小、右键长按是拖动移动、鼠标长按中键或者快捷键Q是旋转功能等。
-
把角色视角拉近,进行简单的修改角色的姿态,右侧可调节的常用选项。右上角的摄像机机位就是目前所展示的样子,也可以用鼠标进行拖拽找到比较好的镜头分镜。
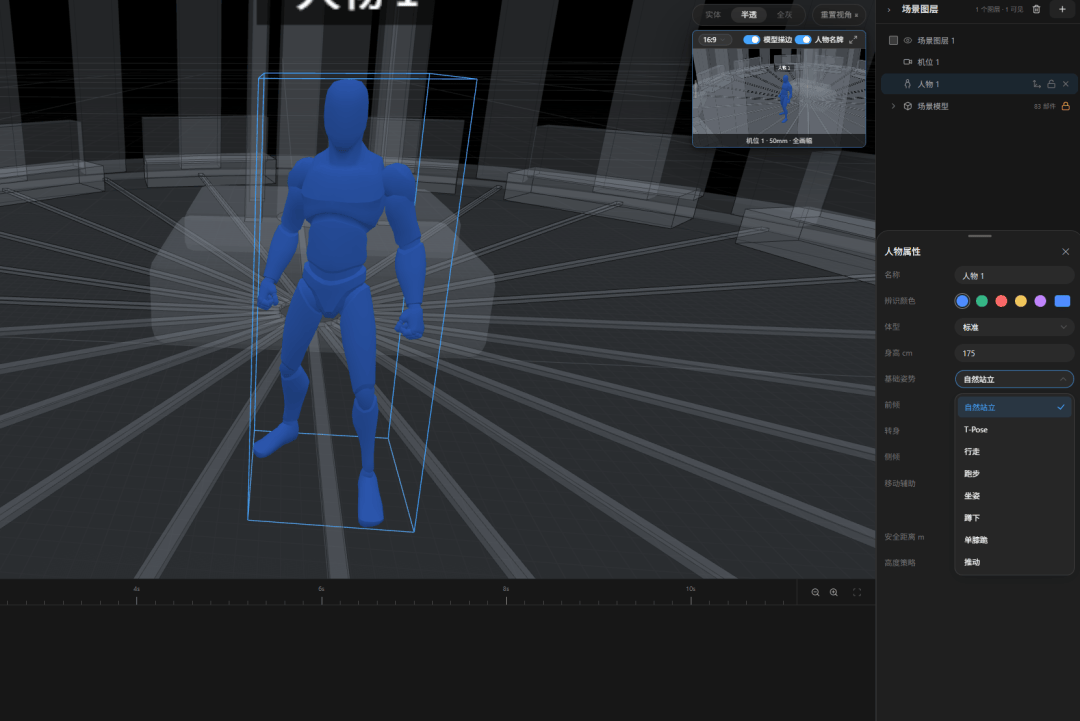
这里有个小知识点:在左侧栏有个钢笔工具,简单的画一条线,会自动打上移动的关键帧来让角色跟着这条线走动。
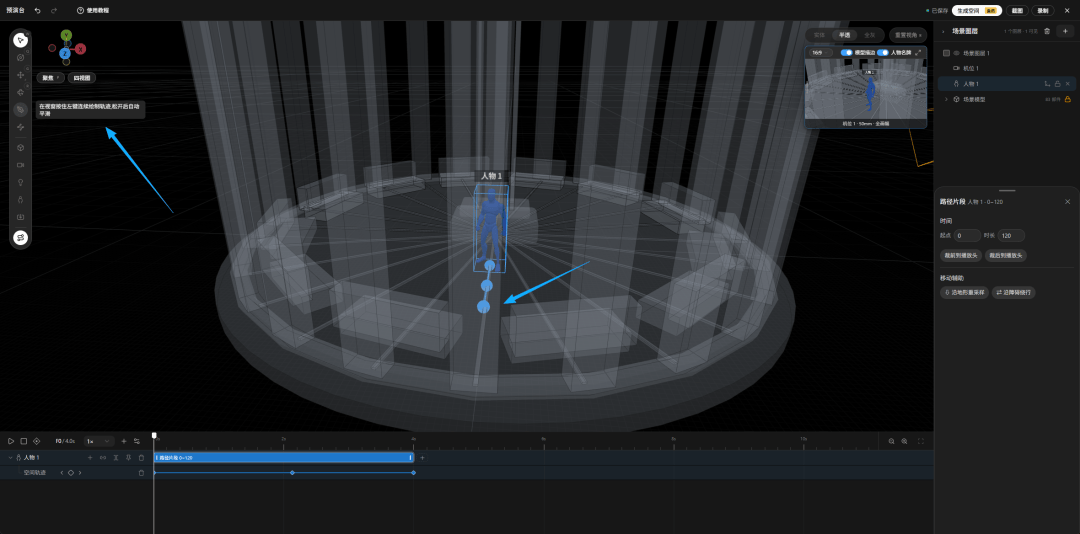
再看摄像机,右侧也是可以设置的:水平、横移、俯仰等。时间轴里可以添加机位,关联上人物,摄像机会跟随角色移动。
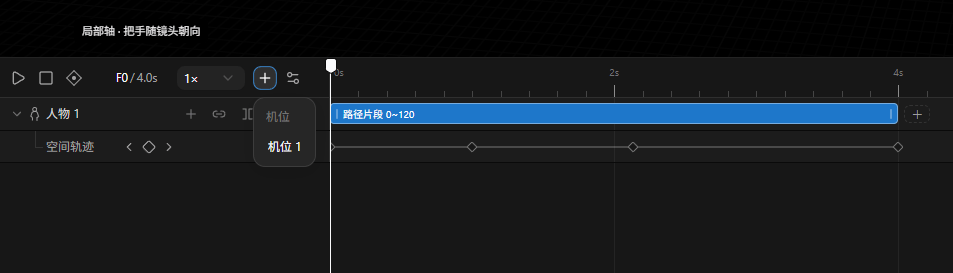
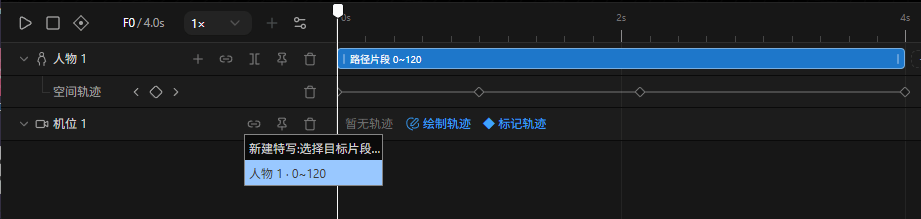
右侧运镜改为环绕,点击 “转为路径片段”,可以看到摄像机的调度。
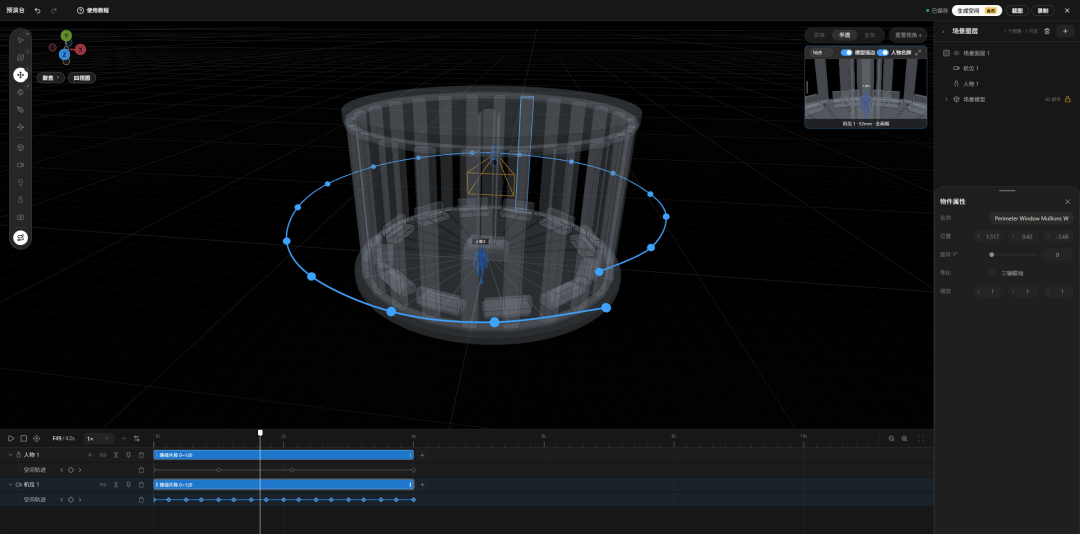
调整完毕后点击右上角 “录制” ,该片段会同步到画布上。回到画布可以看到刚才录制的白模视频,剩下的就是生成视频即可。
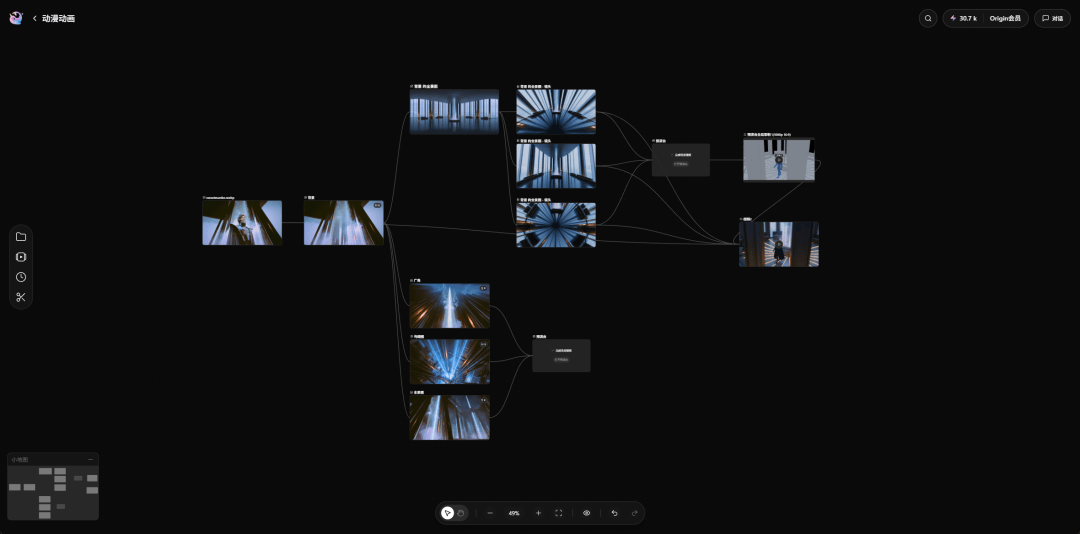
以下是摄像机轨道录屏以及白模对比~
拖出视频节点,把上传的风格角色图像,还有录制的白模节点链接上,用 Seedance 2.5模型,附上提示词:以白模参考视频 [预演台全局录制] 作为整支视频唯一的运镜、镜头节奏、景别变化、主体运动轨迹和镜头调度参考,严格保持白模视频的镜头顺序、机位变化、运动方式和节奏,不改变镜头结构,不新增镜头,不改变主体运动逻辑。结合各阶段关键帧参考图,生成一部 5 秒电影级 3D 动画短片,整体风格遵循参考图像 [风格图像] ,角色外形与各阶段的关键帧保持一致,不要改变角色形象,人物表情情绪随场景变化而改变。
-
注意:这类属于粗粒度白模,含有运动、运镜、动线和光照等动态/时序信息的白模视频进行渲染;还支持叠加输入主体、场景和道具等参考图控制渲染效果。当前测试对于简单建模的参考效果较好,建议仅用 简单几何体 拼接表示人物/物体/动物等。
所有画面均参考对应关键帧,白模视频仅作为运镜、镜头运动和角色动画参考,不参考画面内容。
2.坠魔谷商议-多人角色
看过《凡人修仙传》的都知道,影视版权属于哔哩哔哩的,这次根据 “预演台” 功能看看我操作的步骤是什么,可作为参考和学习~
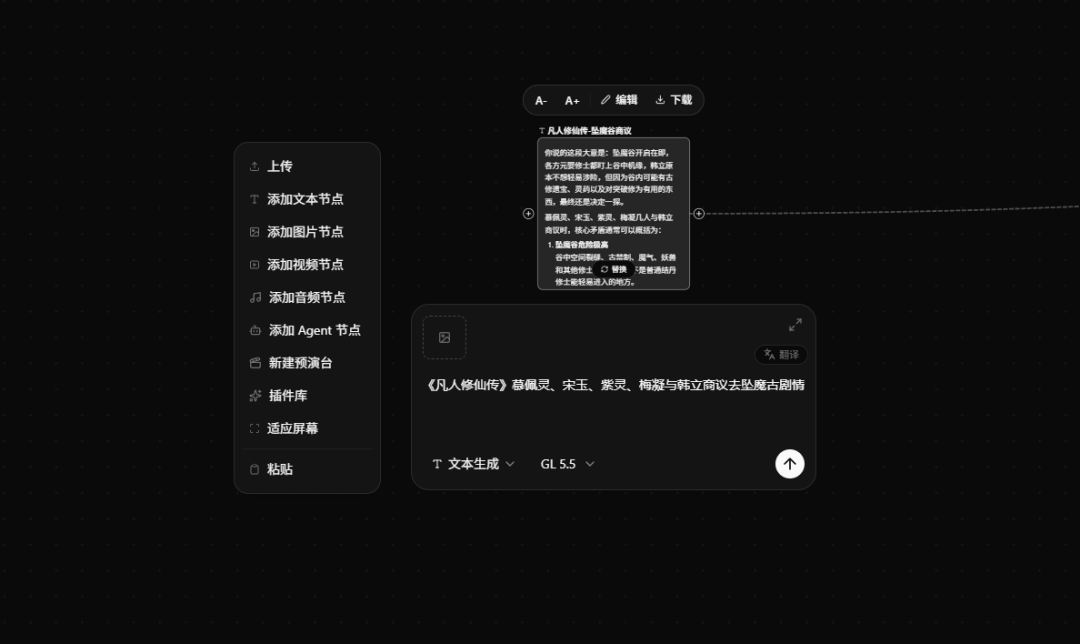
在画布上点击添加文本节点,模型不需要修改,附上简单的提示:《凡人修仙传》慕佩灵、宋玉、紫灵、梅凝与韩立商议去坠魔古剧情。
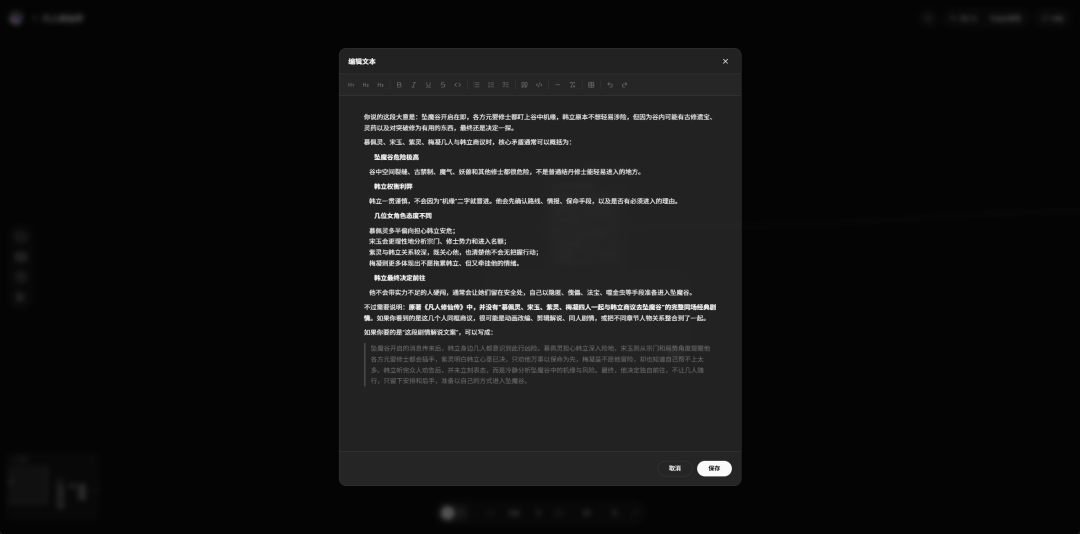
点开编辑查看内容是否有问题,如没有问题进行下一步骤:鼠标左键点一下右侧 “+” 节点拖出 Agent 技能,添加“告别廉价感SD2.0优化提示词”。
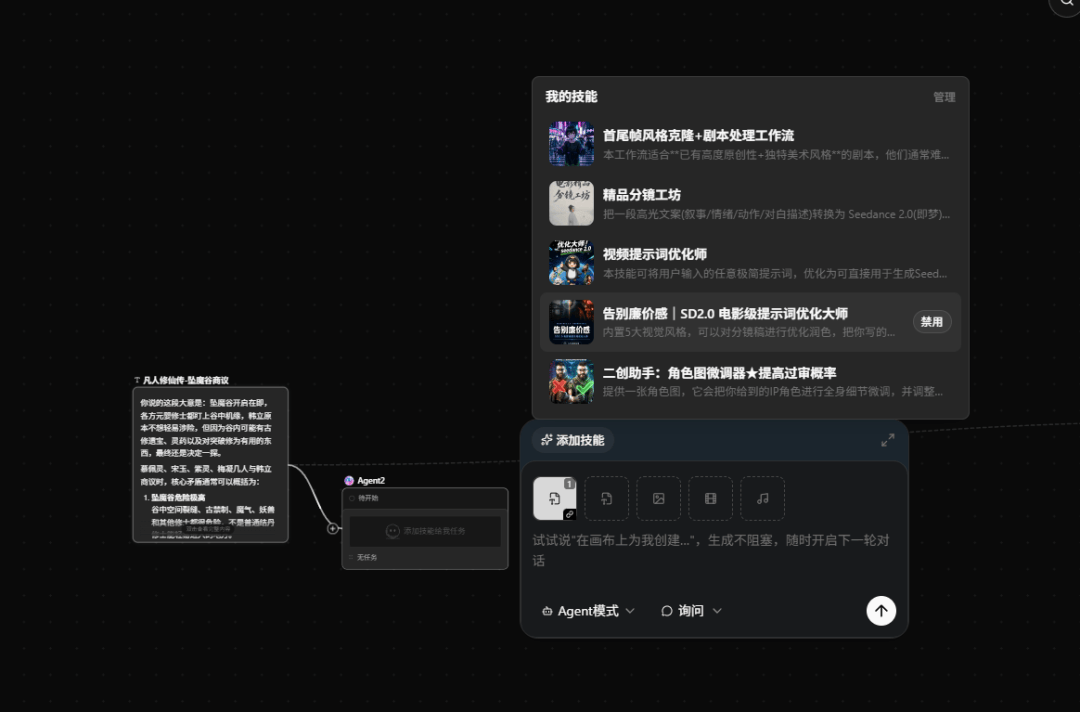
输入提示:根据文本内容,和上传的 [参考图1] [参考图2] [参考图3] [参考图4] [参考图5] 和这几个关键人物角色进行内容设计。
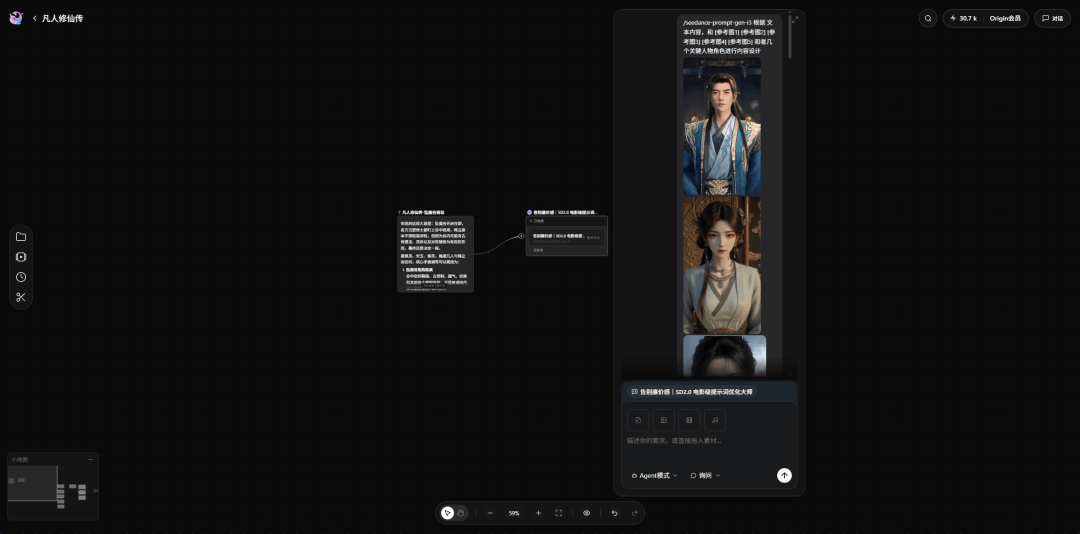
注意:这里是可以上传图像的,目的是为了让 Agent 区分角色并赋予内容,如果你自己有内容可直接输入内容进行赋予角色图像。
-
Agent 会让你选择方向,选择好后输出内容,在你没有内容的时候这是个非常不错的参考以及实现方向。
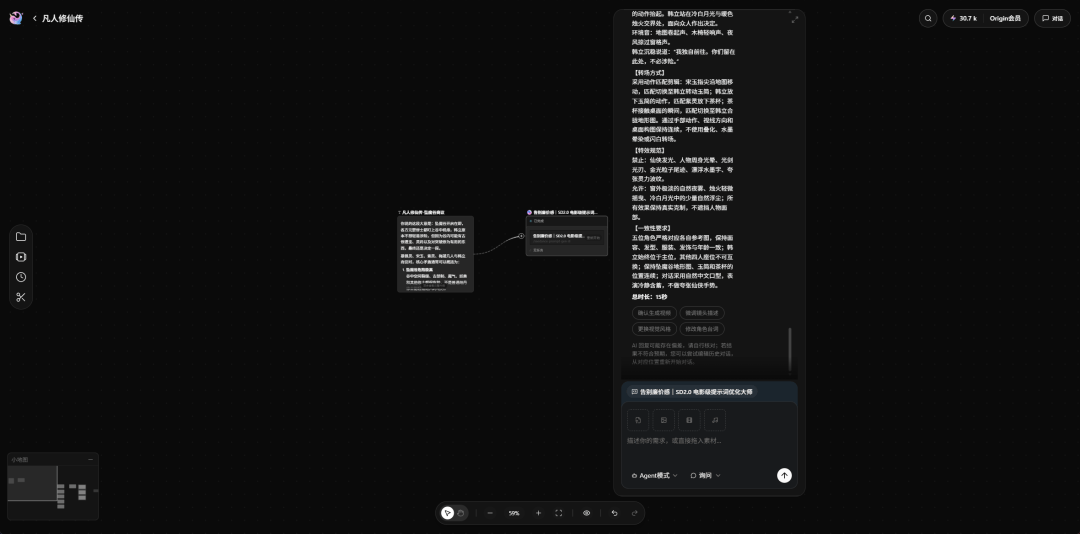
方向有了继续下一个步骤生成角色和场景,切记在这个步骤不要直接生成视频,因为需要强控制角色的站位,就需要预演台,预演台的前提是需要有三张场景图像。
-
· 上传图像「注意版权问题或者自己生成,因为凡人修仙传哔哩哔哩有版权,这里我直接找一些图像」进行二次加工。
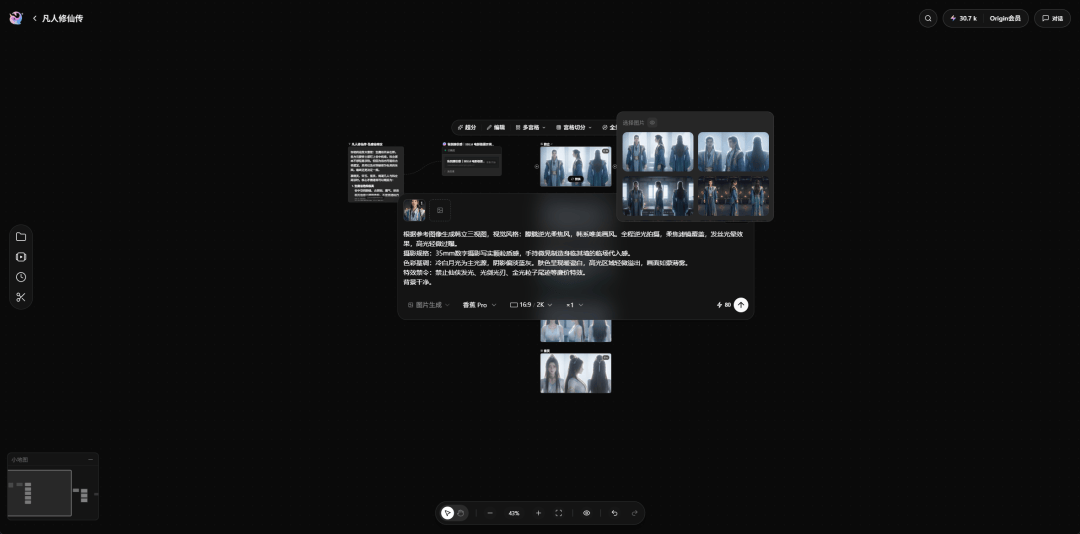
提示词来自刚才 Agent 梳理出的,找到相应的风格方向复制到里面就可以了,并在开头加一句“根据参考图像生成 XX 三视图” 。
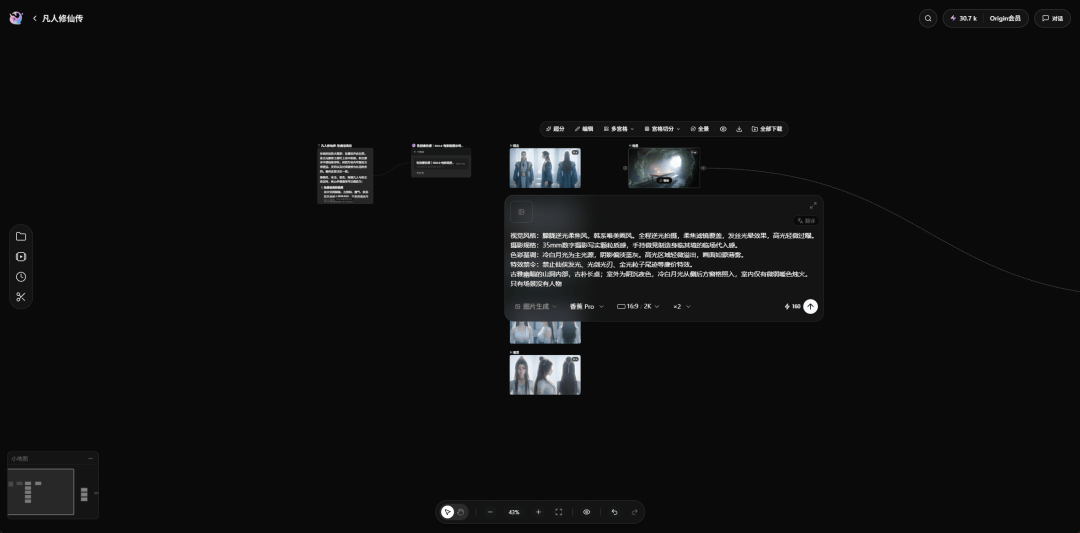
继续生成场景,再拖出 Agent 技能,这次不添加直接对话:根据参考图像请生成一致且广角、鸟瞰图、全景图 3 张图像。
-
· 生成好 3 张图像,在画布拖出 “新建预演台” 根据场景图像生成空间即可,我们现在添加角色白模,方便后续操作。
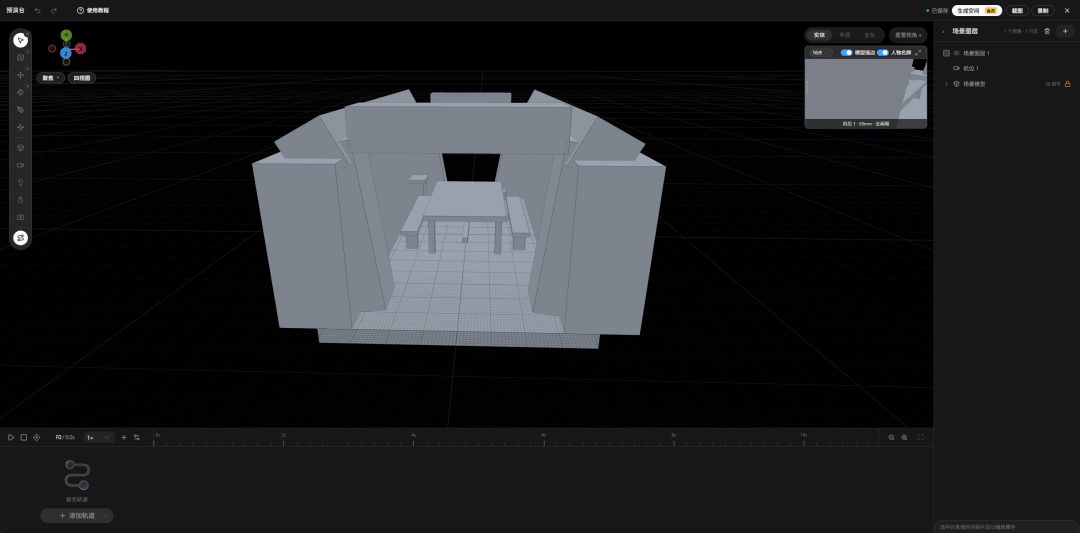
这里我标注了使用的角色,发现几个问题,当场景和人物角色比例不协调,调整人物角色身高来规避掉场景不协调更为的高效!
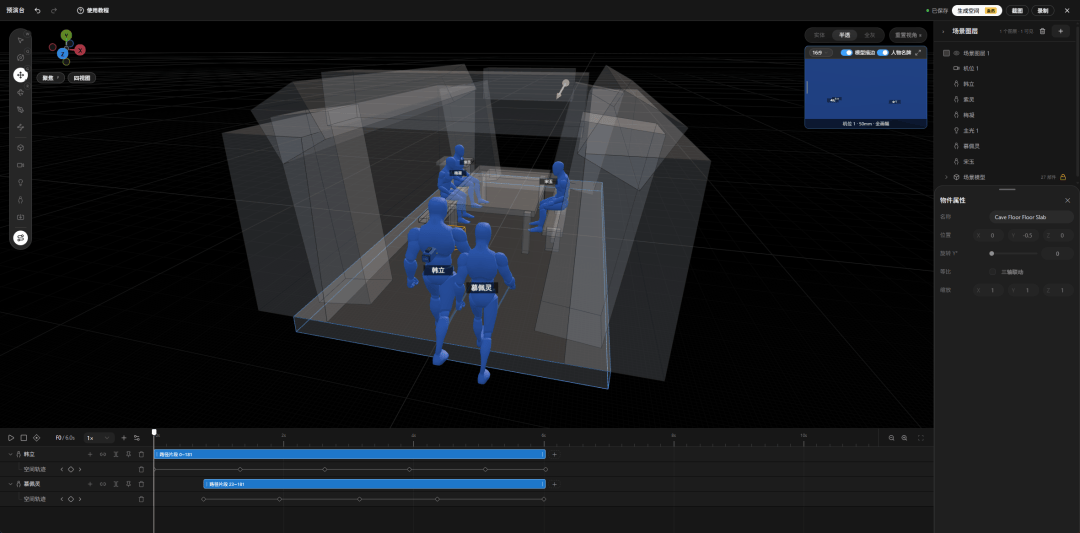
同时需要注意下方规定的时间长短,你可以调整时间轴长短,多角色参考最好命名以免混淆自己判断。并且在从韩立进屋这里摄像机有轻微向上滑动,对于想控制镜头的创作者也是非常的受用。
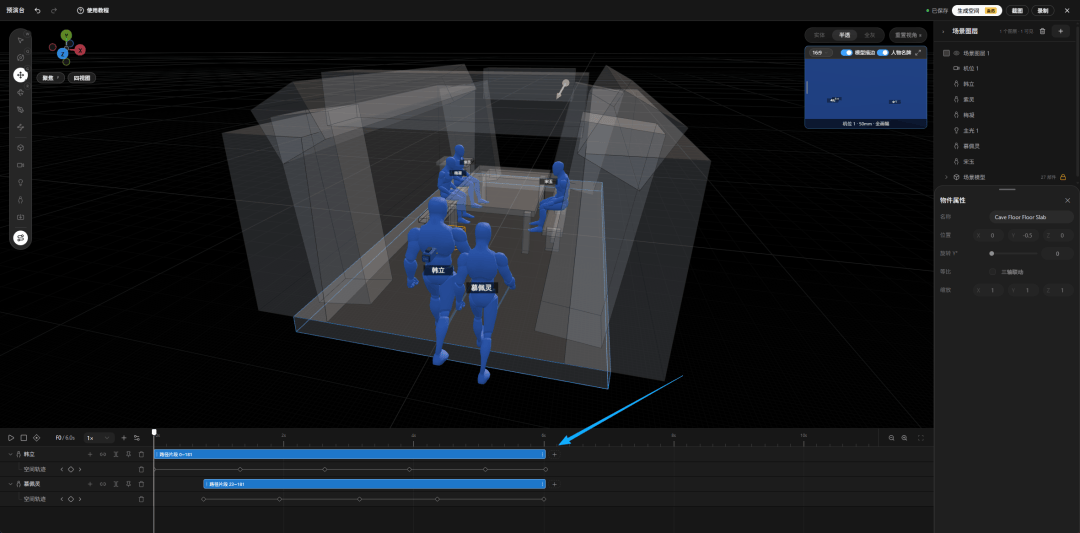
检查无误后如不需要优化就可以点击右上角进行录制。回到画布,拖出视频节点,把用的角色和白模链接上,提示词来自 Agent ,复制调整后即可生成视频了。
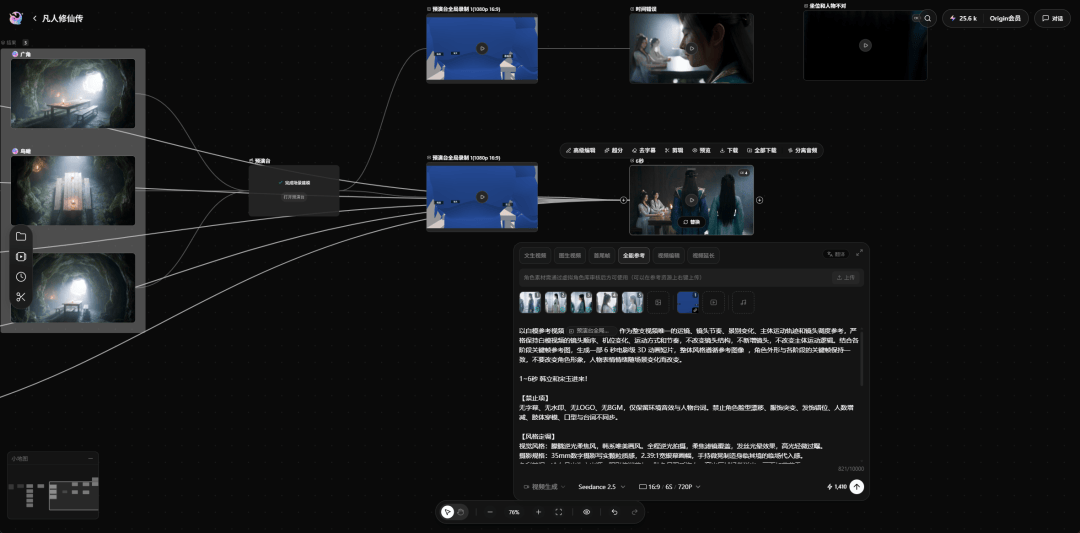
在点击生成的那一刻,系统会自动审核该角色是否侵权,只要没通过的就需要调整,但显然作为老牌的哔哩哔哩只要符合平台规则就没有问题~
-
· 补充知识点:在上面案例 1 里用了钢笔功能做了运动轨迹,这里摄像机延展,轨迹跟拍 的方法可改变镜头语言,下方是操作录制的视频。
思路:预演台左侧栏增加机位,在左下方点击 “+” 添加机位2 并选择 “绘制轨迹”,用钢笔工具进行绘制路径关键帧,即可实现轨迹跟拍。
机位2的效果可控,但是看到角色有变动,也不是不可以,反而韩立和宋玉进来更符合故事,也不失为另一种选择,这里只作为测试使用。
-
经过以上使用和测试,像这种复杂的人物以及空间场景,非常适合预演台。并且目前该功能完全免费的,
3.中华万年史-连续衔接
看过《凡人修仙传》的小伙伴对于韩立结婴157集经历心魔劫难有一段视觉手法描述,韩立一路走来的场景切换,人始终未变。我把这个想法运用到中华历史的变迁是不是很有意思。
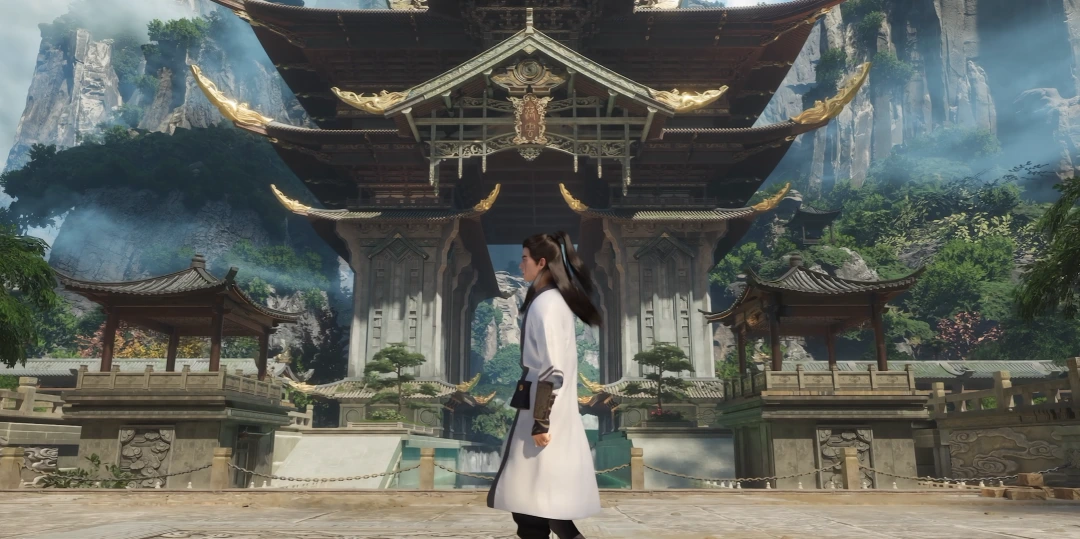
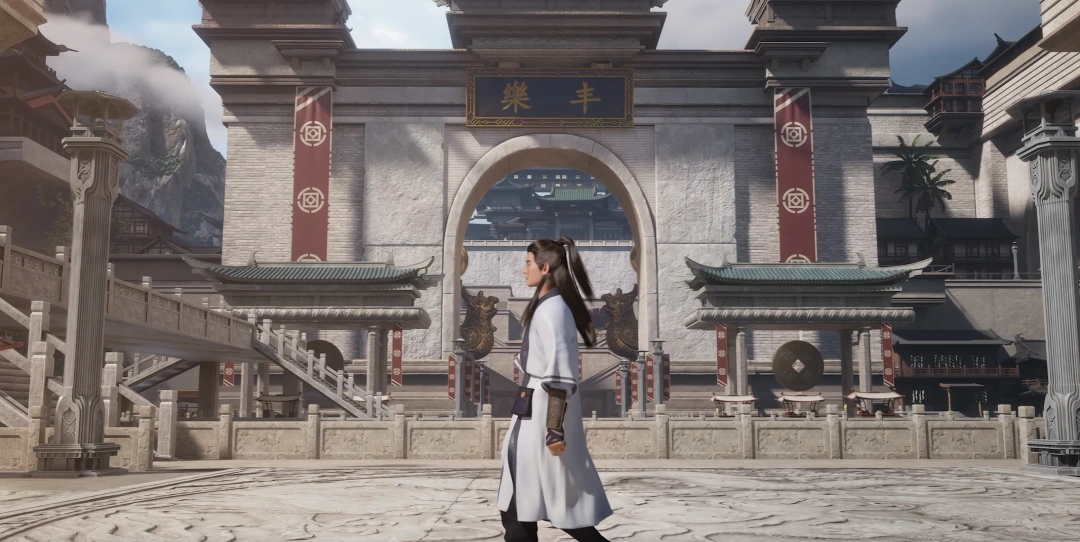
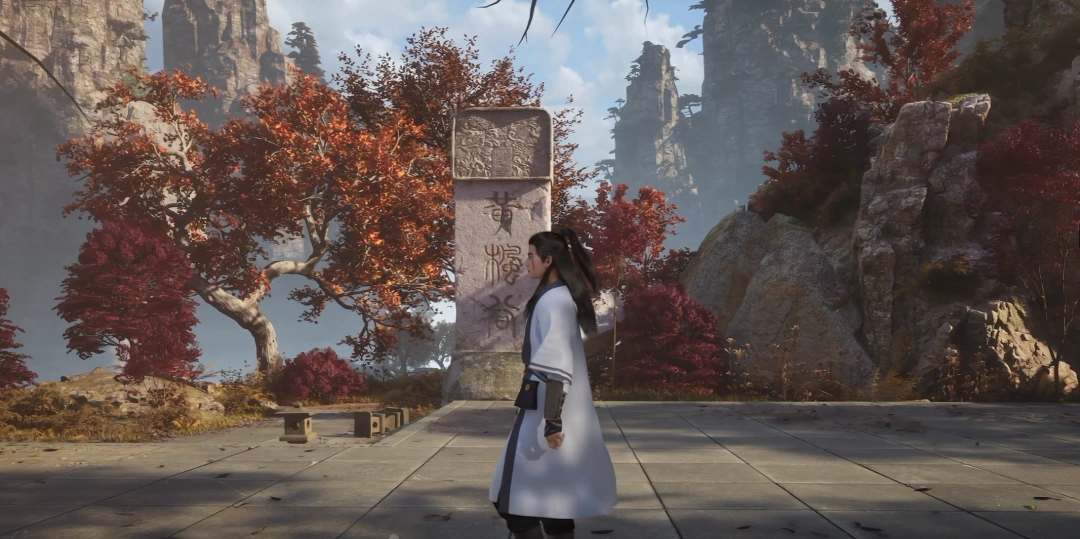
先简单分析一下思路:只有场景变换,人物始终在镜头前方并且是视觉中心,把想法随便扔给一个 Agent ,让它给出大概的内容,再用生成的内容放在 updream 文本节点里给出相应的提示,生成相应的图像,大概30秒左右的视频,3秒一个画面共10张,有问题的图像可用 预演台 修改优化,再生成视频即可。
-
· 新建画布拖出文本节点,附上准备好的内容。
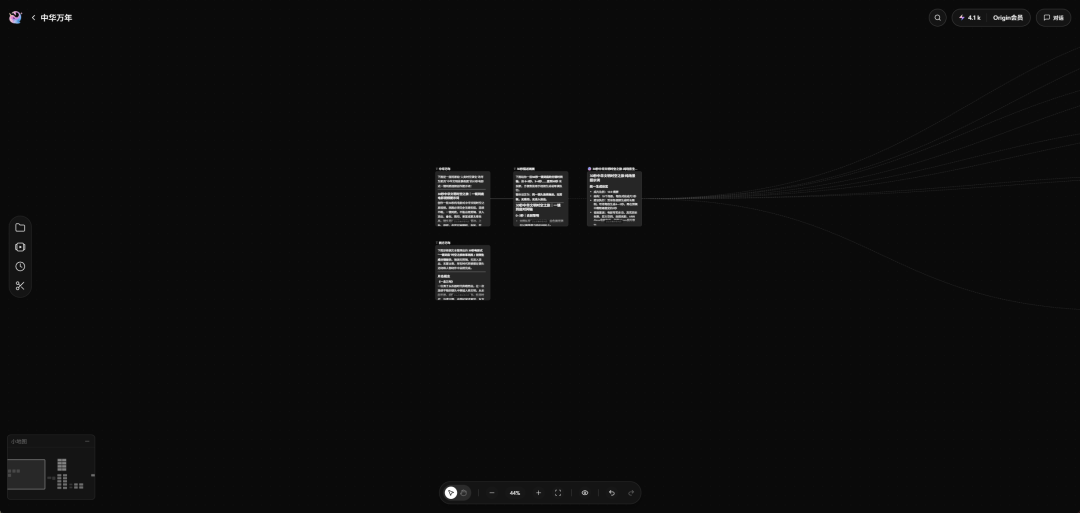
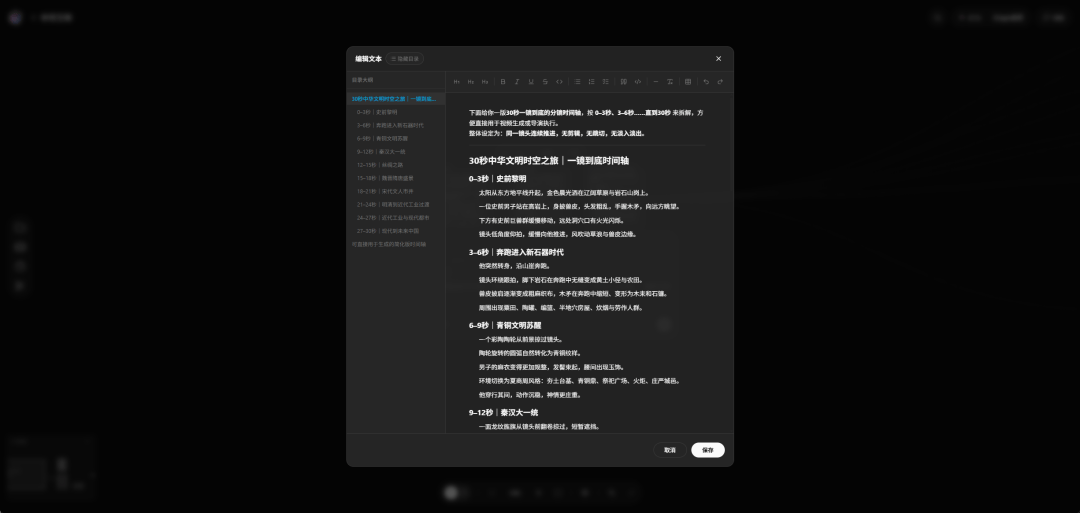
我这里简单的总结一下提示,要不文字内容巨长:电影写实史诗,同一位端庄青年中国女性始终稳定在画面正中央,从左向右匀速缓步,摄影机等速平行侧跟,背景持续向左退去。0-3秒史前草原与洞穴,植物纤维衣和皮披肩;3-6秒新石器聚落,麻布交领衣裙;6-9秒青铜城邑,深青直身衣;9-12秒秦汉驰道,赭红玄黑曲裾;12-15秒丝绸之路,沙褐行旅袍与暗红披帛;15-18秒盛唐长安,朱红襦裙和金色披帛;18-21秒宋代江南,月白褙子与灰青百迭裙;21-24秒明制袄裙经蒸汽遮挡变为近代立领女装;24-27秒民国旗袍经灯带遮挡变为现代墨青风衣;27-30秒未来生态城市,青白东方结构长衣,末1秒镜头升高拉远。所有换装只在岩石、陶罐、旌旗、沙尘、竹简、丝带、桥洞、蒸汽、光屏完全遮身时发生;人物面容、年龄、身高、体型、发色与步频始终一致。ARRI Alexa自然电影色,青绿阴影、金色高光、10%-15%胶片颗粒,无对白。
-
· 还需要优化提示,拖出 Agent 节点,选择 “精品分镜工具” 技能进行优化,你只要一顿咔咔问就行了,然后在选择对你画面有用的输出即可。
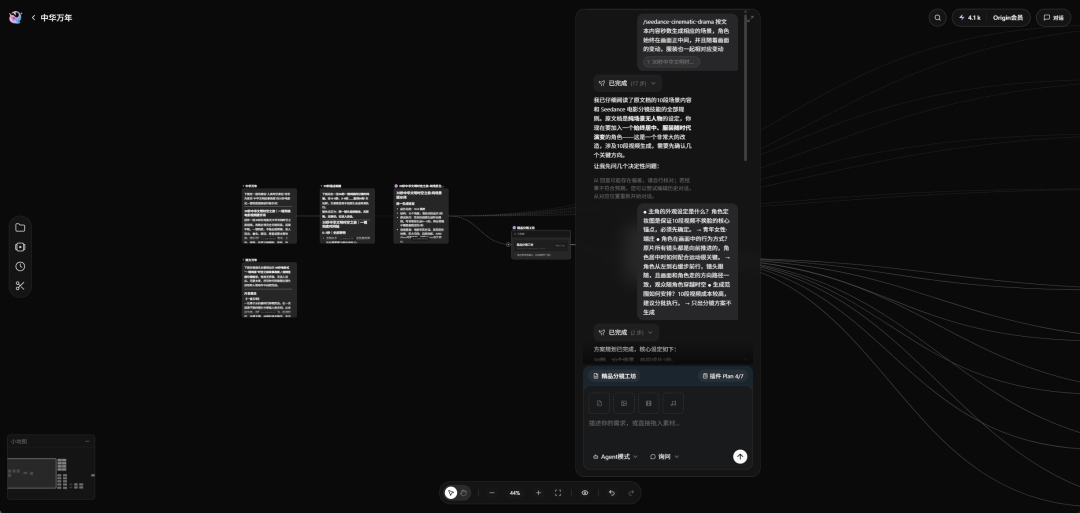
我这里输入:按文本内容秒数生成相应的场景,角色始终在画面正中间,并且随着画面的变动,服装也一起相对应变动。这样就得到一个更精细的内容本版。
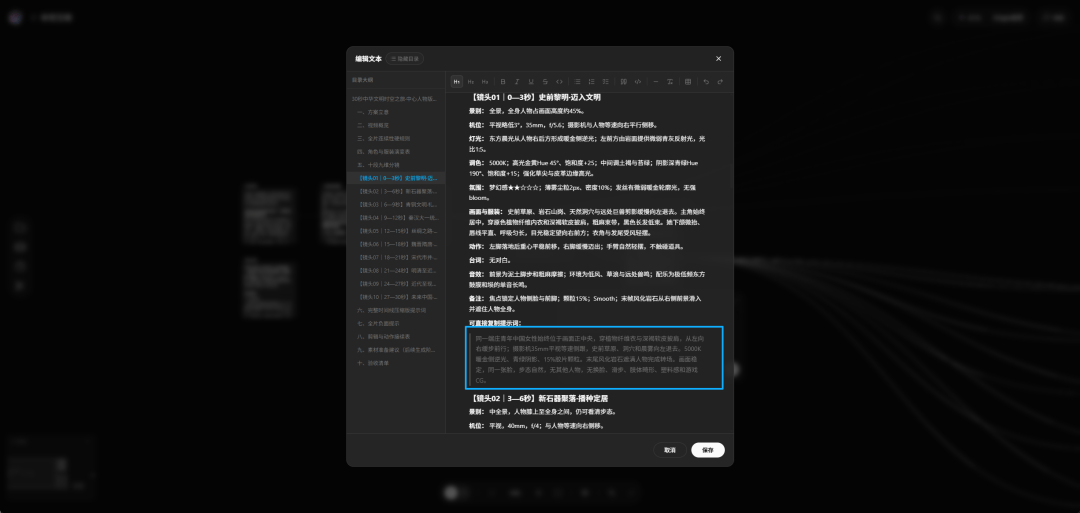
篮框里的文字是图像生成提示,尝试直接生成图像不好控制,所以单独复制出来,拖出图像节点进行生成。
注意:上面的这个步骤非常的重要,会省去你大量的生图时间以及积分,要问我为什么这么清楚,肯定是我掉过坑里...
-
· 生成图像需要注意:当第 1 张符合你要求后,在生成下一张图像的时候,需要把节点拖到下一个生成图像节点里作为保持角色人物的一致性。
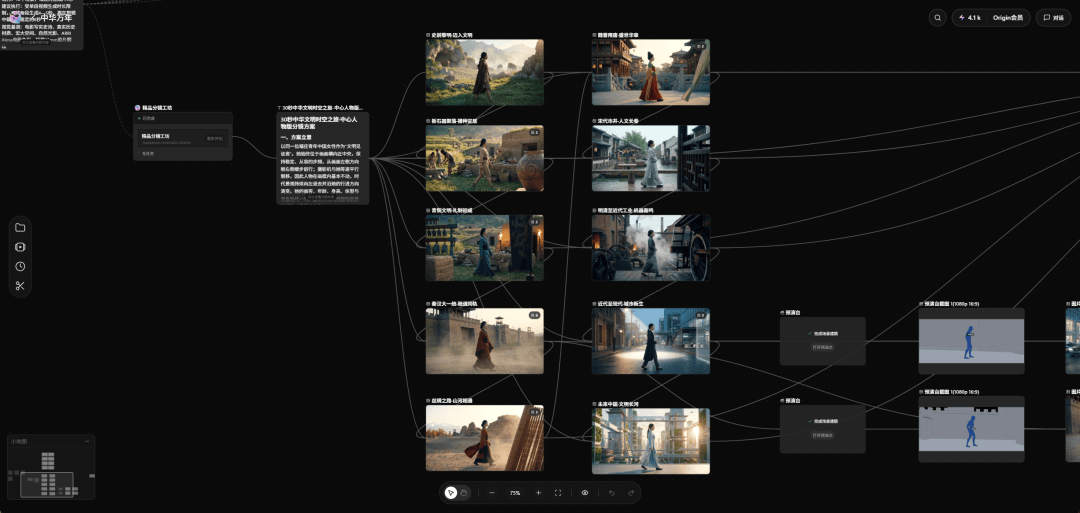
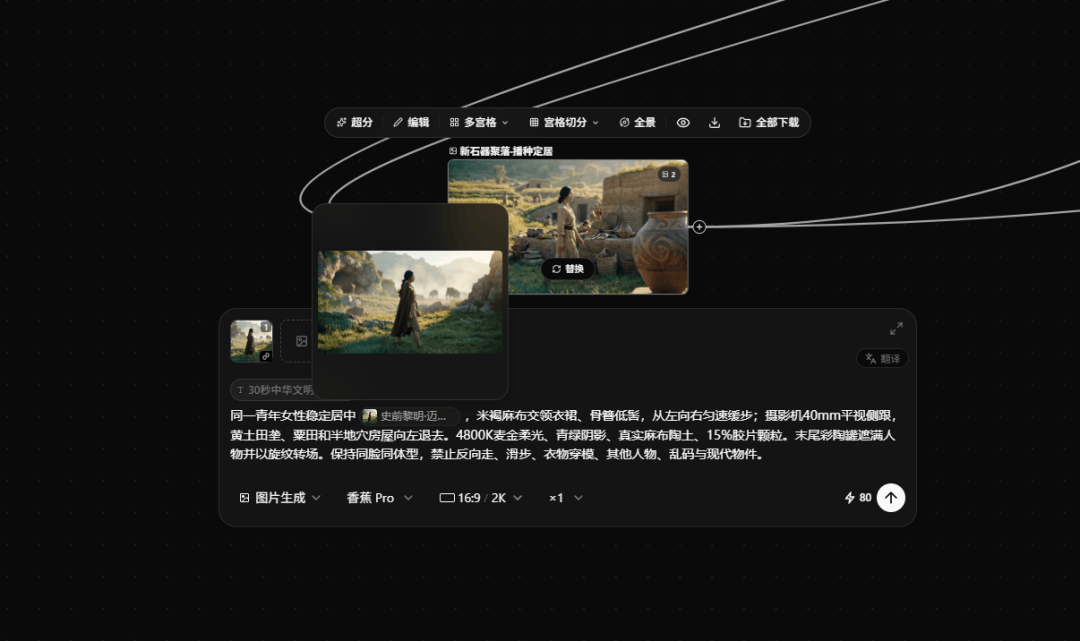
可以看到上一个图像链接到第二张图像里,你需要用 “@” 字符来选择上一张关联图像。
-
· 生成好后需要检查一下场景是否符合人物的走向,也就是人物需要从左侧到右侧走动场景匹不匹配,如果没有匹配进行 “新建预演台”,进行调整场景与人物关系。
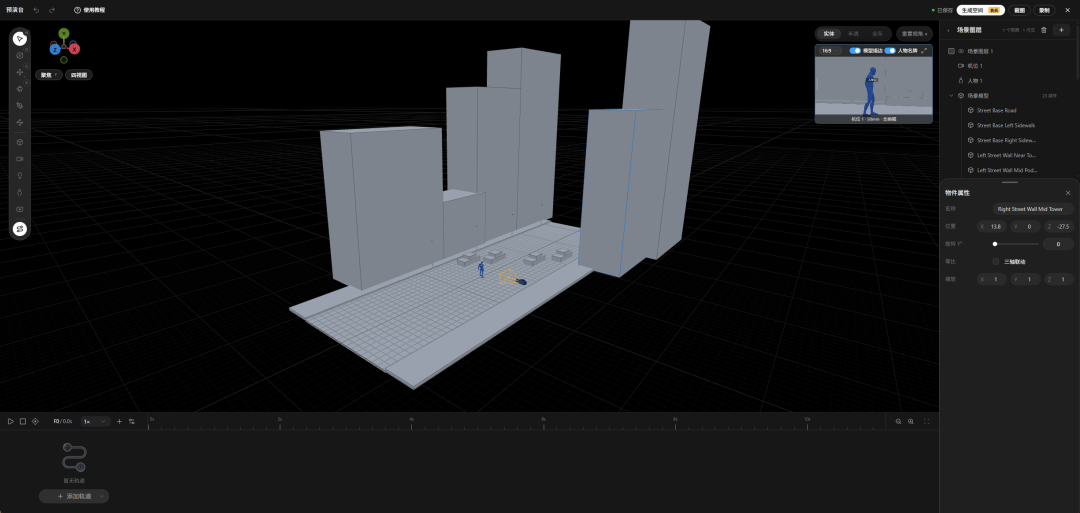
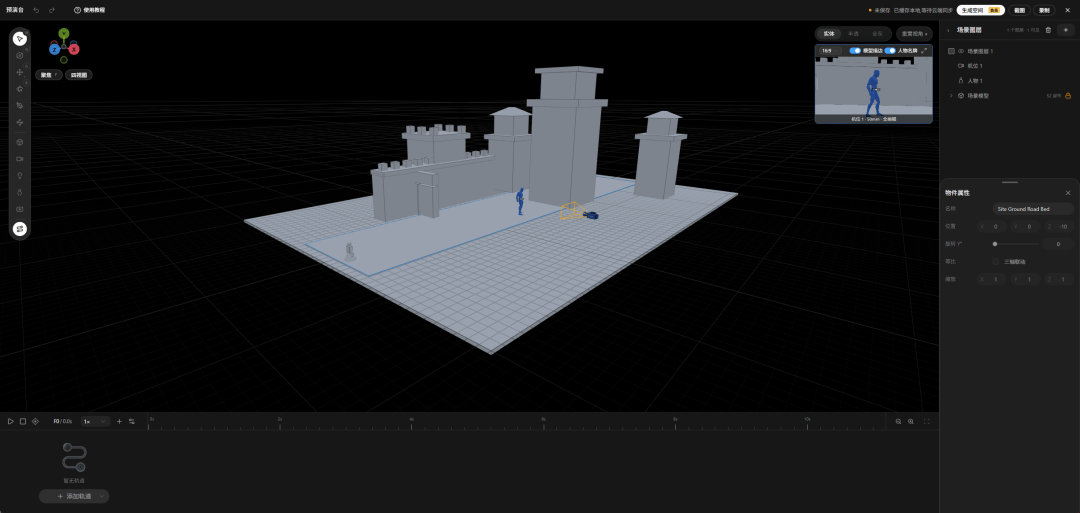
小知识:在简单场景下,也不是不可以用一张图像生成白模,右侧图层里可以进行删减遮挡物,要问什么原因,因为我就是这样操作的,快捷且有效,但我不保证生成出来的图像正确。
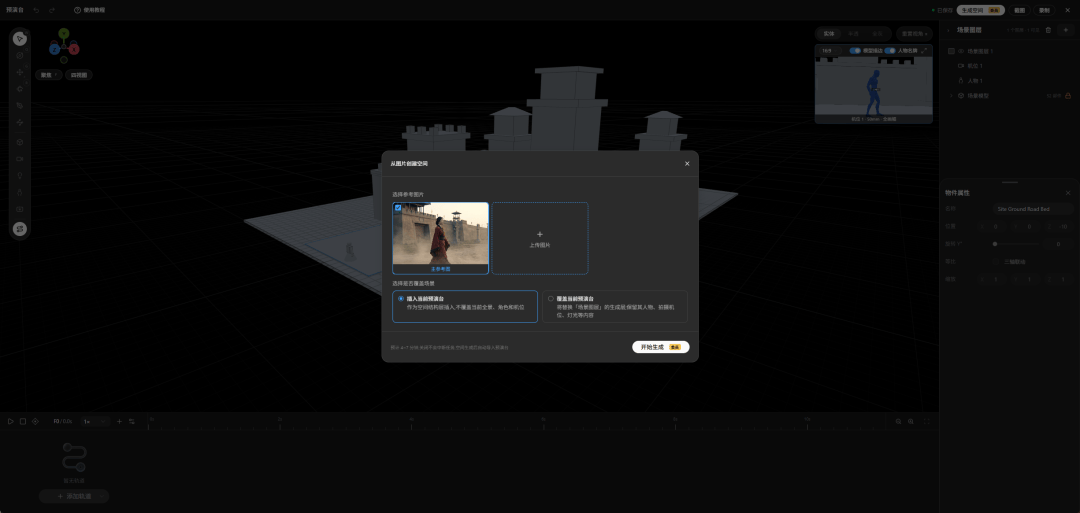
和前两个案例不同,因为这里没有用到摄像头关键帧移动,在确认后点击右上角“截图”,图像会出现在画布上使用即可。
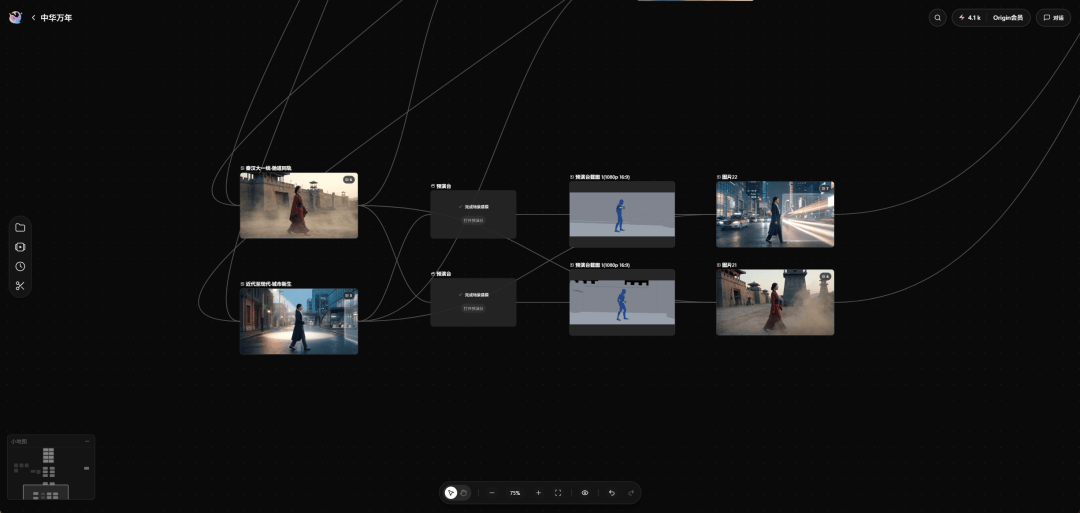
完成以上我们生成视频。
-
· 把之前 Agent 技能里精细化后的提示复制到视频节点里,细心复制与调整,慢工出细活。把每个节点里的场景都标注准确。设置时间 30秒、视频模型 Seedance 2.5 、720P、点击生成。
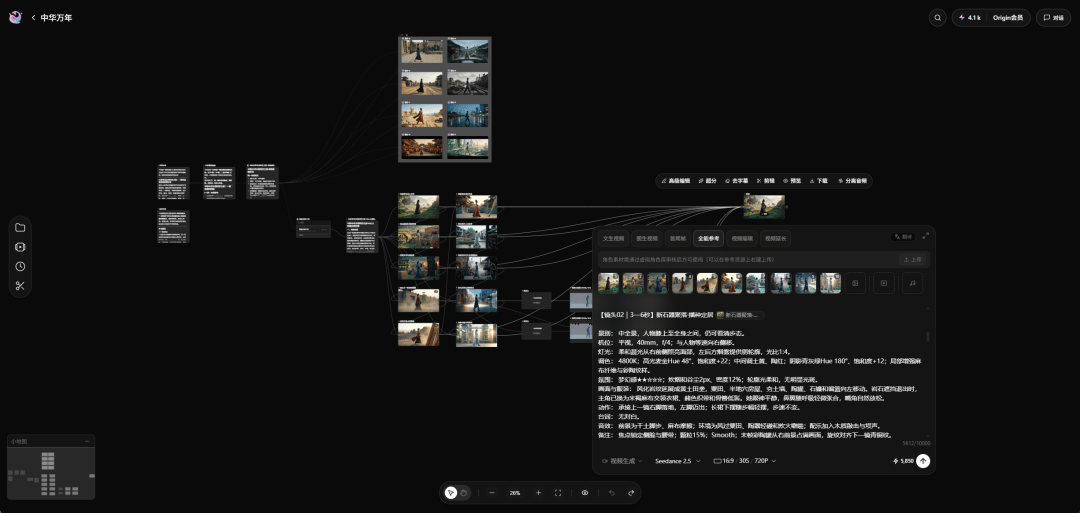
结尾
对我来说预演台的功能更新是强控制、降低抽卡次数的神奇小工具,配合 Seedance 2.5 非常的般配, 只要上传或者生成场景参考图像,就能快速的生成高还原度的白模场景,用白模代替文字的缺点,也是一种很新的趋势,面向专业的创作者用这个功能会拉开普通视频生成者的差距。当然我们先学到手,去运用这个功能的话,提升自己的行业竞争力,非常推荐大家去使用!!
标签

评论 0
最新评论登录后发布评论并参与互动。
暂无评论,欢迎抢沙发。